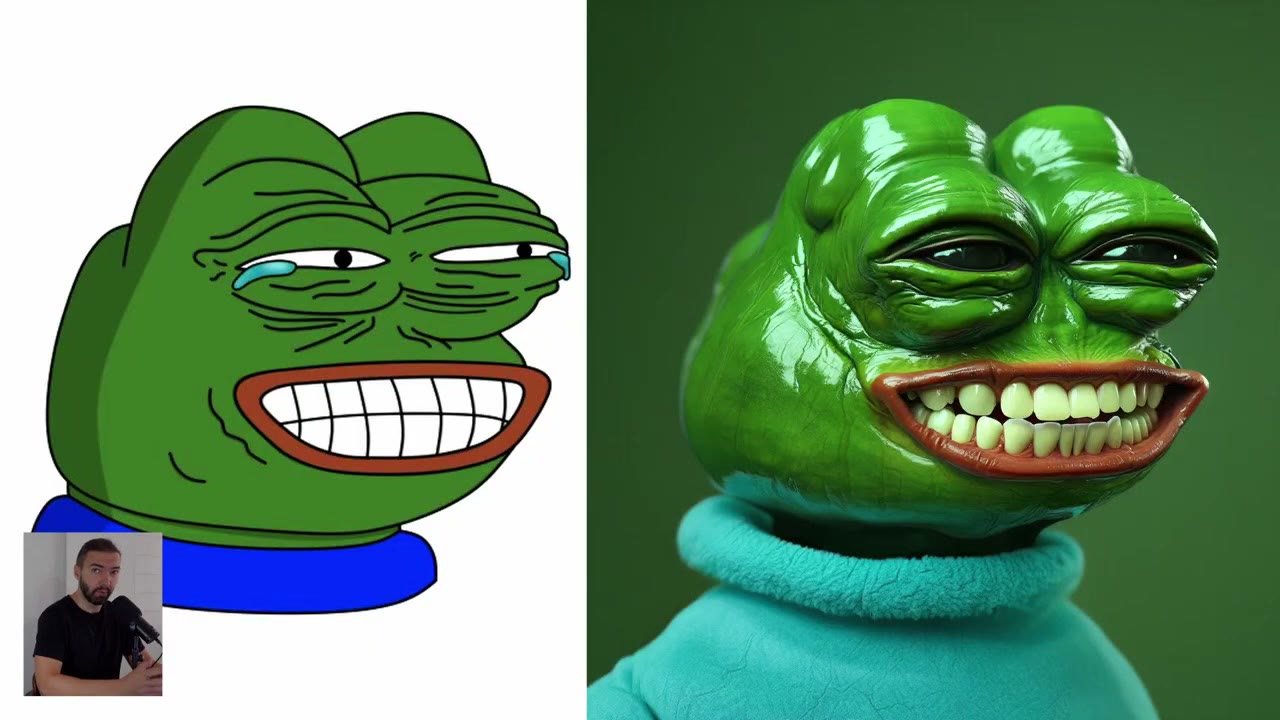
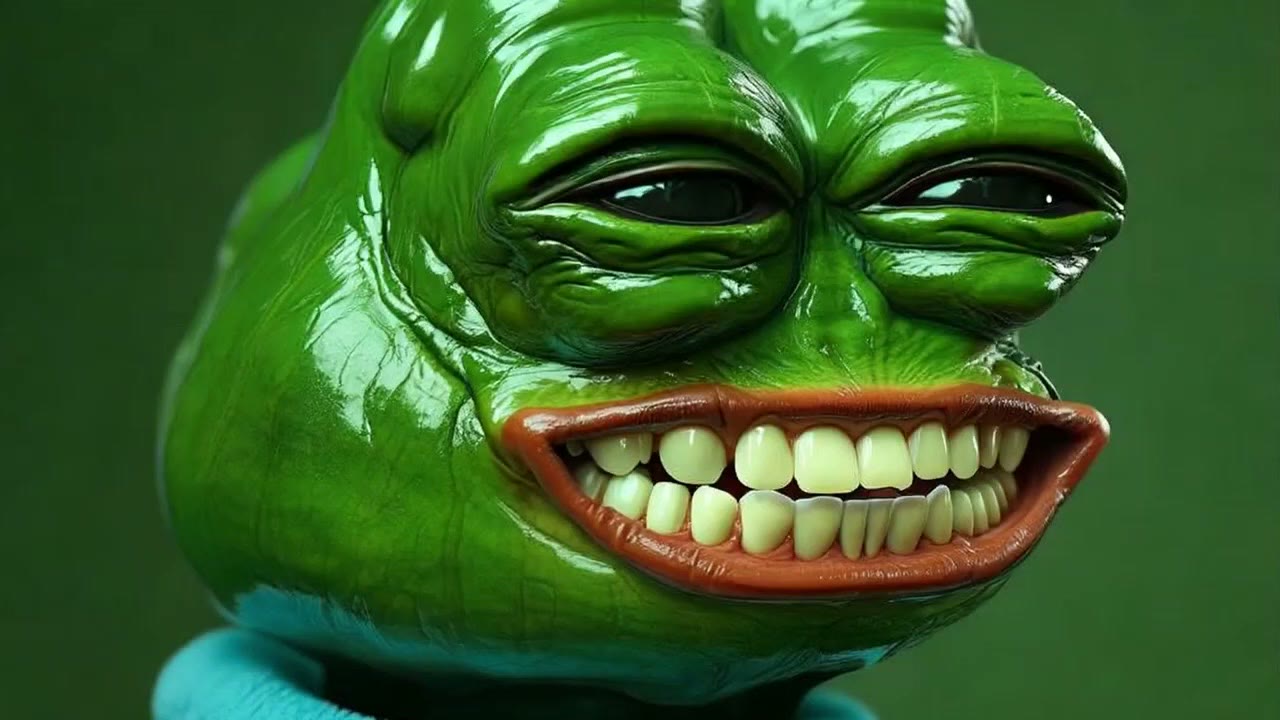
Un dibujo plano no tiene profundidad, ni piel, ni luz. Flux puede añadir las tres cosas, si le das la forma y describes el resto con suficiente detalle. Esta guía convierte a Pepe la rana en un Pepe «real», fotorrealista y espeluznante. Todo el mérito de Pepe es de su creador, Matt Furie.
Funciona en local en ComfyUI con Flux dev, y necesita una máquina potente: al menos 16 GB de VRAM, diría yo. Yo tengo 24 GB. Si tú no, el flujo también funciona en la nube (mira el final).
En resumen
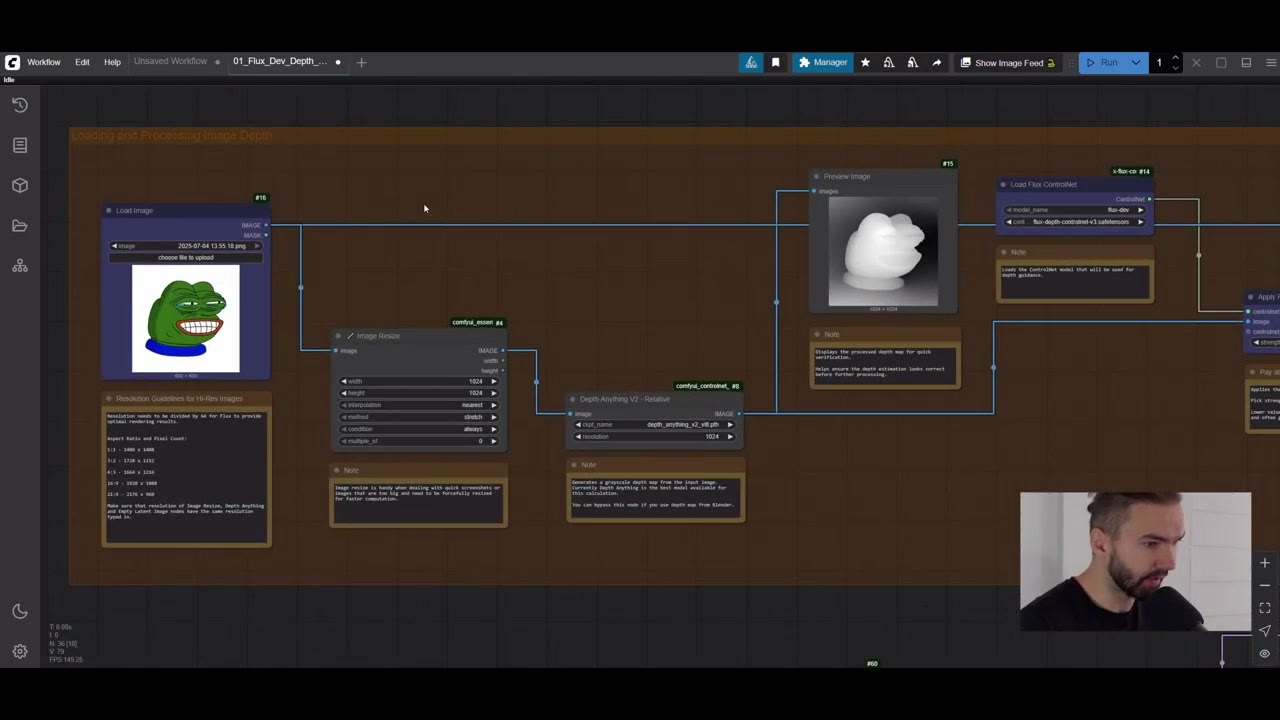
- Forma: Depth Anything lee la profundidad incluso a partir de un dibujo plano.
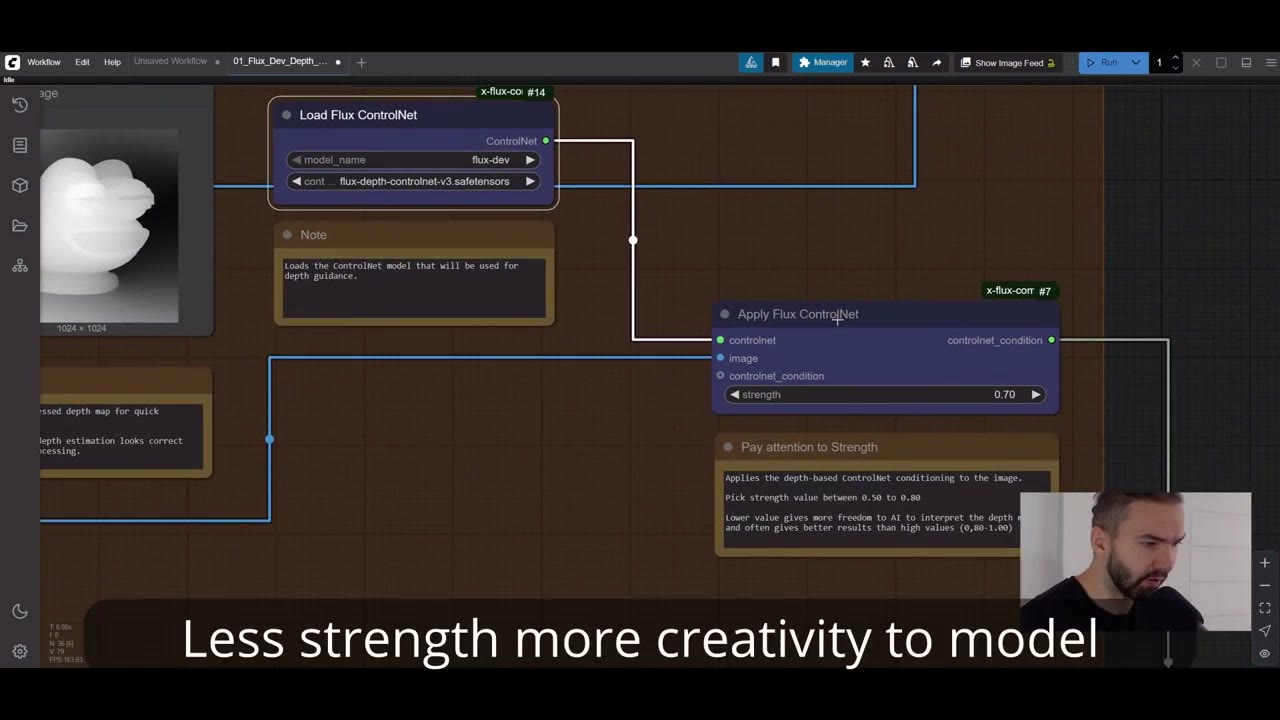
- ControlNet: ControlNet de profundidad de Flux; menos fuerza da más creatividad al modelo.
- Prompt: la descripción del boceto como una foto escrita por ChatGPT y luego editada a mano: de ahí sale el resultado.
- Sampler: 25 steps, seed en increment.
- Animación: Seedance en fal, de 20 a 74 céntimos por cinco segundos.
El flujo
Es una red sencilla. Lo único inusual es leer la profundidad de un boceto. Necesitarás comfyui_controlnet_aux, rgthree, x-flux-comfyui, ComfyUI Essentials y ComfyUI-GGUF desde el Manager.
1. Profundidad a partir del dibujo
Carga la imagen (la mía era cuadrada) y redimensiónala a 1024 píxeles. Depth Anything extrae entonces un mapa de profundidad, incluso de un boceto plano: los valores blancos están cerca de ti y los negros lejos. Eso es lo que ayuda a Flux a entender el dibujo como una forma 3D. (El propio ajuste de resolución de Depth Anything ya redimensiona a 1024, así que puedes saltarte el nodo de cambio de tamaño aparte.)
2. El ControlNet
Load Flux ControlNet carga un ControlNet de profundidad de Flux capaz de interpretar la imagen de profundidad, y Apply Flux ControlNet lo combina con el mapa de profundidad. El resultado alimenta la entrada de ControlNet del XLabs Sampler. Strength controla con qué rigor se sigue la profundidad: menos fuerza da más creatividad al modelo.
3. Modelo y lienzo
Flux dev va a la entrada de modelo del sampler. El Empty Latent Image debe coincidir con el tamaño de tu imagen de profundidad: aquí 1024 × 1024. El formato horizontal también sirve; solo cambia el tamaño en todas partes. Las notas del flujo enumeran buenas resoluciones.
4. El prompt: de donde sale de verdad el resultado
El DualCLIPLoader carga los dos codificadores de texto de Flux (T5 XXL y CLIP-L, ambos en el Model Manager). El prompt negativo se queda vacío; Flux no usa uno como lo hace SDXL.
Para el prompt positivo, le di el boceto de Pepe a ChatGPT y le pedí un prompt que describiera una imagen fotorrealista de él. Luego lo edité. La cabeza abultada no salía bien, y era demasiado lisa, así que añadí arrugas por todas partes. Eso marcó una gran diferencia.
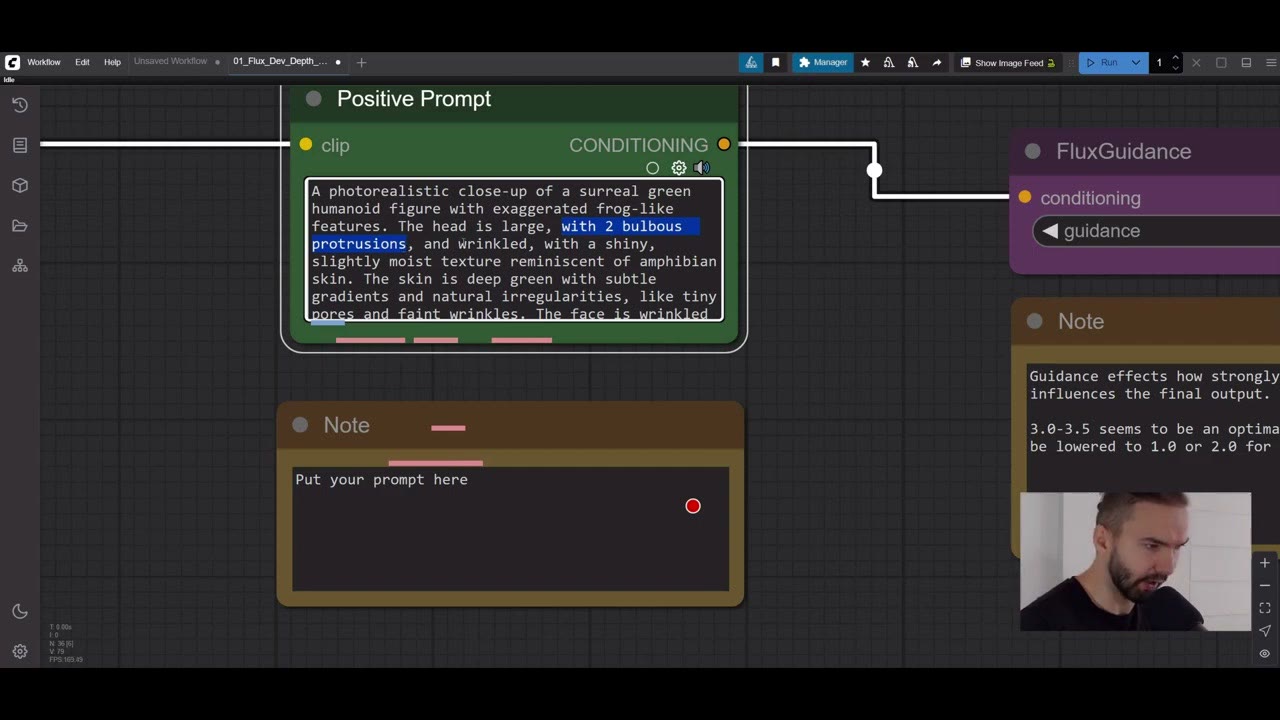
Este es el prompt completo (puede ser más corto):
A photorealistic close-up of a surreal green humanoid figure with exaggerated frog-like features. The head is large, bulbous, wrinkly with a shiny, slightly moist texture reminiscent of amphibian skin. The skin is deep green with subtle gradients and natural irregularities, like tiny pores and faint wrinkles. The face shows an awkward forced grin, exposing perfectly aligned, unnaturally bright white teeth. The mouth is wide with pronounced reddish-brown lips that contrast with the green skin. The figure's eyes are narrow and squinting in the middle of the face, with small black pupils looking slightly to the side, very wrinkly on sides. At the corners of the eyes are glistening tear streaks, as if the character is crying while smiling. The tears reflect ambient light, adding to the surreal emotional contrast. The neck is thick, and the figure wears a plain, bright blue fabric collar that appears slightly soft and textured, like fleece or cotton. The lighting is studio-like with soft shadows, emphasizing the glossy, slimy surface of the skin and the moisture of the tears. No nostrils.Fíjate en cuánto de él describe materiales y luz: piel húmeda, poros, lágrimas brillantes, forro polar, sombras de estudio. Eso es lo que convierte un dibujo en una foto. Ambos prompts pasan por Flux Guidance hasta el condicionamiento del sampler.
5. Muestrea, decodifica, guarda
- Steps: 25, para tener algo más de calidad. Dejo los demás ajustes como están; funcionan.
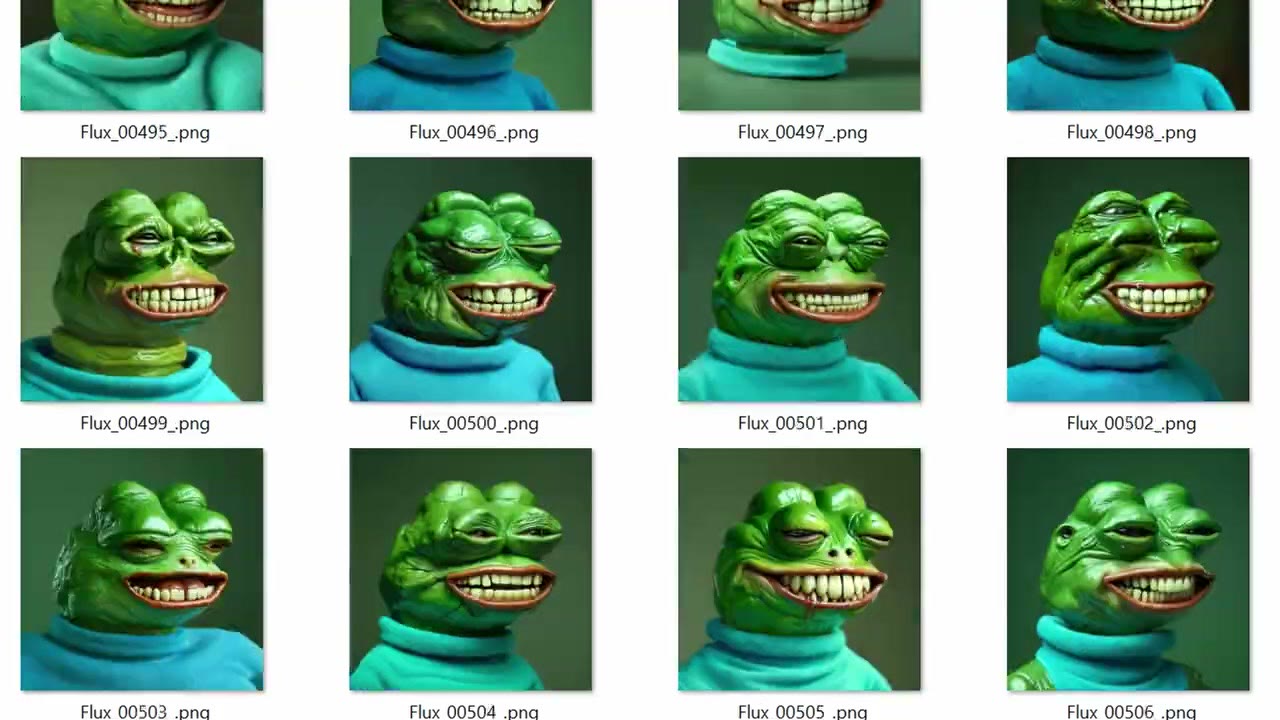
- Seed en increment. A lo largo de unas semanas hice unas 2000 imágenes, y cada nueva es simplemente el siguiente número, lo que facilita seguir las ejecuciones nocturnas.
VAE Decode devuelve el resultado a píxeles. El sampler trabaja en el espacio latente, una versión comprimida de la imagen ocho veces más pequeña, así que hay que decodificarla. Un nodo de comparación muestra el antes y el después, y la imagen se guarda con el prefijo «flux».
Anímalo con Seedance en fal
Para que se mueva, usé fal y el modelo de imagen a vídeo Seedance de ByteDance (busca «Seedance» y elige image to video). Sube la imagen y escribe un prompt de movimiento. Copié mi prompt de Flux y añadí al principio que entrecerrara los ojos; esfuerzo mínimo, y funcionó bien. Al final queda realmente espeluznante.
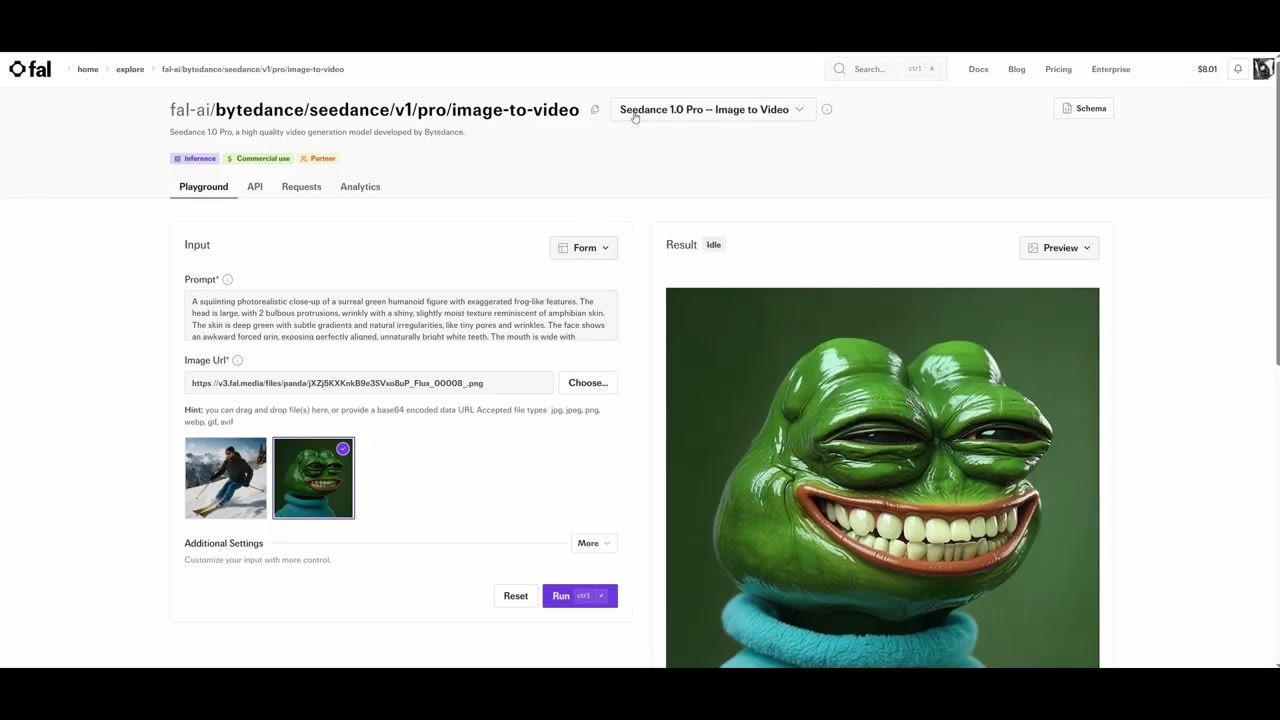
Coste: Seedance Lite cuesta unos 20 céntimos por cinco segundos, lo cual es barato se mire como se mire. Usé Pro para tener mejor calidad en YouTube, a 74 céntimos.
También puedes animarlo en local en ComfyUI, pero necesita muchísimo más cómputo y puede tardar una o dos horas. Para una animación rápida de un meme, esta fue la vía fácil.
¿Sin GPU de 16 GB?
El mismo flujo está preparado en RunComfy, así que puedes ejecutarlo en el navegador. Hoy en día uso RunPod para este tipo de trabajo; mi introducción a RunPod muestra cómo. Para ver paso a paso la misma configuración de profundidad con cualquier boceto, mira de boceto a arte con Flux.
El enlace de RunComfy es un enlace de referido, igual que mi enlace de referido de RunPod: las cuentas nuevas de RunPod que se registran con Google reciben entre 5 y 500 $ de crédito después de su primer gasto de 10 $, y yo recibo una pequeña comisión.
Ver la versión en vídeo (7:37)
Todo lo anterior también está en el vídeo, si prefieres seguirlo en pantalla. El vídeo está en inglés.
Preguntas frecuentes
¿Cuánta VRAM necesito para este flujo de Flux?
Diría que al menos 16 GB. Yo lo ejecuté con 24 GB. Con menos, usa una GPU en la nube.
¿Cómo hago una versión fotorrealista de un dibujo animado?
Usa el mapa de profundidad del dibujo para conservar la forma y luego descríbelo como una fotografía con detalle. Hice que ChatGPT escribiera un primer prompt a partir del boceto y luego lo edité a mano, añadiendo arrugas y quitando lo que no funcionaba.
¿Cuánto cuesta animar la imagen?
En fal, la imagen a vídeo de Seedance Lite costó unos 20 céntimos por cinco segundos; la versión Pro que usé costó 74 céntimos.

Anton Tenitsky es artista 3D con más de 15 años en gráficos por ordenador, que ha trabajado con Nickelodeon, Gameloft, Marvel Rivals y muchos otros clientes. Más sobre mí