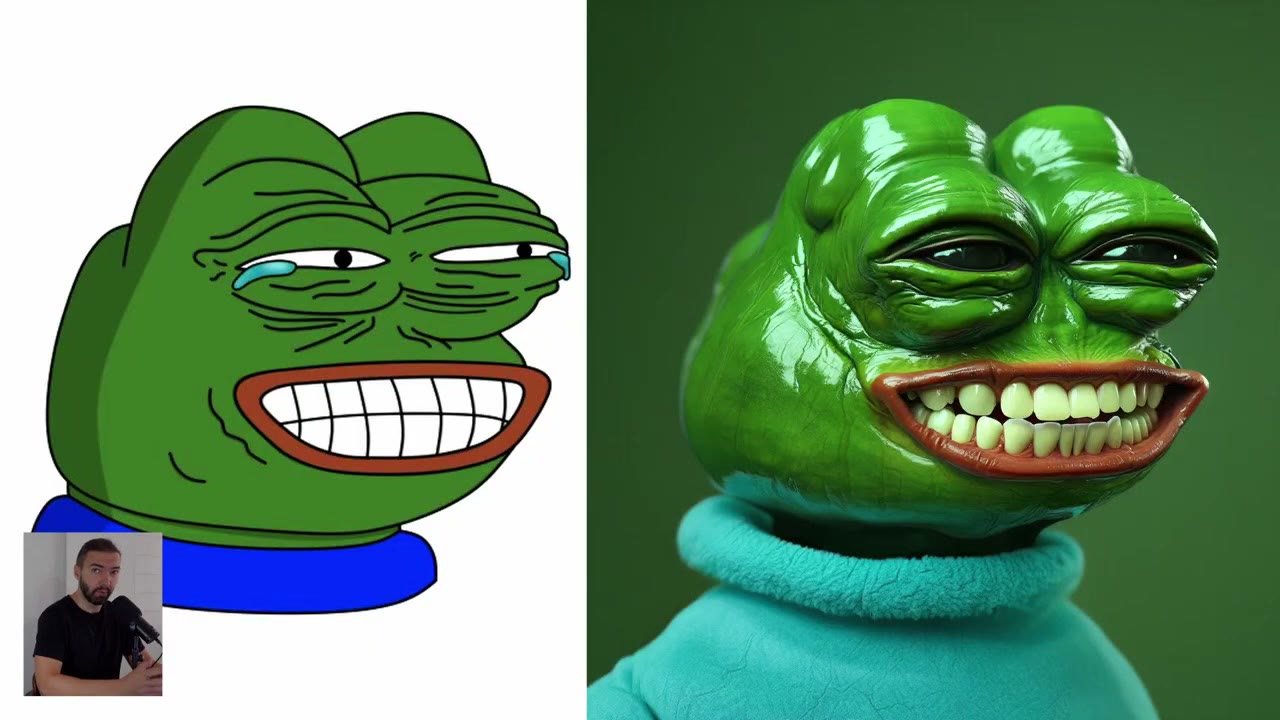
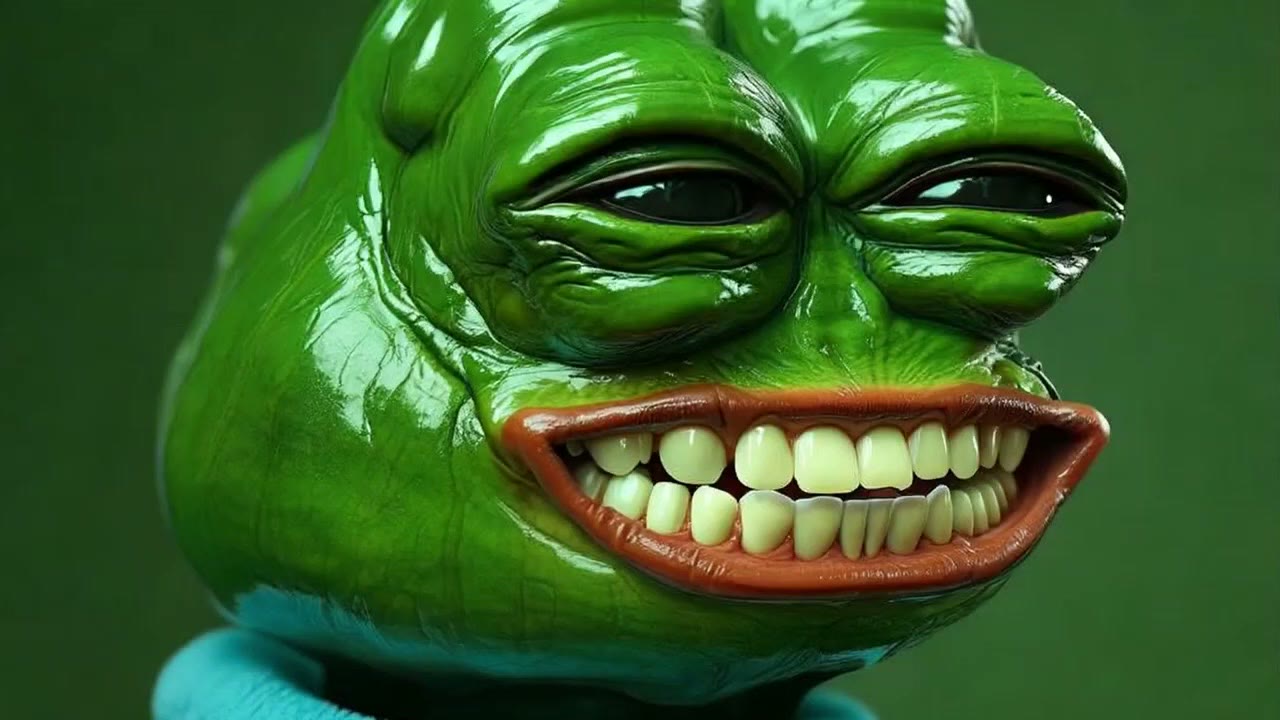
Um desenho plano não tem profundidade, nem pele, nem luz. O Flux pode acrescentar as três coisas, se você lhe der a forma e descrever o resto em detalhe suficiente. Este guia transforma o Pepe the Frog num Pepe «de verdade», arrepiante e fotorrealista. Todo o crédito pelo Pepe vai para o seu criador, Matt Furie.
Roda localmente no ComfyUI com o Flux dev e exige uma máquina parruda: pelo menos 16 GB de VRAM, eu diria. Eu tenho 24 GB. Se você não tem, o fluxo também roda na nuvem (veja o final).
Em resumo
- Forma: o Depth Anything lê profundidade até de um desenho animado plano.
- ControlNet: Flux depth ControlNet; menos força dá mais criatividade ao modelo.
- Prompt: a descrição do esboço como foto feita pelo ChatGPT, editada à mão: é daí que vem o resultado.
- Sampler: 25 steps, seed em increment.
- Animação: Seedance na fal, de 20 a 74 centavos por cinco segundos.
O fluxo
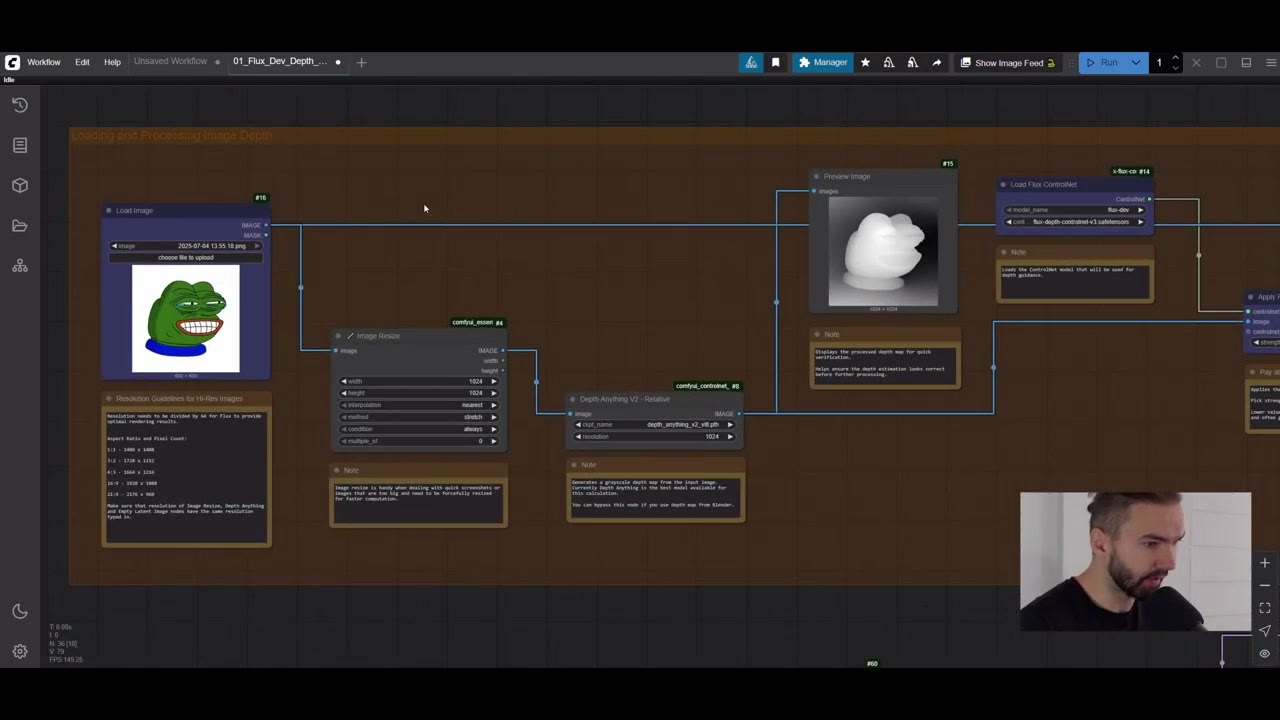
É uma rede simples. A única parte incomum é ler profundidade a partir de um esboço. Você vai precisar do comfyui_controlnet_aux, do rgthree, do x-flux-comfyui, do ComfyUI Essentials e do ComfyUI-GGUF pelo Manager.
1. Profundidade a partir do desenho
Carregue a imagem (a minha era quadrada) e redimensione para 1024 pixels. O Depth Anything então extrai um mapa de profundidade, mesmo de um esboço plano: valores brancos estão perto de você, valores pretos longe. Isso é o que ajuda o Flux a entender o desenho como uma forma 3D. (O próprio ajuste de resolução do Depth Anything já redimensiona para 1024, então você pode ignorar o nó de redimensionamento à parte.)
2. O ControlNet
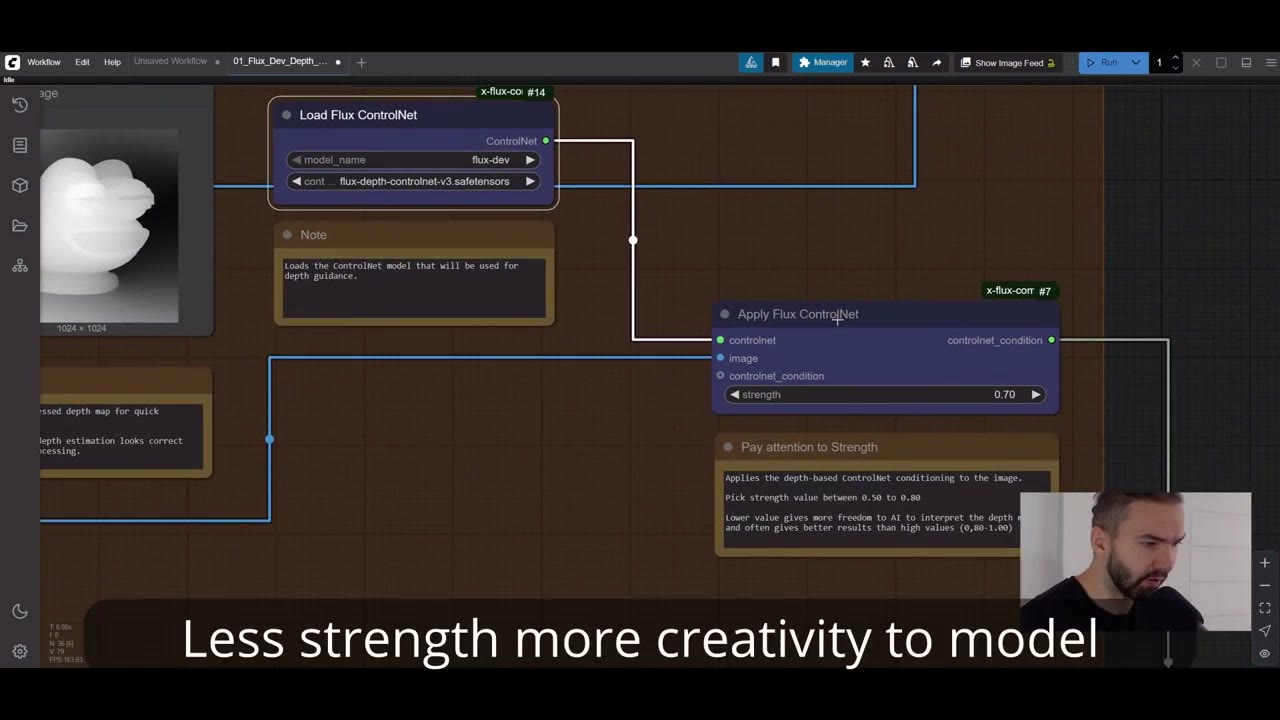
O Load Flux ControlNet carrega um ControlNet de profundidade do Flux que sabe interpretar a imagem de profundidade, e o Apply Flux ControlNet o combina com o mapa de profundidade. O resultado alimenta a entrada de ControlNet do XLabs Sampler. A strength controla com que rigor a profundidade é seguida: menos força dá mais criatividade ao modelo.
3. Modelo e tela
O Flux dev vai para a entrada de modelo do sampler. O Empty Latent Image deve combinar com o tamanho da sua imagem de profundidade: aqui, 1024 × 1024. Paisagem também funciona; é só mudar o tamanho em todo lugar. Notas no fluxo listam boas resoluções.
4. O prompt: de onde realmente vem o resultado
O DualCLIPLoader carrega os dois codificadores de texto do Flux (T5 XXL e CLIP-L, ambos no Model Manager). O prompt negativo fica vazio; o Flux não usa um como o SDXL.
Para o prompt positivo, dei o esboço do Pepe ao ChatGPT e pedi um prompt que descrevesse uma imagem fotorrealista dele. Depois o editei. A cabeça bulbosa não saía direito, e estava lisa demais, então acrescentei rugas por toda parte. Isso fez uma grande diferença.
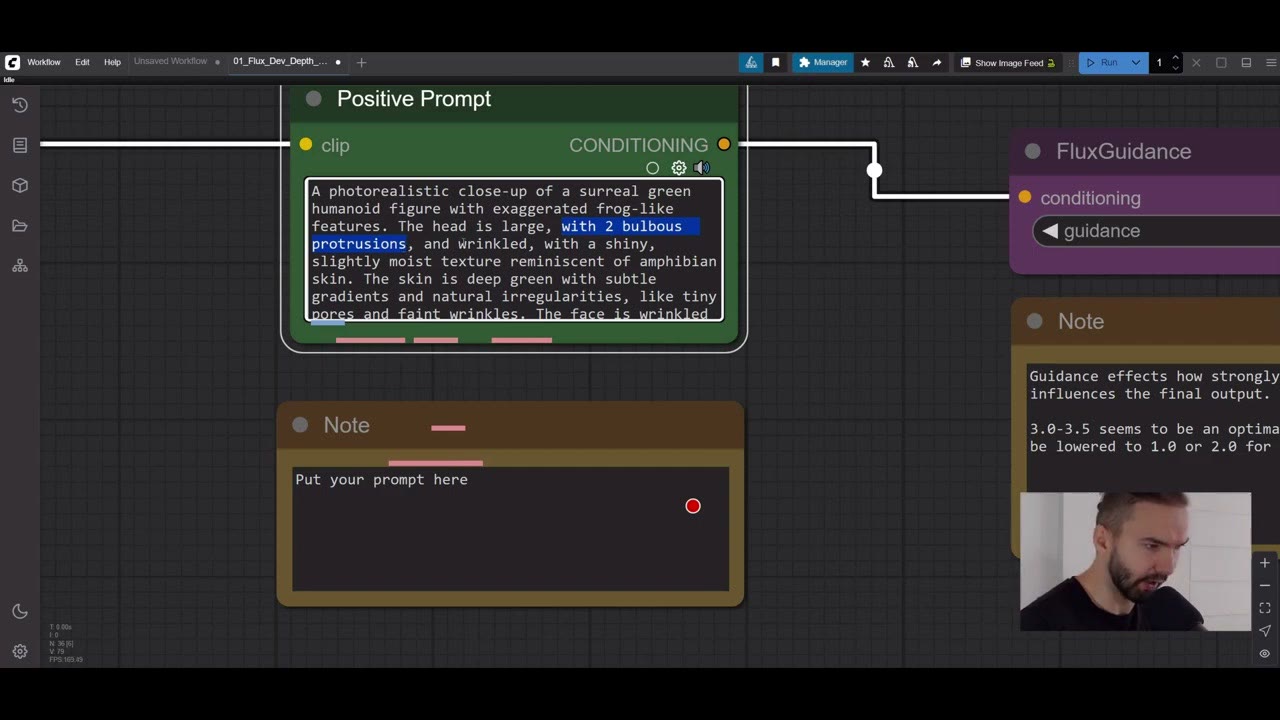
Aqui está o prompt completo (pode ser mais curto):
A photorealistic close-up of a surreal green humanoid figure with exaggerated frog-like features. The head is large, bulbous, wrinkly with a shiny, slightly moist texture reminiscent of amphibian skin. The skin is deep green with subtle gradients and natural irregularities, like tiny pores and faint wrinkles. The face shows an awkward forced grin, exposing perfectly aligned, unnaturally bright white teeth. The mouth is wide with pronounced reddish-brown lips that contrast with the green skin. The figure's eyes are narrow and squinting in the middle of the face, with small black pupils looking slightly to the side, very wrinkly on sides. At the corners of the eyes are glistening tear streaks, as if the character is crying while smiling. The tears reflect ambient light, adding to the surreal emotional contrast. The neck is thick, and the figure wears a plain, bright blue fabric collar that appears slightly soft and textured, like fleece or cotton. The lighting is studio-like with soft shadows, emphasizing the glossy, slimy surface of the skin and the moisture of the tears. No nostrils.Repare em quanto dele descreve materiais e luz: pele úmida, poros, lágrimas brilhantes, fleece, sombras de estúdio. É isso que transforma um desenho numa foto. Os dois prompts passam pelo Flux Guidance e vão ao condicionamento do sampler.
5. Amostragem, decodificação e salvamento
- Steps: 25, para uma qualidade um pouco melhor. Deixo os outros ajustes como estão; funcionam.
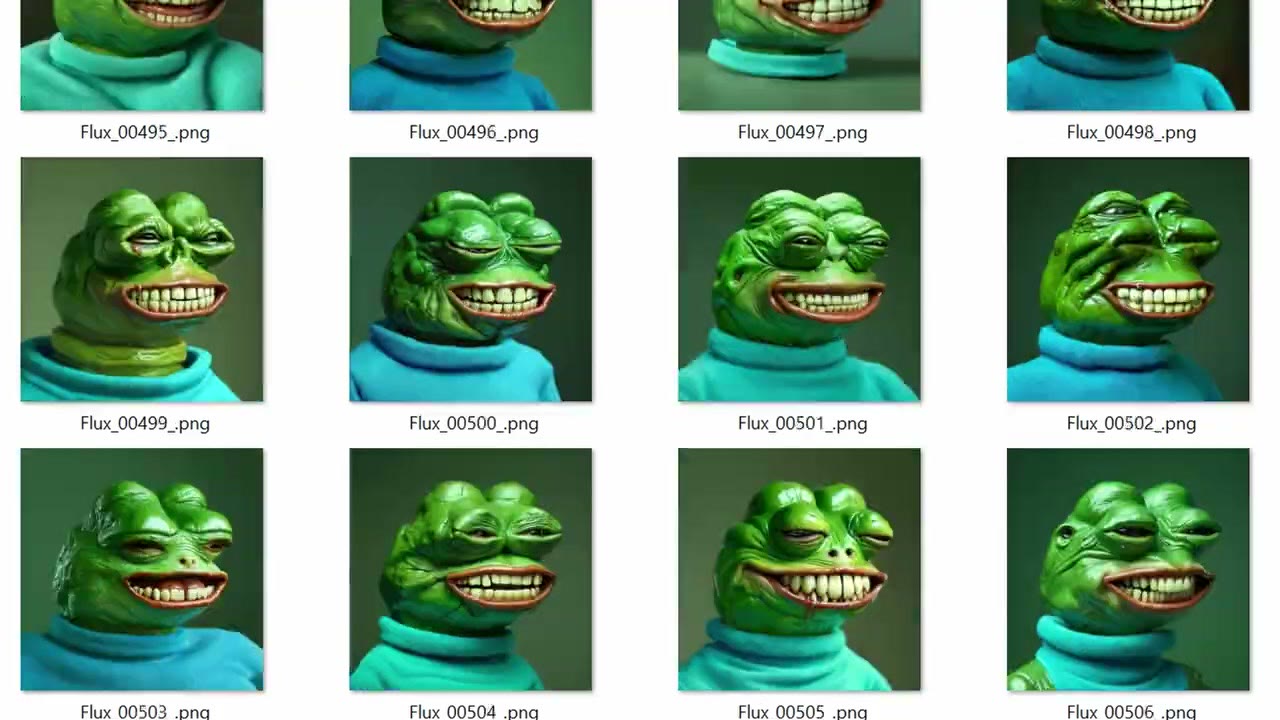
- Seed em increment. Em algumas semanas fiz cerca de 2.000 imagens, e cada nova é simplesmente o número seguinte, o que facilita acompanhar execuções durante a noite.
O VAE Decode converte o resultado de volta em pixels. O sampler trabalha no espaço latente, uma versão comprimida da imagem oito vezes menor, então ela precisa ser decodificada. Um nó de comparação mostra o antes e o depois, e a imagem é salva com o prefixo «flux».
Anime com o Seedance na fal
Para fazê-lo se mover, usei a fal e o modelo de imagem para vídeo Seedance da ByteDance (busque «Seedance» e escolha image to video). Envie a imagem e escreva um prompt de movimento. Copiei meu prompt do Flux e acrescentei «squinting» no começo; esforço mínimo, e funcionou bem. No final fica realmente arrepiante.
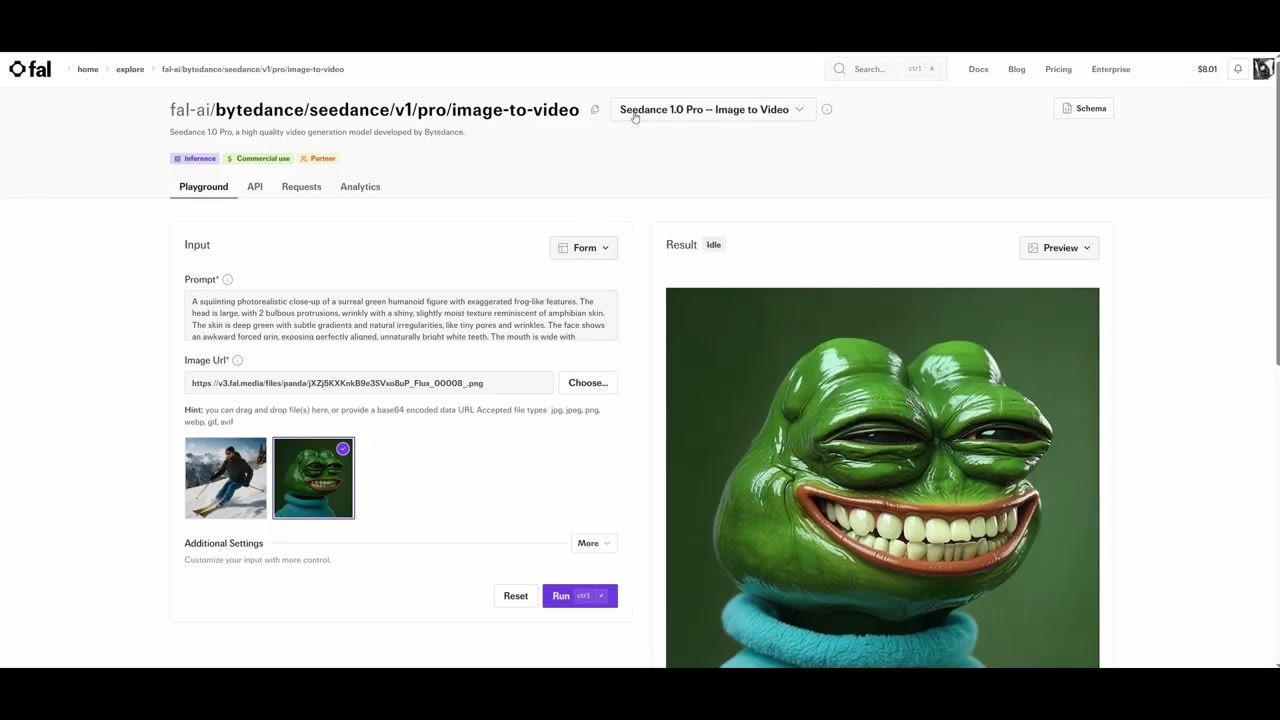
Custo: o Seedance Lite custa cerca de 20 centavos por cinco segundos, o que é barato por qualquer medida. Usei o Pro para melhor qualidade no YouTube, a 74 centavos.
Você também pode animar localmente no ComfyUI, mas exige muito mais processamento e pode levar uma ou duas horas. Para uma animação rápida de meme, este foi o caminho fácil.
Sem uma GPU de 16 GB?
O mesmo fluxo está configurado no RunComfy, então você pode rodá-lo no navegador. Hoje uso o RunPod para esse tipo de trabalho; minha introdução ao RunPod mostra como. Para ver passo a passo a mesma configuração de profundidade em qualquer esboço, veja esboço em arte com o Flux.
O link do RunComfy é um link de indicação, assim como meu link de indicação do RunPod: novas contas do RunPod que se cadastram com o Google ganham de US$ 5 a US$ 500 em crédito após seus primeiros US$ 10, e eu recebo uma pequena comissão.
Assista à versão em vídeo (7:37)
Tudo o que está acima também está no vídeo, se você preferir acompanhar na tela. O vídeo está em inglês.
Perguntas frequentes
Quanta VRAM preciso para este fluxo do Flux?
Eu diria que pelo menos 16 GB. Rodei com 24 GB. Com menos, use uma GPU na nuvem.
Como faço uma versão fotorrealista de um desenho animado?
Use o mapa de profundidade do desenho para manter a forma e depois descreva-o como uma fotografia, em detalhe. Pedi ao ChatGPT um primeiro prompt a partir do esboço e depois o editei à mão, acrescentando rugas e removendo o que não funcionava.
Quanto custa animar a imagem?
Na fal, o Seedance Lite de imagem para vídeo custou cerca de 20 centavos por cinco segundos; a versão Pro que usei custou 74 centavos.

Anton Tenitsky é artista 3D com mais de 15 anos em computação gráfica, que trabalhou com Nickelodeon, Gameloft, Marvel Rivals e muitos outros clientes. Mais sobre mim