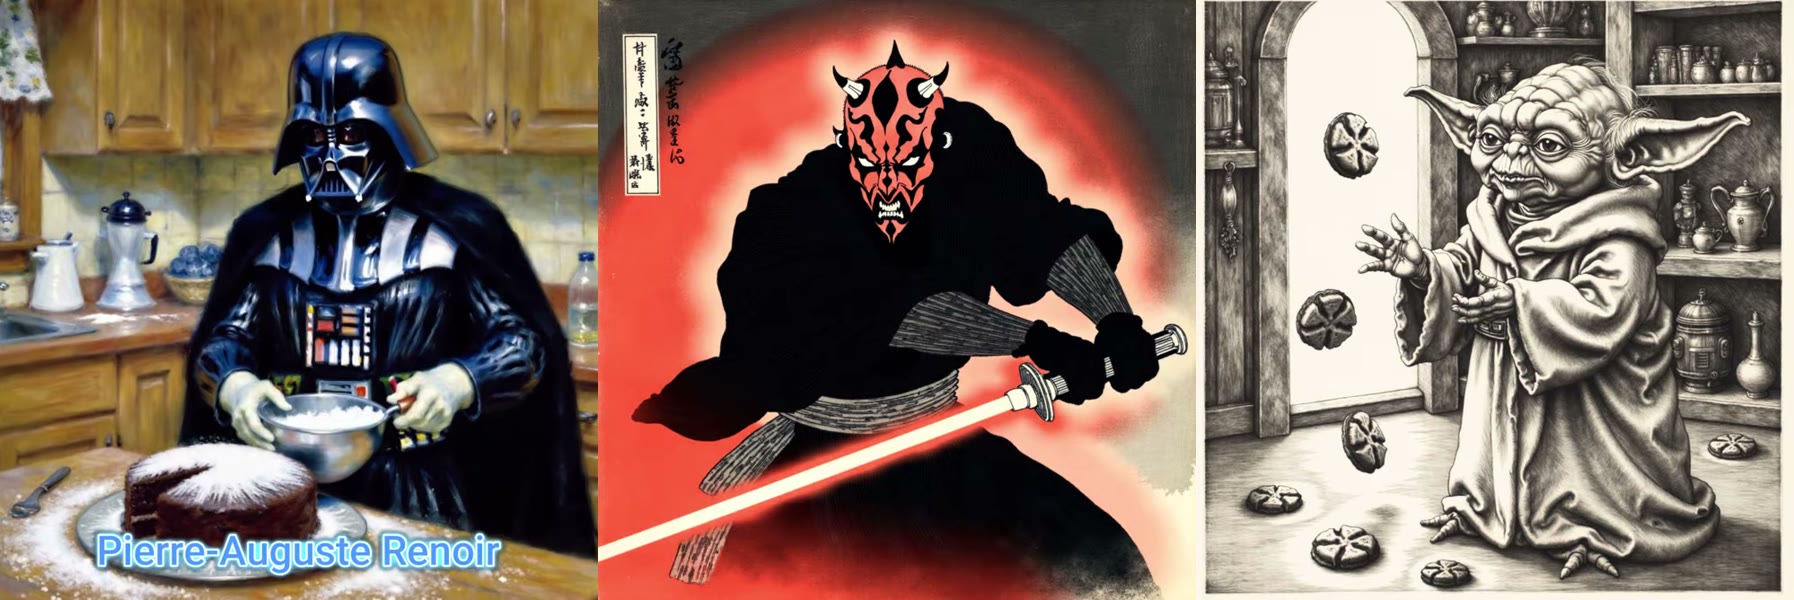
O Flux sabe um pouco de tudo. Foi treinado com bilhões de imagens, então se você pedir «uma gravura» vai receber algo parecido com uma gravura. Peça o hachurado específico de Albrecht Dürer e ele chuta.
Um LoRA resolve isso. É um pequeno modelo complementar, treinado com um punhado de imagens, que empurra o Flux para um estilo, personagem ou visual específico. Treinar um exige um punhado de imagens, alguns minutos e alguns dólares.
Na parte 1, treino três LoRAs de estilo de artistas: o impressionismo de Renoir, as xilogravuras de Hokusai e as gravuras de Dürer. Na parte 2, monto um fluxo do ComfyUI que percorre centenas de prompts sozinho.
Em resumo
- Um LoRA de estilo precisa de apenas 6–15 imagens em um estilo consistente.
- Treinar na fal custa cerca de US$ 2 e leva de 5 a 10 minutos.
- Use uma trigger word inventada como
renoir123, nunca uma palavra real. - Gere em cerca de 1 megapixel, Flux guidance 3, 20–25 steps.
- Uma lista de prompts e um contador de loop permitem ao ComfyUI rodar mais de 50 prompts sem supervisão.
O que é um LoRA?
LoRA significa low-rank adaptation (adaptação de baixo posto), uma técnica apresentada em um artigo de 2021 de Hu et al.. Em vez de retreinar um modelo inteiro, você treina um pequeno conjunto de pesos extras que ficam por cima dele e orientam o que ele produz. Se quiser a ideia sem a matemática, esta explicação no Medium é uma boa leitura.
Na prática, isso significa:
- O arquivo é pequeno. Meus LoRAs de estilo do Flux têm cerca de 85 MB. O Flux dev em si tem uns 12 GB.
- Treinar é barato e rápido: alguns dólares e alguns minutos.
- Dá para trocar. Um modelo base, quantos LoRAs você quiser.
Há dois tipos comuns. Um LoRA de personagem aprende uma pessoa ou um rosto, muitas vezes o seu. Um LoRA de estilo aprende um visual: pincelada, traço, paleta. O estilo pode ser desde realismo pictórico até algo tão plano e limpo quanto South Park, embora eu evitaria estilos protegidos por direitos autorais para qualquer coisa que você publique. Este guia cobre LoRAs de estilo, que são mais tolerantes: sem máscaras de rosto, sem legendas cuidadosas.
O que você precisa
- 6–15 imagens em um único estilo consistente.
- Uma conta na fal.ai com alguns dólares de crédito. Recarreguei US$ 10 e treinei vários LoRAs com isso.
- ComfyUI com Flux dev para a parte 2.
- Cerca de 12 GB de VRAM para rodar bem o Flux, localmente ou em uma GPU na nuvem.
Eu não treino LoRAs localmente. Leva muito mais tempo, e uma execução pode falhar no meio. Na fal, um LoRA custa cerca de US$ 2 e fica pronto em minutos.
Passo 1: reúna suas imagens de treinamento
Para os mestres antigos, a Wikipédia e o Wikimedia Commons são as melhores fontes: digitalizações de alta resolução, em sua maioria de domínio público.
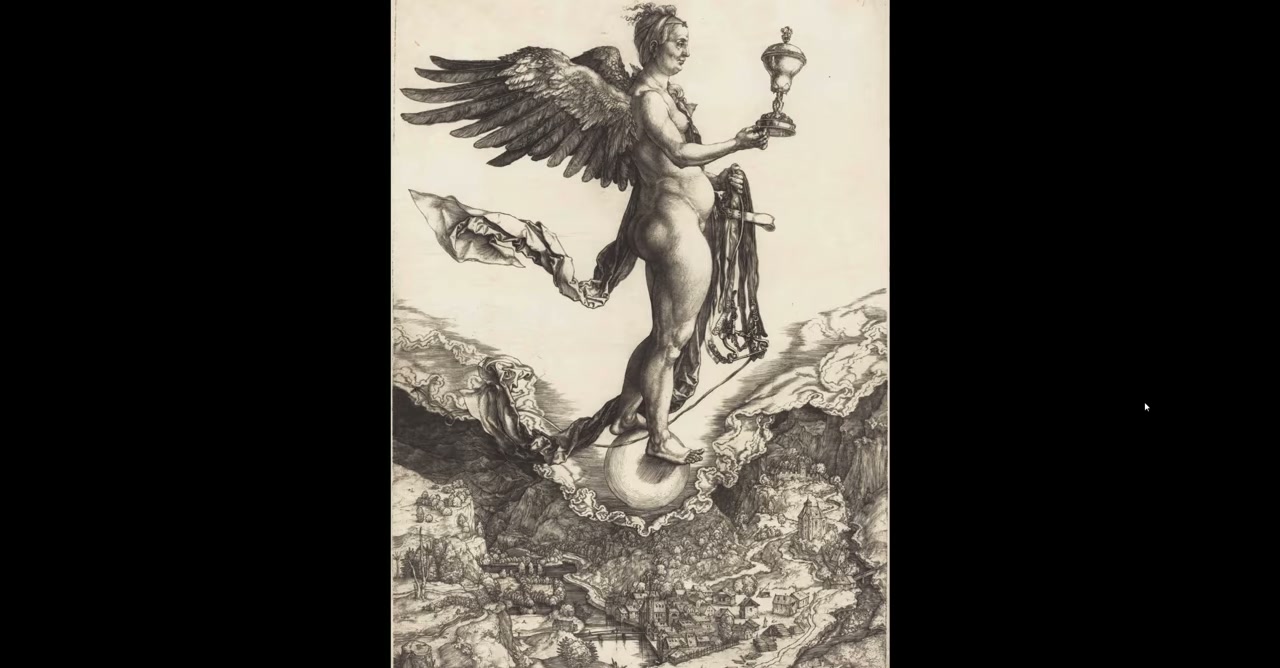
Consistência importa mais que quantidade. Para Dürer, escolhi só gravuras com seu hachurado denso. Pulei suas aquarelas, como a famosa Jovem lebre, porque puxariam o LoRA em outra direção.
| LoRA | Imagens | O que escolhi |
|---|---|---|
| Albrecht Dürer | 10 | Gravuras com hachurado cruzado intenso |
| Hokusai | cerca de 15 | Xilogravuras |
| Renoir | 11 | Pinturas impressionistas |
Para um estilo forte e distintivo, dá para ir até cinco imagens.
Passo 2: treine o LoRA na fal
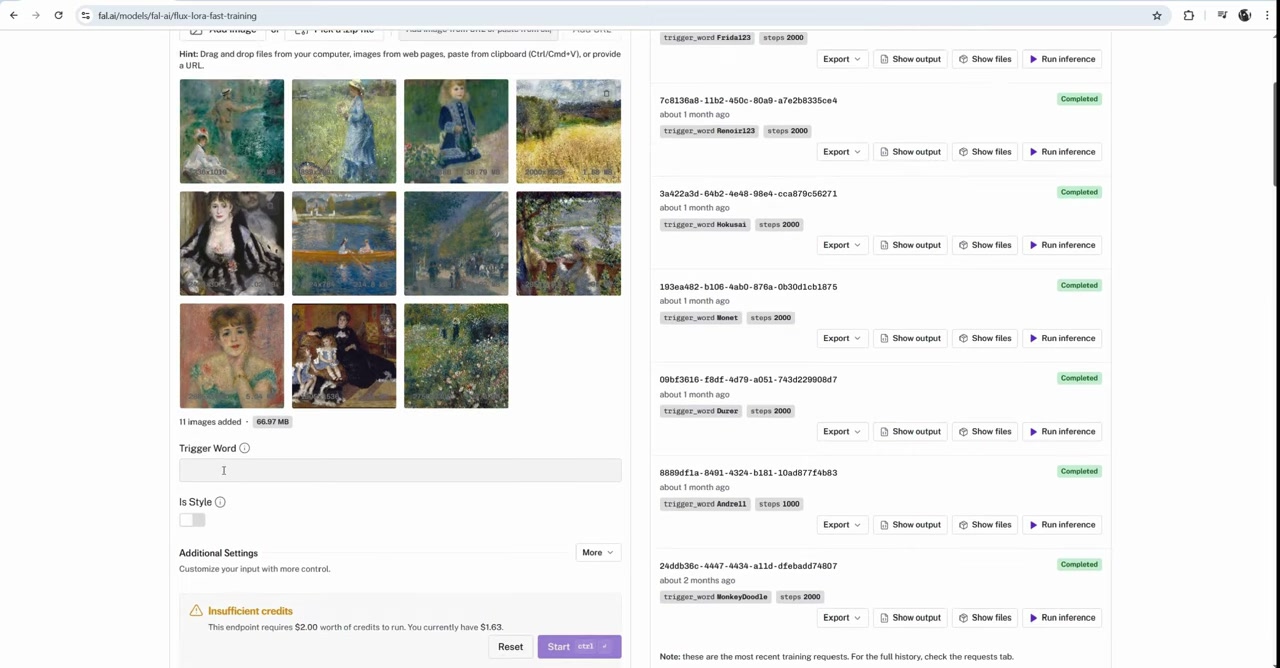
Na fal, abra o modelo Flux LoRA Fast Training. Há vários modelos Flux na fal; pule as variantes mais novas como Kontext e Krea para isso. Quando gravei, elas não suportavam ControlNet, então você perderia o controle de pose depois. Treine para o Flux dev.
Arraste suas imagens e ajuste estas opções:
| Ajuste | O que uso | Por quê |
|---|---|---|
| Trigger word | renoir123 |
Única, para o Flux não confundir com nada que já conhece |
| Is style | Ativado | É um estilo, não uma pessoa |
| Masks | Desativado | Máscaras são para rostos |
| Steps | Padrão, ou 2.000 | 2.000 steps dá melhor qualidade, mas dobra o custo para cerca de US$ 4 |
Clique em Start. O treinamento leva de 5 a 10 minutos.
O erro que cometi com a trigger word: minha primeira tentativa foi um LoRA de Claude Monet com a trigger word monet. Não funcionou. «Monet» é uma palavra sobre a qual o Flux já tem ideias muito fortes, então o LoRA não conseguiu assumir o controle. monet123 teria funcionado. Sempre adicione números ou bobagens para tornar a trigger word única.
Passo 3: baixe, renomeie e instale
Quando o treinamento terminar, abra Show files e baixe o arquivo .safetensors, de cerca de 85 MB. O Safetensors é o formato padrão para compartilhar pesos de modelos porque, ao contrário dos formatos antigos, não pode carregar código executável.
A fal nomeia o arquivo pytorch_lora_weights.safetensors. Renomeie imediatamente. Eu coloco a trigger word no nome do arquivo, para nunca precisar procurar qual palavra vai com qual LoRA:
ComfyUI/models/loras/lora_renoir123.safetensorsEle precisa ficar na pasta loras, ou o carregador de LoRA não o verá. Em um pod do RunPod, envie-o pelo JupyterLab para a mesma pasta no seu volume de rede.
Passo 4: teste
A fal tem um botão Run inference ao lado do seu LoRA treinado, então você pode testar antes de abrir o ComfyUI. Meu primeiro prompt, renoir123, Darth Maul standing on a turtle, pegou o estilo mas pouco mais. Trocar para o Yoda funcionou muito melhor, a cerca de 4 centavos por imagem.
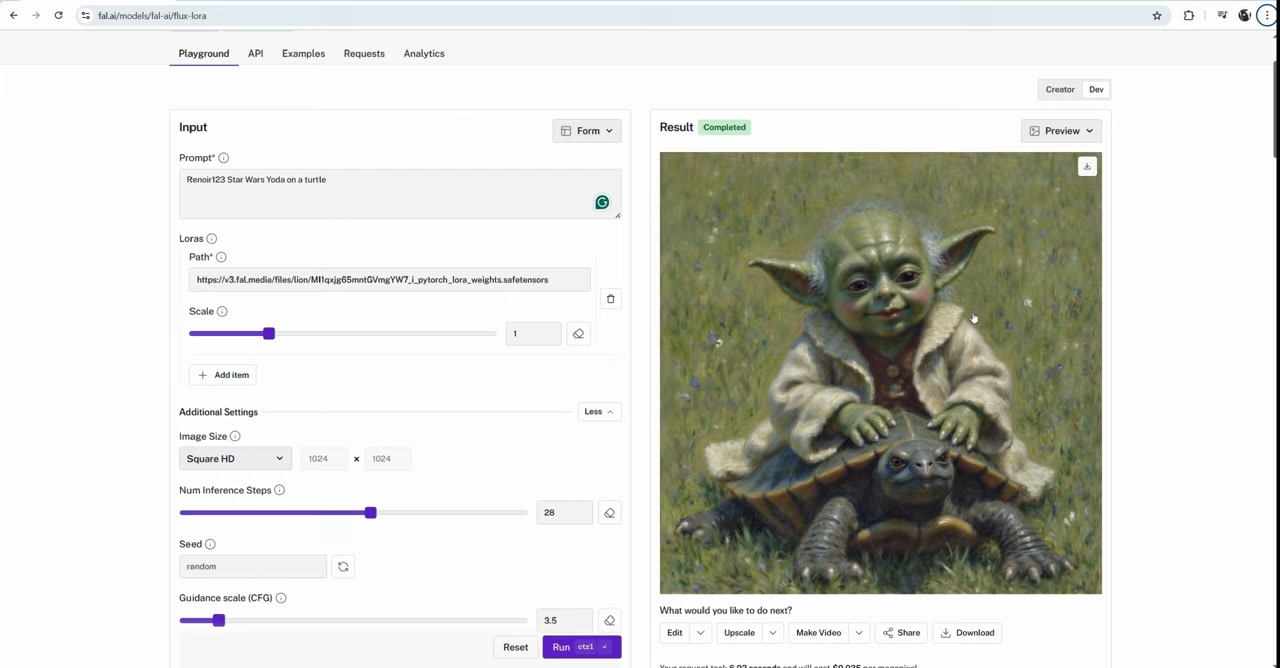
A resolução importa. O Flux funciona melhor em cerca de 1 megapixel: 1024 × 1024, ou «square HD» na fal. 512 × 512 é pequeno demais para bom detalhe, e subir para quadrados de 2K ou 4K dá imagens piores que 1K. É assim que esses modelos se comportam.
Por diversão, passei o resultado para um modelo de imagem para vídeo, o Seedance Lite, também na fal. Por 18 centavos e com ajustes padrão, consegui alguns segundos de Yoda balançando na tartaruga.
Passo 5: monte o fluxo Flux + LoRA no ComfyUI
O treinamento terminou. O grafo básico do ComfyUI tem nove nós. Aqui está cada um e como o configuro:
| Nó | Ajuste | Observações |
|---|---|---|
| Load Diffusion Model | flux1-dev |
Cerca de 12 GB; instale pelo Model Manager |
| Load LoRA | lora_renoir123 |
Lê models/loras |
| DualCLIPLoader | CLIP-L + T5 | Os dois codificadores de texto de que o Flux precisa |
| Empty Latent Image | 1024 × 1024 | Sua resolução de saída |
| Flux Guidance | 3 | Com que força o prompt empurra. Alto demais queima a imagem |
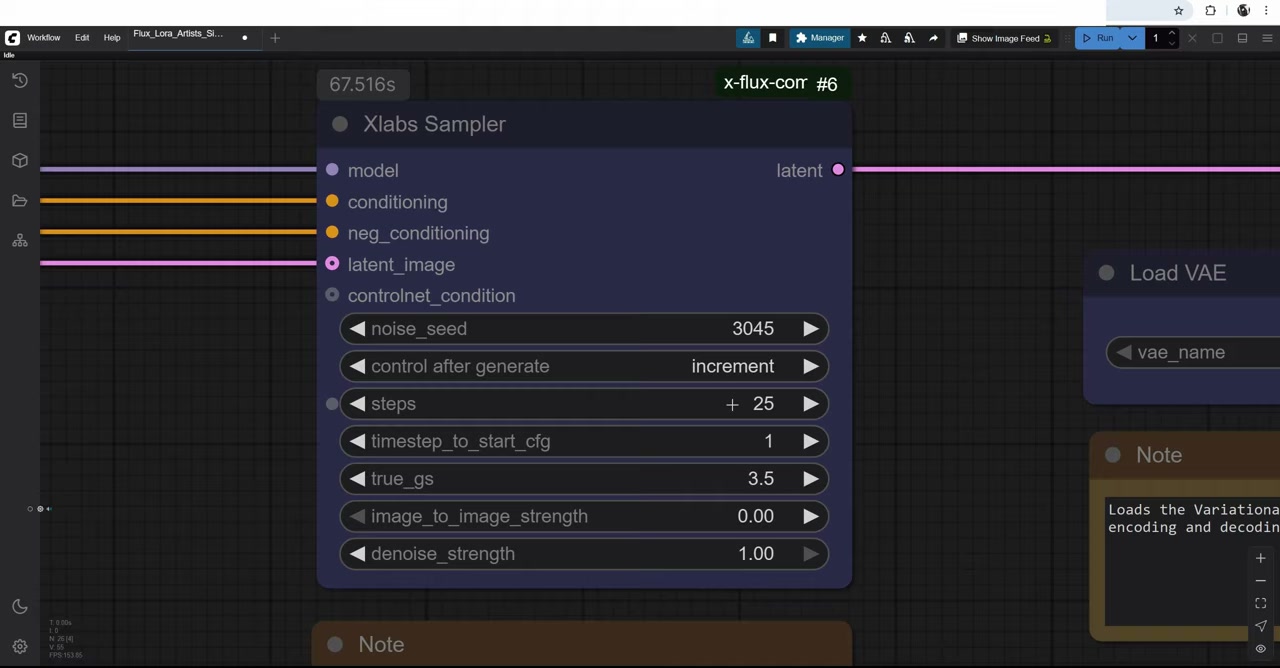
| XLabs Sampler | 25 steps, seed em increment | 20 também serve. Acima de 50 é perda de tempo |
| Negative prompt | Vazio | O Flux praticamente o ignora, mas precisa estar conectado |
| VAE Decode | Flux VAE | Cerca de 300 MB; transforma o latente em pixels |
| Image Save (WAS) | PNG, prefixo personalizado | Nomes de arquivo mais fáceis que no nó Save padrão |
Coloque a trigger word no início do seu prompt positivo: renoir123, Star Wars, cooking cakes. Colocar a seed em increment também dá uma contagem de quantas imagens você já fez.
Passo 6: rode centenas de prompts automaticamente
Fazer uma imagem por vez é o que você faria em um site. O ComfyUI se justifica quando você enfileira 50 prompts e vai dormir. Você vai precisar de três pacotes de custom nodes, todos instaláveis pelo ComfyUI Manager: ComfyUI Inspire Pack, WAS Node Suite e x-flux-comfyui.
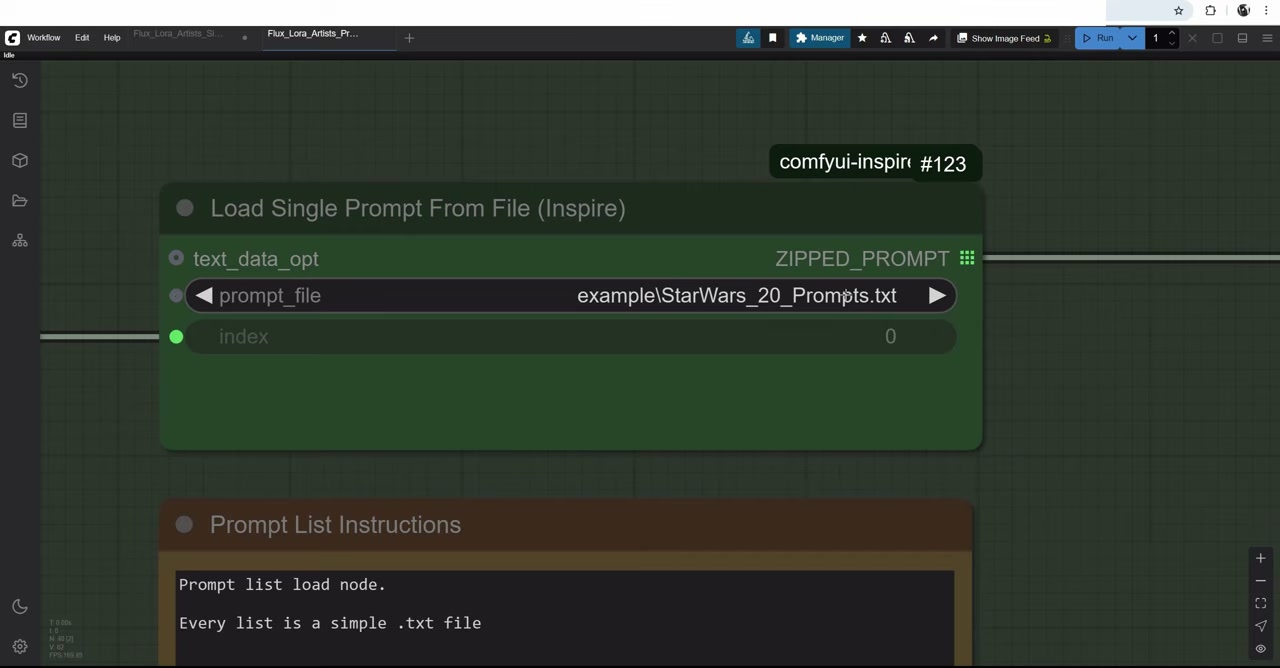
1. Escreva o arquivo de prompts
Pedi ao ChatGPT 50 prompts de Star Wars neste formato exato. O Gemini funciona igualmente bem:
positive: Star Wars art, Princess Leia, leading Rebel Alliance troops, holographic maps, determined faces
negative: blurry, cartoonish, scared, disheveled, empty room
---
positive: Star Wars art, Yoda, teaching young Jedi in a serene temple, ancient architecture
negative: blurry, cartoonish, chaotic, angry, noisy environment
O formato é rígido:
positive:enegative:precisam estar em minúsculas.- Os prompts são separados por
---. - A linha negative não pode ficar vazia, mesmo que o Flux a ignore. Uma vazia quebra o grafo inteiro.
- Apague qualquer linha de introdução que o chatbot adicione no topo.
2. Coloque na única pasta que funciona
Salve o arquivo em ComfyUI/custom_nodes/comfyui-inspire-pack/prompts/. O nó Load Prompts From File só procura ali.
3. Adicione a trigger word
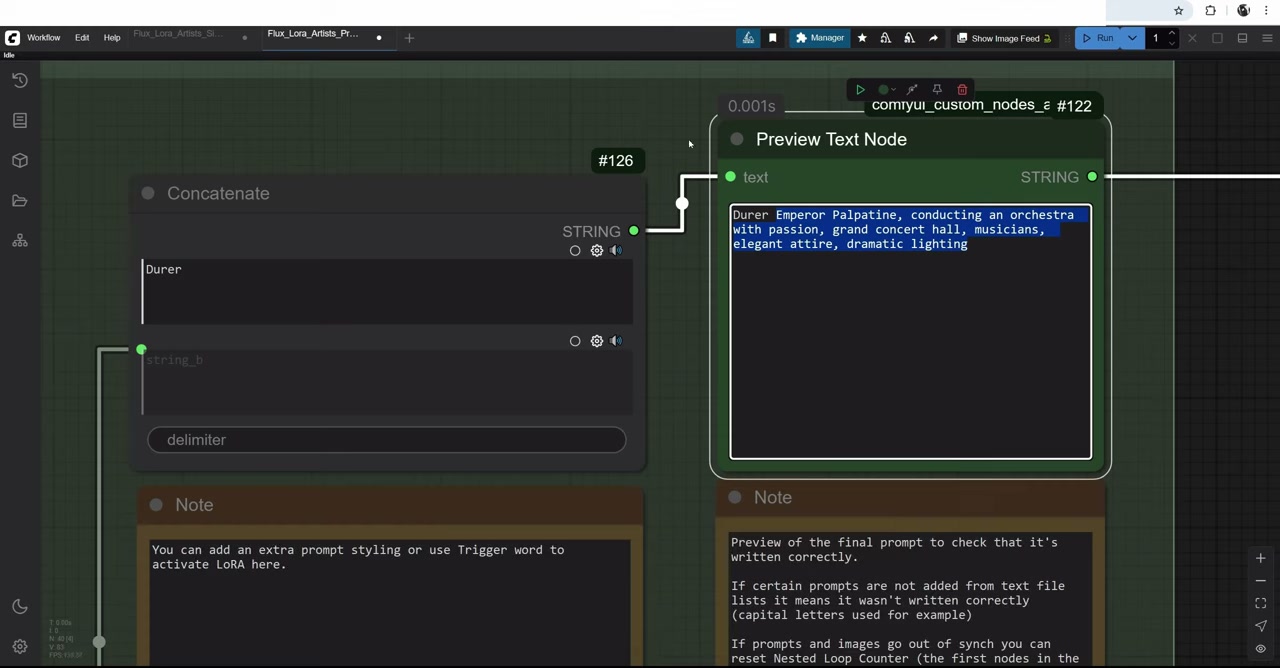
Um nó Concatenate coloca a trigger word na frente de cada prompt, então trocar de estilo significa mudar um único campo. Deixe um espaço depois da trigger word, ou ela fica colada na primeira palavra do prompt.
4. Faça-o avançar
Aqui está a parte que a maioria dos tutoriais perde: sozinha, a lista de prompts só executa o primeiro prompt. Para percorrer a lista, alimente o índice com um WAS Nested Loop Counter:
- Defina o máximo como o número de prompts do seu arquivo, com incremento de 1.
- Conte seus prompts. Peça 50 a um chatbot e muitas vezes você receberá 48 ou 49. Eu busco
positive:no arquivo e uso o número de ocorrências. - Para recomeçar, defina reset como true por uma execução e depois volte a false. O contador começa em 0, então 50 prompts vão de 0 a 49.
Aprofundo as listas de prompts em outro vídeo.
5. Execute e vá embora
Coloque a fila em Run (Instant) e deixe. Algumas das minhas imagens da noite eram horríveis e outras ótimas. Todo mundo seleciona o melhor da saída de IA; o truque é tornar essa seleção barata.
O que saiu
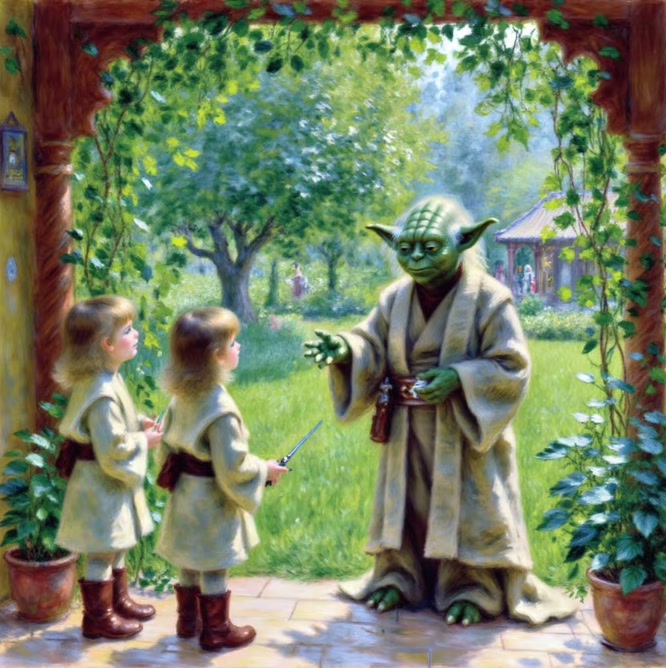
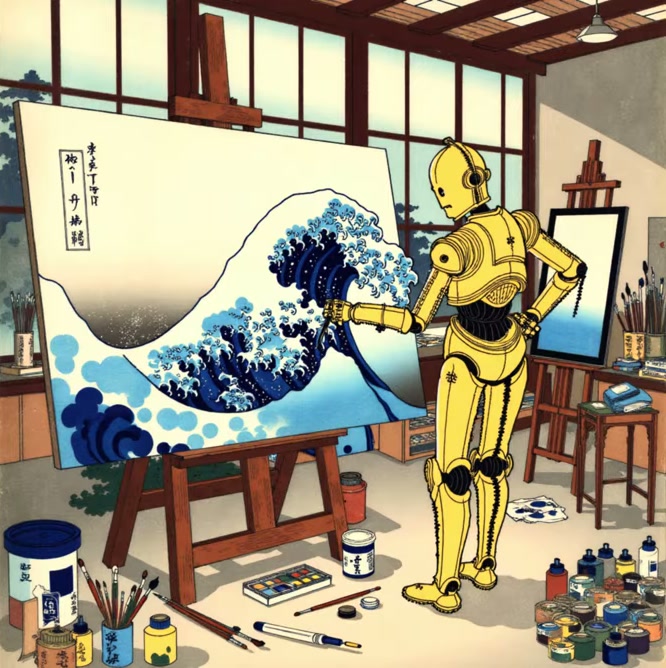
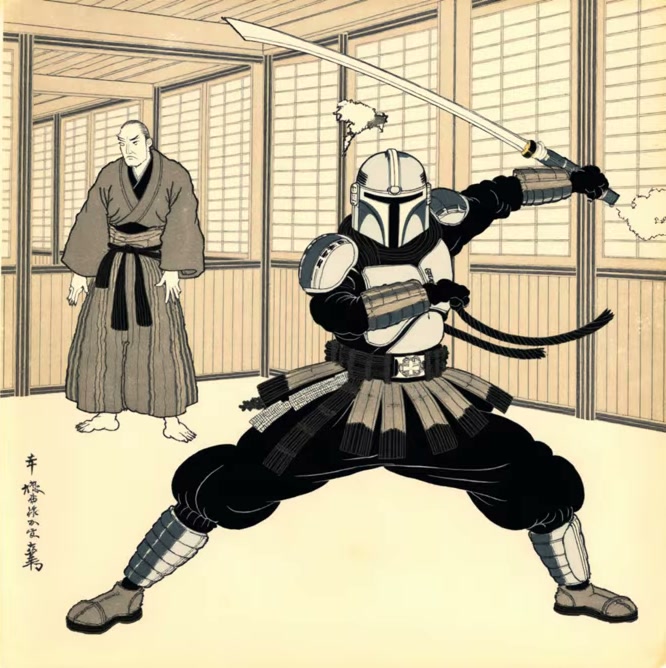
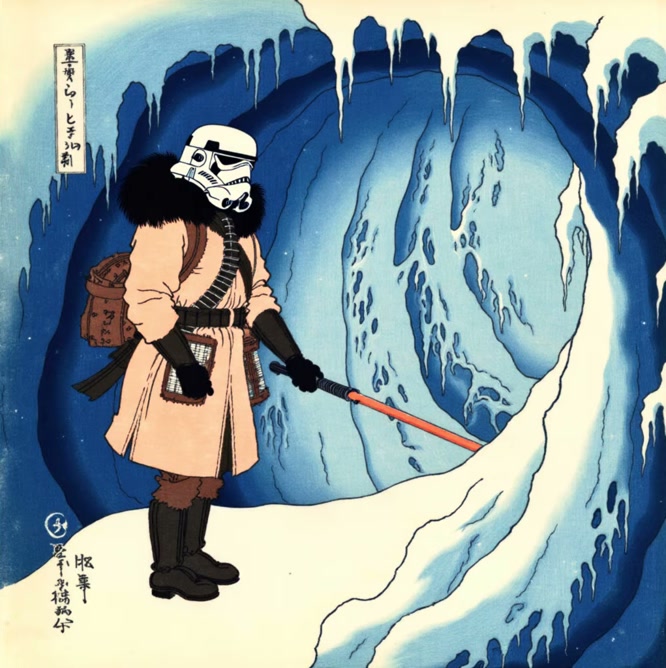
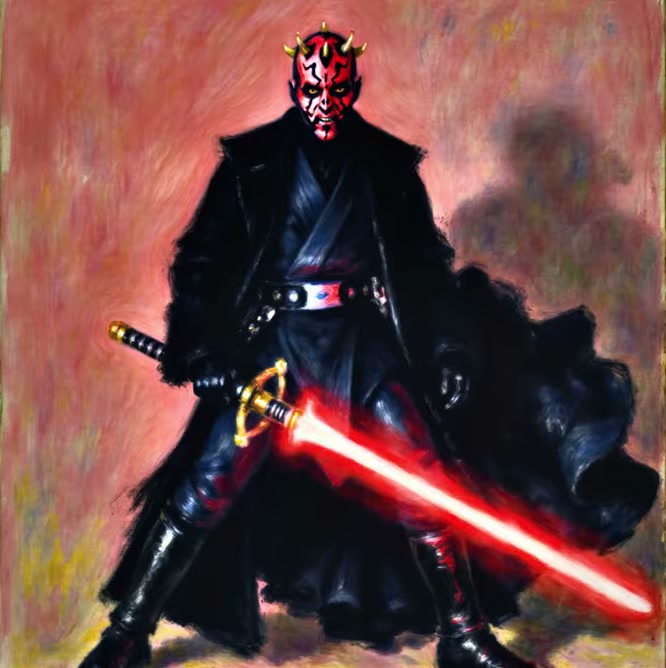
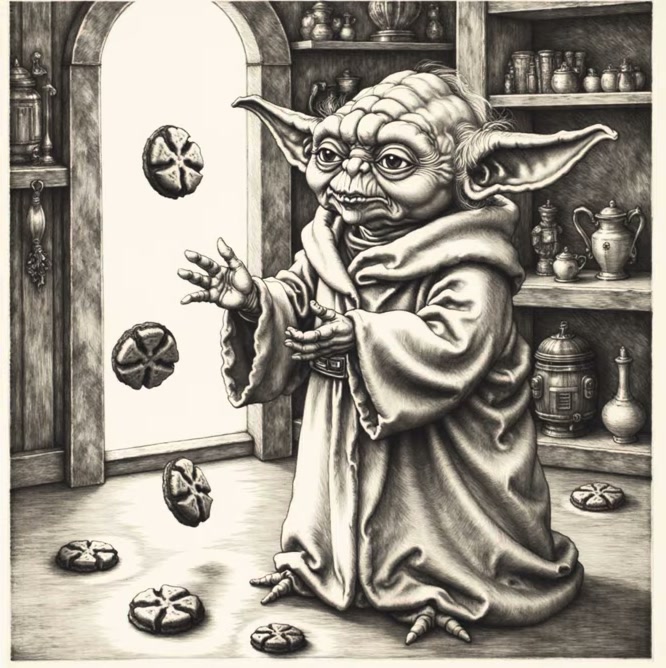
LoRAs de Renoir, Hokusai e Dürer, a partir da mesma lista de prompts da noite.
Onde rodar
Treinar e rodar são dois trabalhos diferentes, e uso um lugar diferente para cada um:
| Tarefa | Onde faço | Custo |
|---|---|---|
| Treinar o LoRA | fal | Cerca de US$ 2 por LoRA |
| Testes rápidos | fal | Cerca de 4¢ por imagem |
| Lotes noturnos no ComfyUI | Sua própria GPU de 12 GB ou mais, ou uma GPU na nuvem | Eletricidade, ou a partir de US$ 0,27/h por uma RTX A5000 no RunPod |
Quando gravei este vídeo, o ComfyUI rodava na minha própria RTX A5000. Desde então passei para o RunPod: os modelos ficam em um volume de rede, e alugo uma GPU só enquanto um lote roda. Se você já tem uma placa de 12 GB ou mais, rode localmente. É grátis, fora a eletricidade. Se não tem, alugar é muito mais barato que comprar uma. Minha introdução ao RunPod cobre a configuração, os custos e qual GPU escolher.
Se quiser experimentar, este é o meu link de indicação do RunPod: você ganha de US$ 5 a US$ 500 em crédito após seus primeiros US$ 10 (cadastre-se com o Google), e eu recebo uma pequena comissão.
Erros a evitar
- Uma trigger word comum.
monetfalha;monet123funciona. - Estilos misturados no conjunto de treinamento. Dez imagens consistentes valem mais que trinta misturadas.
- A resolução errada. Fique em torno de 1 megapixel.
- Guidance alto demais. Acima de cerca de 3, a imagem começa a queimar.
- O LoRA na pasta errada. Precisa ser
models/loras. - Um arquivo de prompts quebrado. Letras maiúsculas, uma linha negative vazia ou a pasta errada vão parar o grafo.
- Uma contagem de loop que não confere. Conte você mesmo os prompts.
Uma nota sobre direitos autorais
Dürer, Hokusai e Renoir estão fora dos direitos autorais há muito tempo. Artistas vivos são outra história. Treinei LoRAs com os estilos de amigos com a permissão deles, mostrei os resultados e os mantive privados. Pergunte primeiro. E usei personagens de Star Wars aqui por diversão, não para algo que eu venderia.
Os fluxos de LoRA e de lista de prompts, mais meus três LoRAs de artistas, estão no Patreon.
Assista à versão em vídeo (19:53)
Tudo o que está acima também está no vídeo, se você preferir acompanhar na tela. O vídeo está em inglês.
Perguntas frequentes
Quantas imagens preciso para treinar um LoRA?
Para um LoRA de estilo, de 6 a 15 imagens em um estilo consistente. Um estilo muito distintivo pode funcionar com apenas cinco.
Quanto custa treinar um LoRA?
Cerca de US$ 2 na fal com os steps padrão, ou cerca de US$ 4 com 2.000 steps. Testar custa cerca de 4 centavos por imagem.
Quanto tempo leva o treinamento de um LoRA?
De cinco a dez minutos na fal para um LoRA de estilo.
De que GPU preciso para usar um LoRA do Flux?
Cerca de 12 GB de VRAM para rodar bem o Flux dev. Se sua placa for menor, uma GPU na nuvem como a RTX A5000 funciona.
O que é uma trigger word (palavra gatilho)?
Uma palavra única que você adiciona ao prompt para ativar o LoRA. Use algo que o Flux nunca viu, como renoir123, não um nome real.

Anton Tenitsky é artista 3D com mais de 15 anos em computação gráfica, que trabalhou com Nickelodeon, Gameloft, Marvel Rivals e muitos outros clientes. Mais sobre mim