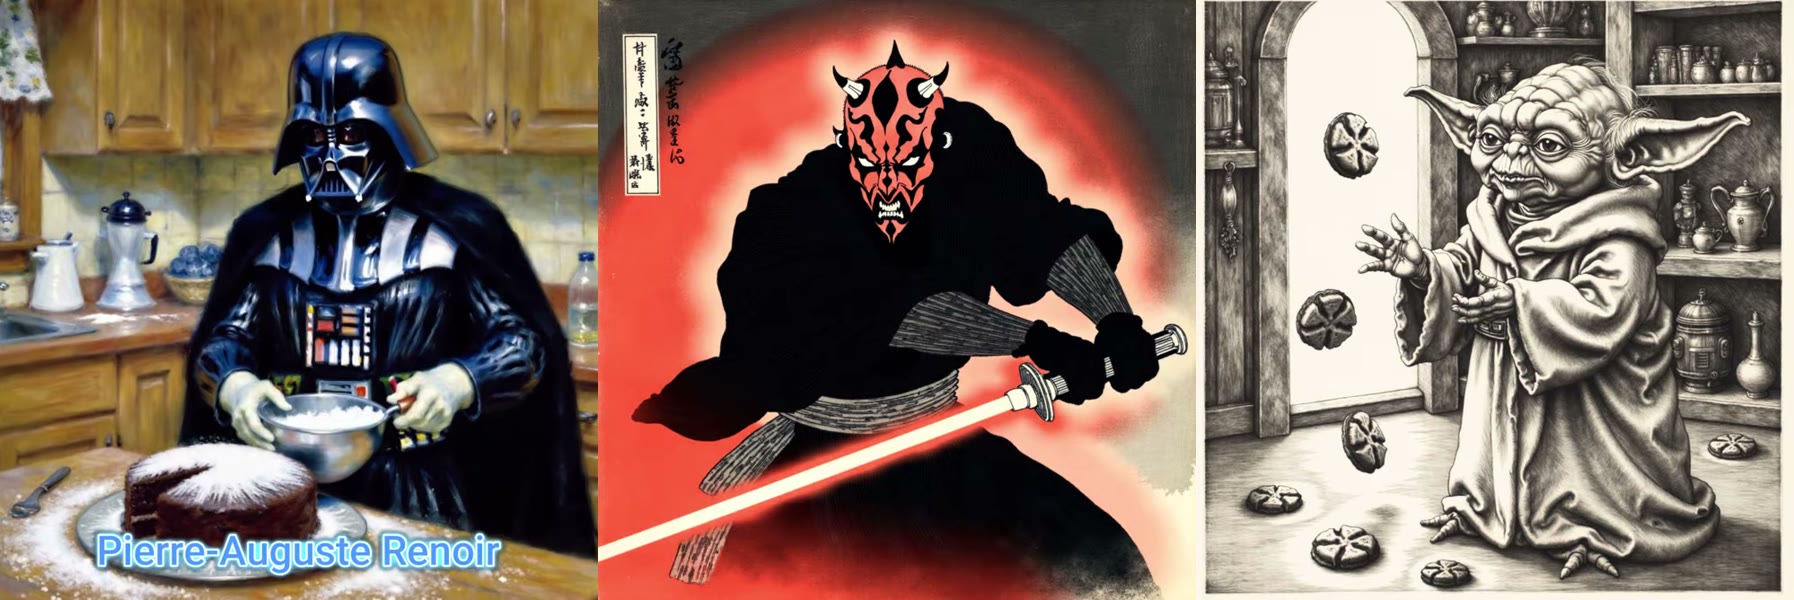
Fluxは何でも少しずつ知っています。何十億枚もの画像で学習されているので、「版画」と頼めば版画っぽいものができます。しかし、アルブレヒト・デューラー特有のクロスハッチングを頼むと、推測で作ります。
LoRAがそれを解決します。少数の画像で学習させる小さな追加モデルで、Fluxを特定のスタイル、キャラクター、見た目へと寄せていきます。学習に必要なのは、少数の画像、数分、数ドルだけです。
パート1では、ルノワールの印象派、北斎の木版画、デューラーの版画という3つの画家スタイルのLoRAを学習します。パート2では、何百ものプロンプトを自動で順番に実行するComfyUIのワークフローを作ります。
ポイント
- スタイルLoRAに必要なのは、一貫したスタイルの6〜15枚の画像だけです。
- falでの学習は約2ドル、5〜10分で終わります。
renoir123のような作り物のトリガーワードを使い、実在の単語は使わないでください。- 生成は約1メガピクセル、Flux guidance 3、20〜25ステップで行います。
- プロンプトリストとループカウンターで、ComfyUIは50以上のプロンプトを無人で実行できます。
LoRAとは?
LoRAはlow-rank adaptation(低ランク適応)の略で、Huらの2021年の論文で提案された手法です。モデル全体を再学習する代わりに、その上に載って出力を方向付ける小さな追加の重みを学習します。数式なしでイメージをつかみたいなら、このMediumの解説がおすすめです。
実際には次のようなことを意味します。
- ファイルが小さい。 私のFluxスタイルLoRAは約85MBです。Flux dev自体は約12GBあります。
- 学習が安く速い。 数ドルと数分で済みます。
- 入れ替えられる。 1つのベースモデルに、好きなだけLoRAを使えます。
一般的な種類は2つです。キャラクターLoRAは人物や顔(多くは自分自身)を学習します。スタイルLoRAは筆づかい、線、パレットといった見た目を学習します。スタイルは、絵画的なリアリズムから、サウスパークのような平らで簡潔なものまで何でも構いませんが、公開するものには著作権のあるスタイルは避けることをおすすめします。このガイドで扱うスタイルLoRAは、顔のマスクも丁寧なキャプションも不要で、より寛容です。
必要なもの
- 一貫した1つのスタイルの6〜15枚の画像。
- 数ドル分のクレジットがある**fal.aiのアカウント**。私は10ドルをチャージして、複数のLoRAを学習しました。
- パート2用の、Flux devを入れたComfyUI。
- Fluxを快適に動かすための約12GBのVRAM(ローカルまたはクラウドGPU)。
私はLoRAをローカルで学習しません。ずっと時間がかかり、途中で失敗することもあるからです。falなら、LoRAは約2ドルで数分で終わります。
ステップ1:学習用の画像を集める
古典の巨匠の作品なら、WikipediaとWikimedia Commonsが最良の情報源です。高解像度のスキャンが、多くはパブリックドメインで公開されています。
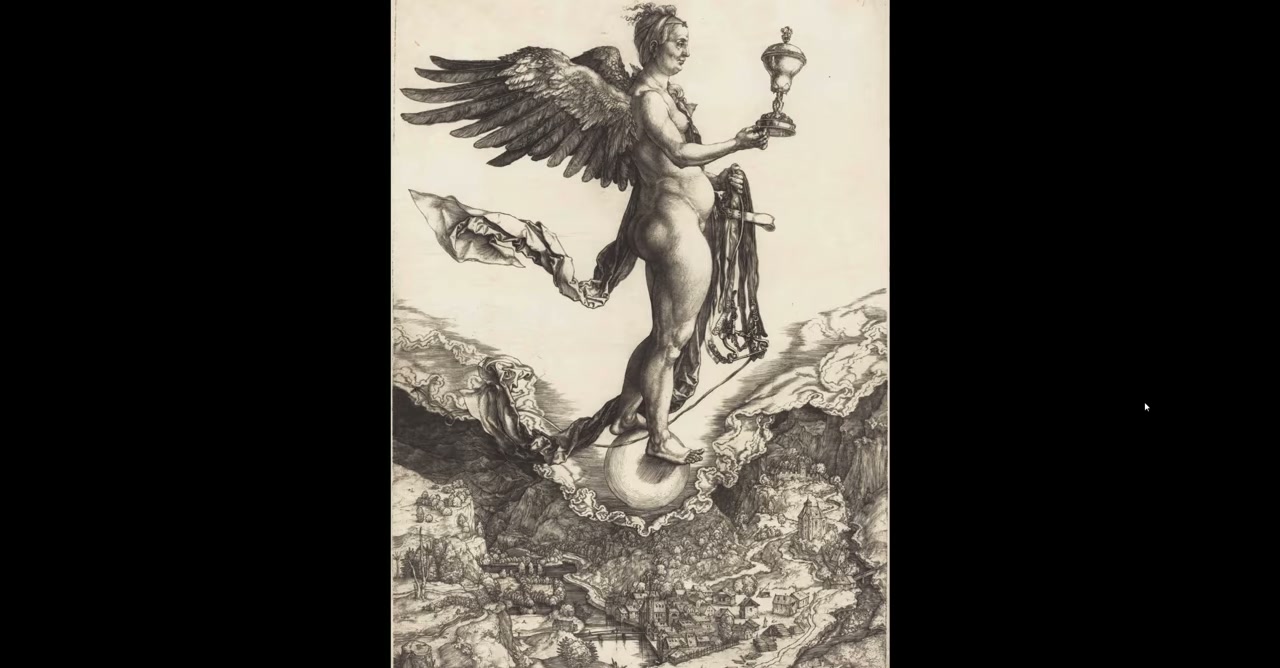
量より一貫性が重要です。 デューラーでは、密なハッチングのある版画だけを選びました。有名な野うさぎのような水彩画は、LoRAを別の方向に引っ張るので除外しました。
| LoRA | 画像数 | 選んだもの |
|---|---|---|
| アルブレヒト・デューラー | 10 | 濃いクロスハッチングの版画 |
| 北斎 | 約15 | 木版画 |
| ルノワール | 11 | 印象派の絵画 |
特徴の強いスタイルなら、5枚まで減らせます。
ステップ2:falでLoRAを学習する
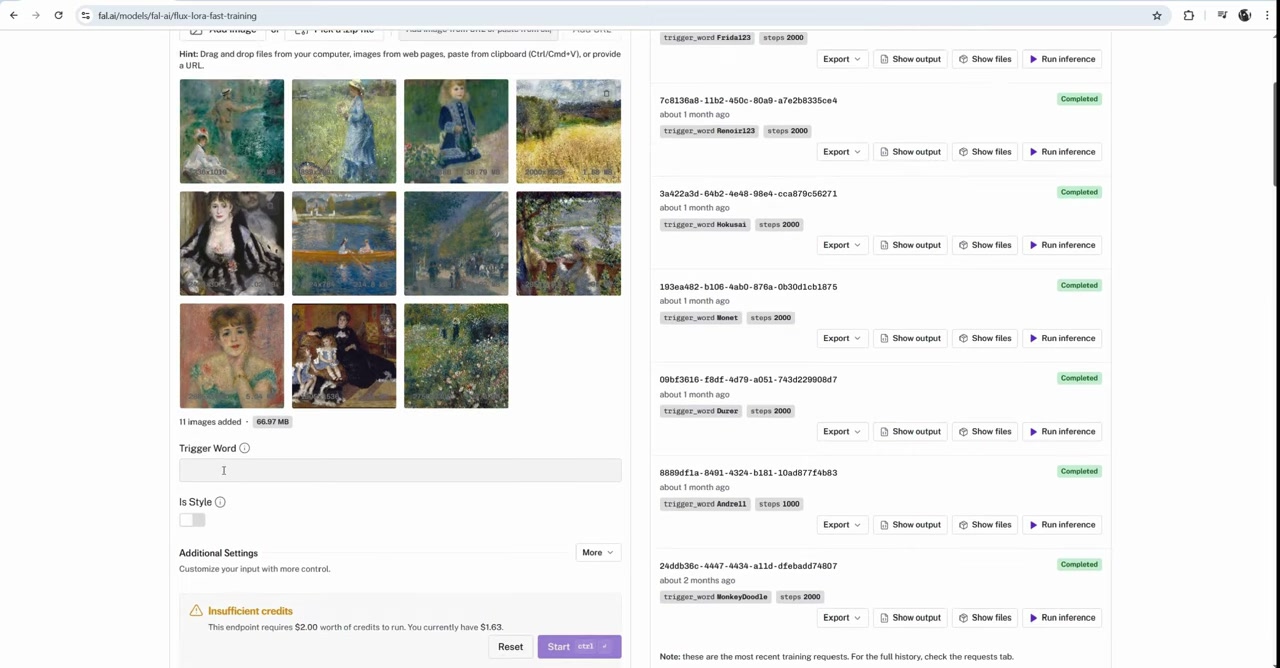
falでFlux LoRA Fast Trainingモデルを開きます。falにはFluxモデルがいくつかありますが、KontextやKreaなどの新しい派生は今回は使いません。この動画の収録時点ではControlNetに対応しておらず、後でポーズ制御ができなくなるからです。Flux dev用に学習します。
画像をドラッグして、次のオプションを設定します。
| 設定 | 私の設定 | 理由 |
|---|---|---|
| トリガーワード | renoir123 |
固有の語にして、Fluxが既知のものと混同しないようにする |
| Is style | オン | 人物ではなくスタイルだから |
| Masks | オフ | マスクは顔用 |
| Steps | デフォルト、または2,000 | 2,000ステップは品質が上がるがコストは倍の約4ドルになる |
Startをクリックします。学習は5〜10分で終わります。
私が犯したトリガーワードの失敗: 最初に試したのは、トリガーワードをmonetにしたクロード・モネのLoRAでした。うまくいきませんでした。「Monet」はFluxがすでに強い概念を持っている単語で、LoRAが主導権を取れなかったのです。monet123なら機能したはずです。トリガーワードを固有にするため、必ず数字や意味のない文字を付けてください。
ステップ3:ダウンロード、名前変更、インストール
学習が終わったら、Show filesを開いて、約85MBの.safetensorsファイルをダウンロードします。Safetensorsは、古い形式と違って実行可能コードを含められないため、モデルの重みを共有する標準的な形式です。
falはファイル名をpytorch_lora_weights.safetensorsにします。すぐに名前を変えてください。私はトリガーワードをファイル名に入れて、どの語がどのLoRAのものか調べなくて済むようにしています。
ComfyUI/models/loras/lora_renoir123.safetensorslorasフォルダに置く必要があり、そうでないとLoRAローダーが見つけられません。RunPod Podでは、JupyterLabからネットワークボリューム上の同じフォルダにアップロードします。
ステップ4:テストする
falには学習済みのLoRAの隣にRun inferenceボタンがあり、ComfyUIを触る前にテストできます。最初のプロンプトrenoir123, Darth Maul standing on a turtleでは、スタイルは出ましたがそれ以外はあまりでした。ヨーダに変えるとずっと良くなり、1枚あたり約4セントでした。
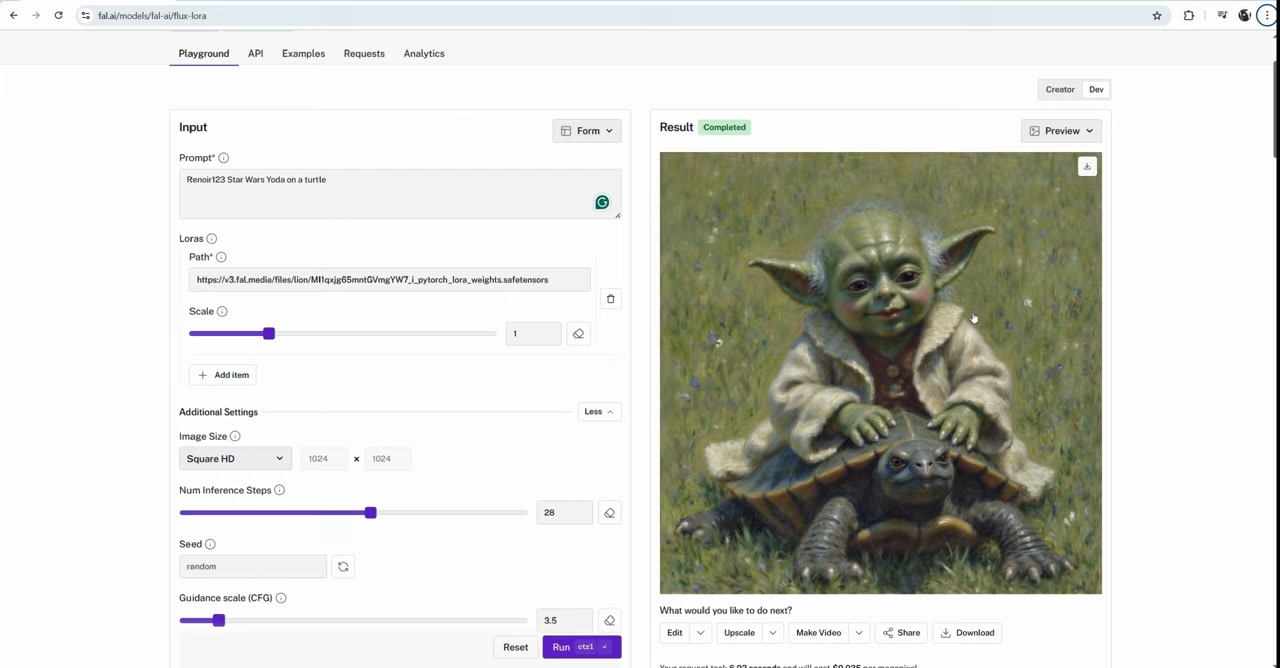
解像度が重要です。 Fluxは約1メガピクセル(1024 × 1024、falでは「square HD」)で最もよく機能します。512 × 512では細部が不足し、2Kや4Kの正方形に上げると、1Kより悪い画像になります。これがこれらのモデルの挙動です。
おまけとして、結果をfalの画像から動画へのモデルSeedance Liteに入れてみました。18セントとデフォルト設定で、ヨーダがカメの上で揺れる数秒の動画ができました。
ステップ5:ComfyUIでFlux + LoRAのワークフローを作る
これで学習は完了です。基本のComfyUIグラフは9つのノードで構成されます。それぞれの内容と私の設定は次のとおりです。
| ノード | 設定 | 備考 |
|---|---|---|
| Load Diffusion Model | flux1-dev |
約12GB。Model Managerからインストール |
| Load LoRA | lora_renoir123 |
models/lorasを読む |
| DualCLIPLoader | CLIP-L + T5 | Fluxが必要とする2つのテキストエンコーダー |
| Empty Latent Image | 1024 × 1024 | 出力解像度 |
| Flux Guidance | 3 | プロンプトの効き具合。高すぎると画像が焼ける |
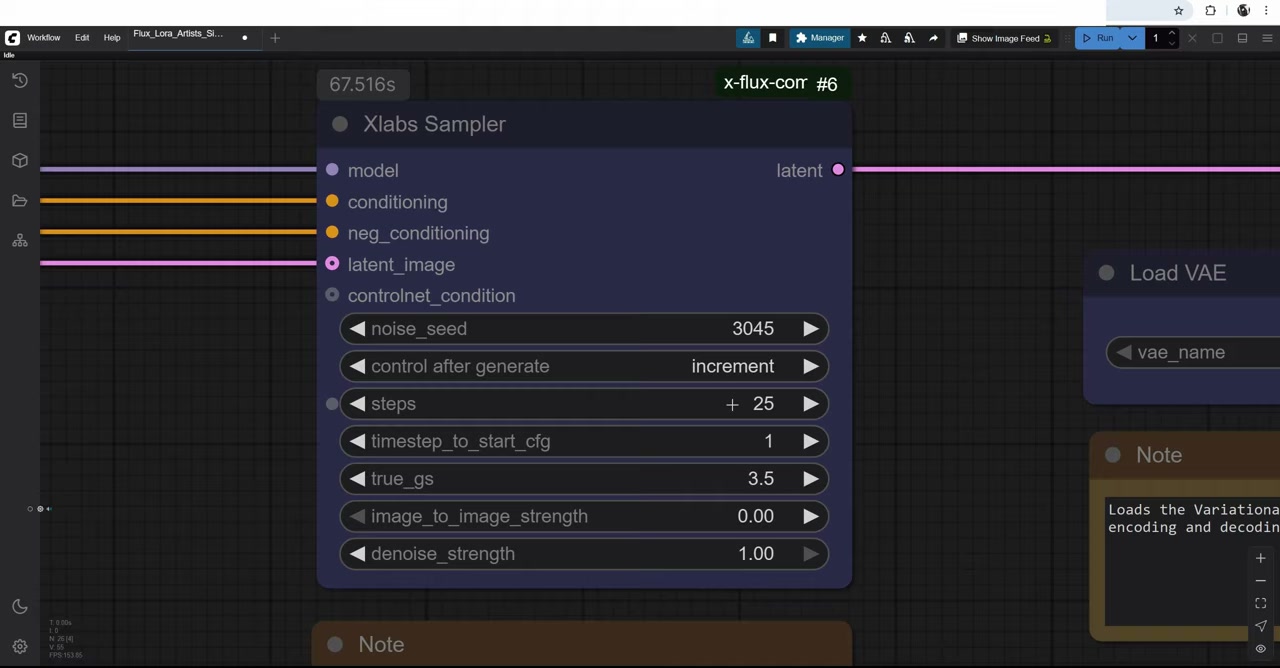
| XLabs Sampler | 25ステップ、シードはincrement | 20でも十分。50を超えると時間の無駄 |
| ネガティブプロンプト | 空 | Fluxはほぼ無視するが、接続は必要 |
| VAE Decode | FluxのVAE | 約300MB。潜在を画素に変換する |
| Image Save (WAS) | PNG、独自のプレフィックス | 標準のSaveノードよりファイル名を付けやすい |
ポジティブプロンプトの先頭にトリガーワードを入れます:renoir123, Star Wars, cooking cakes。シードをincrementにしておくと、これまでに生成した枚数も分かります。
ステップ6:何百ものプロンプトを自動で実行する
1枚ずつ生成するのは、ウェブサイトでやることです。ComfyUIの真価は、50個のプロンプトをキューに入れて寝られることにあります。ComfyUI Managerから入れられる3つのカスタムノードパックが必要です:ComfyUI Inspire Pack、WAS Node Suite、x-flux-comfyuiです。
1. プロンプトファイルを書く
ChatGPTにこの形式でスター・ウォーズのプロンプトを50個頼みました。Geminiでも同じようにできます。
positive: Star Wars art, Princess Leia, leading Rebel Alliance troops, holographic maps, determined faces
negative: blurry, cartoonish, scared, disheveled, empty room
---
positive: Star Wars art, Yoda, teaching young Jedi in a serene temple, ancient architecture
negative: blurry, cartoonish, chaotic, angry, noisy environment
形式は厳密です。
positive:とnegative:は小文字でなければなりません。- プロンプトは
---で区切ります。 - Fluxは無視しますが、ネガティブの行は空にできません。空だとグラフ全体が壊れます。
- チャットボットが先頭に付ける導入文は削除してください。
2. 機能する唯一のフォルダに置く
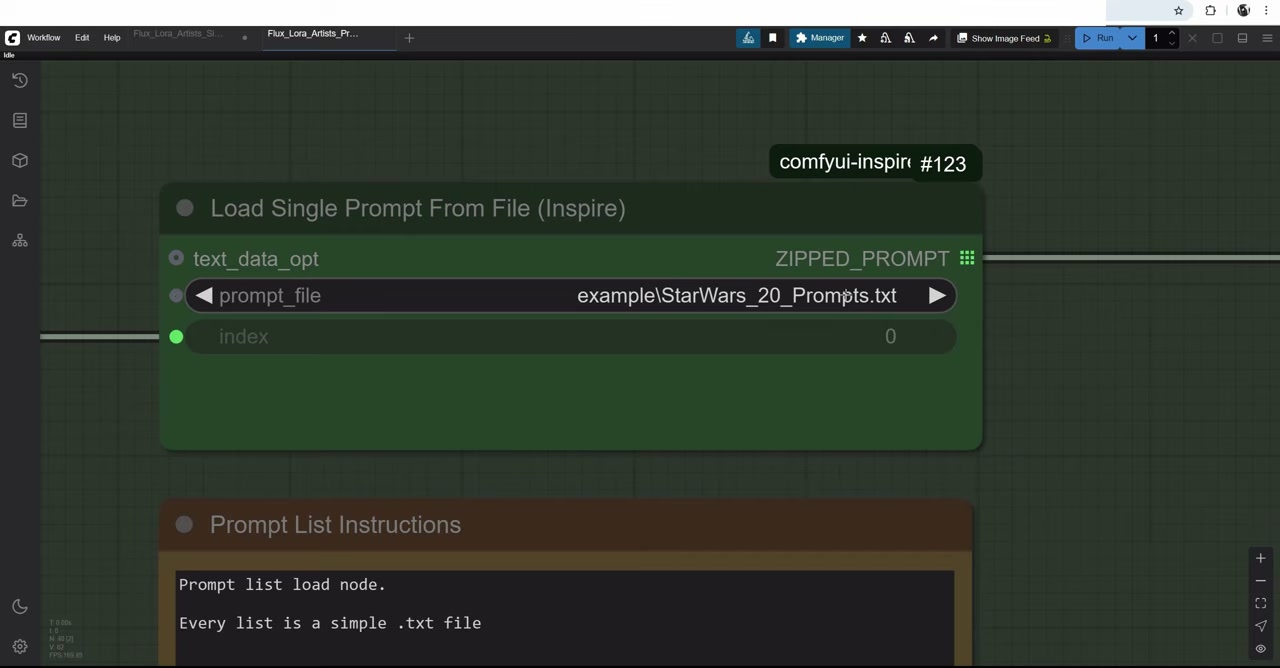
ファイルをComfyUI/custom_nodes/comfyui-inspire-pack/prompts/に保存します。Load Prompts From Fileノードは、そこしか見ません。
3. トリガーワードを追加する
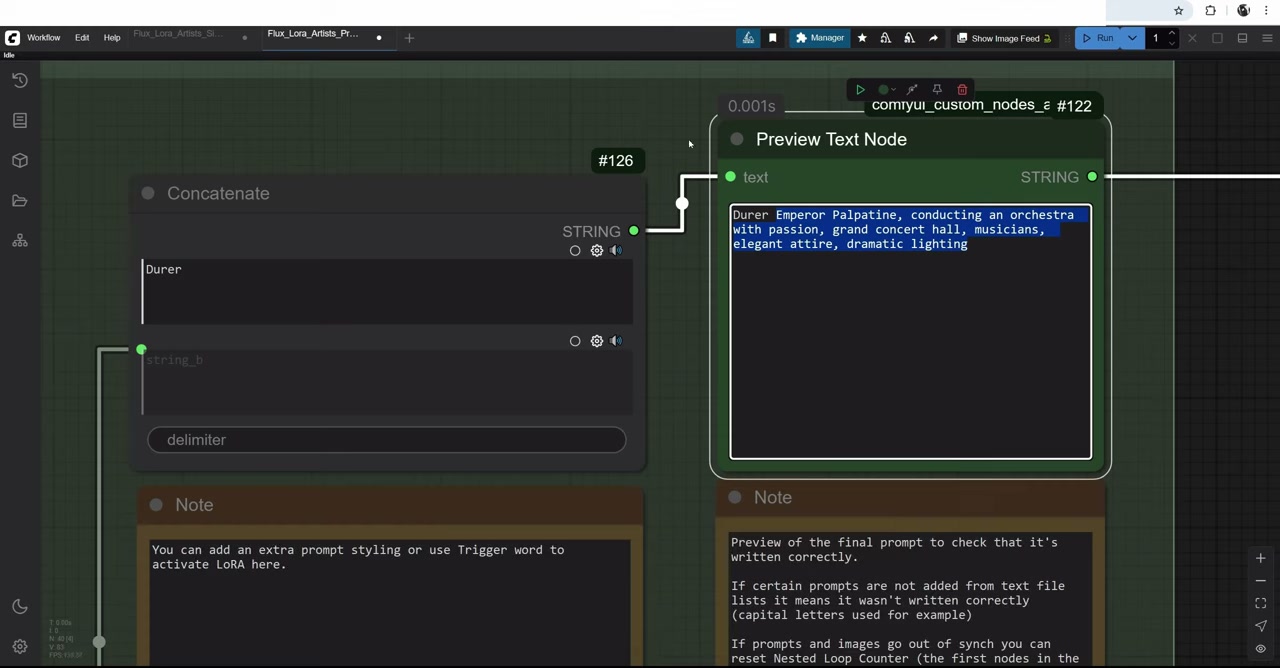
Concatenateノードですべてのプロンプトの前にトリガーワードを付けるので、スタイルを切り替えるときは1つのフィールドを変えるだけです。トリガーワードの後に空白を入れないと、プロンプトの最初の単語とくっついてしまいます。
4. 順番に回す
多くのチュートリアルが見落とす点ですが、プロンプトリストはそれだけでは最初のプロンプトしか実行しません。リストを順に進めるには、WAS Nested Loop Counterのインデックスを渡します。
- 最大値をファイル内のプロンプトの数に設定し、増分は1にします。
- プロンプトの数を数えてください。 チャットボットに50個頼むと、48個や49個になることがよくあります。私はファイル内の
positive:を検索して、その一致件数を使います。 - やり直すには、1回の実行だけresetをtrueにして、またfalseに戻します。カウンターは0から始まるので、50個のプロンプトは0から49まで実行されます。
プロンプトリストについては別の動画で詳しく説明しています。
5. 実行して離れる
キューを**Run (Instant)**にして放っておきます。夜間に生成した画像には、ひどいものも素晴らしいものもありました。AIの出力は誰もが選別するもので、コツは選別を安上がりにすることです。
生成結果
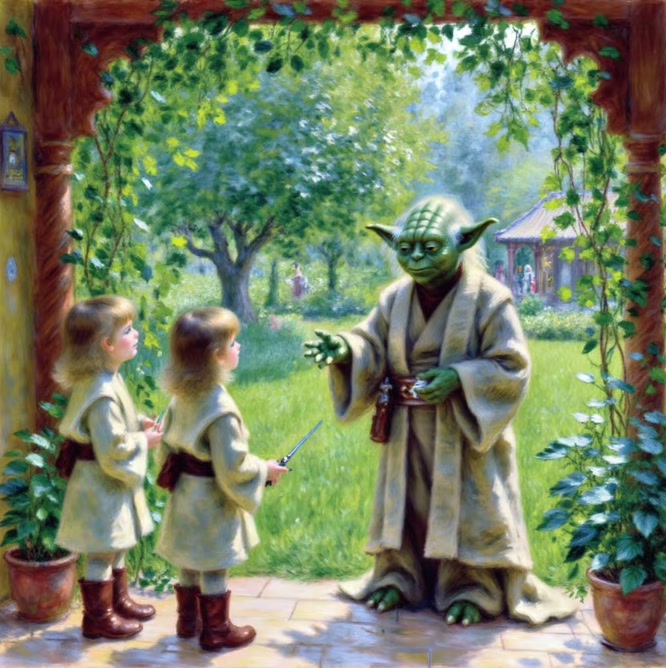
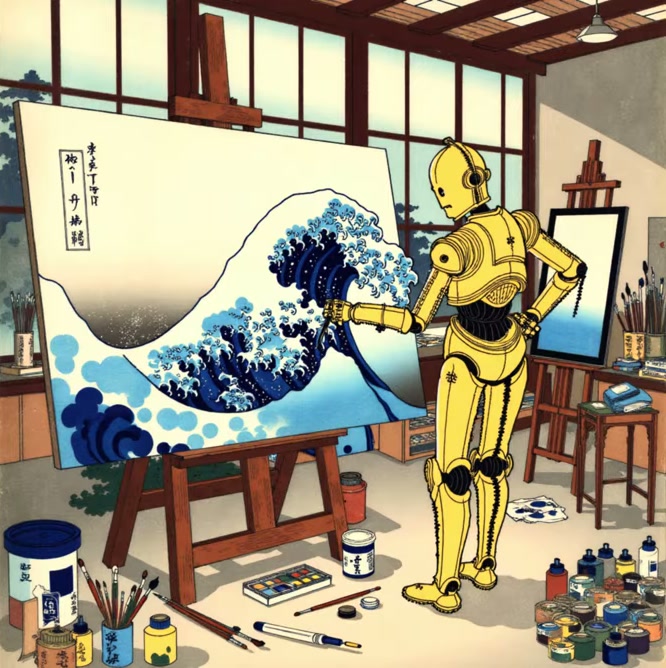
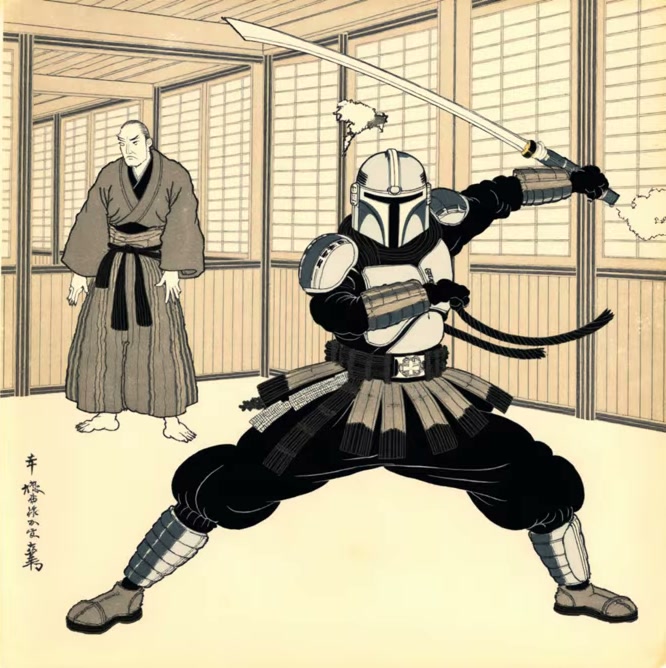
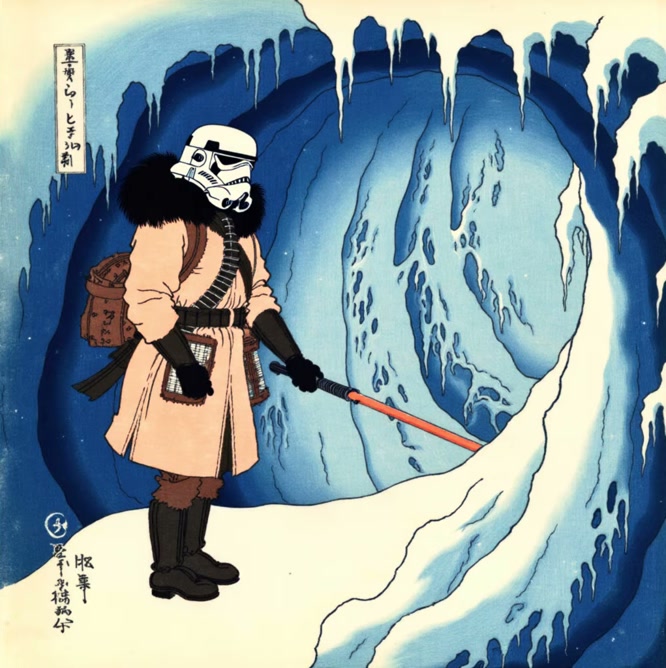
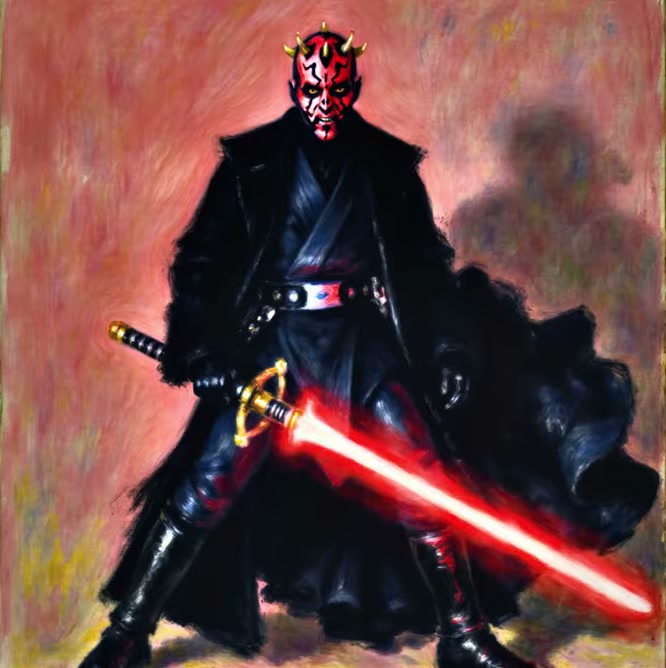
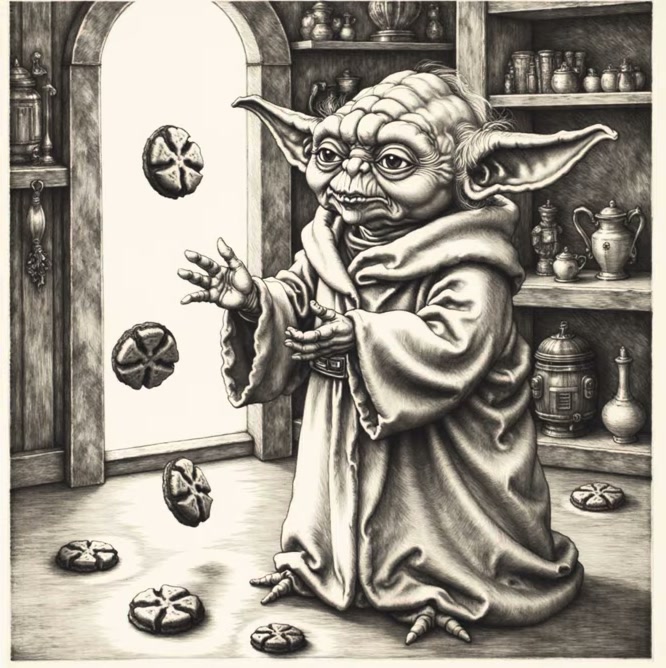
同じ夜間プロンプトリストから生成した、ルノワール、北斎、デューラーのLoRAです。
どこで実行するか
学習と実行は別の作業で、それぞれ別の場所を使っています。
| 作業 | 私の場所 | 費用 |
|---|---|---|
| LoRAの学習 | fal | LoRA1つあたり約2ドル |
| 簡単なテスト | fal | 1枚あたり約4¢ |
| ComfyUIでの夜間バッチ | 自分の12GB以上のGPU、またはクラウドGPU | 電気代、またはRunPodのRTX A5000で$0.27/時から |
この動画を撮影した頃、ComfyUIは自分のRTX A5000で動かしていました。その後RunPodに移行し、モデルはネットワークボリュームに置いて、バッチの間だけGPUを借りています。すでに12GB以上のカードがあるなら、ローカルで動かしてください。電気代以外は無料です。なければ、買うよりレンタルのほうがずっと安く済みます。RunPod入門で、セットアップ、費用、GPUの選び方を説明しています。
試してみたい方は、こちらが私のRunPod紹介リンクです。最初の10ドルの利用後に5〜500ドル分のクレジットを受け取れ(Googleでのサインアップ)、私には少額の紹介報酬が入ります。
避けたい失敗
- 一般的なトリガーワード。
monetは失敗し、monet123は機能します。 - 学習セットでのスタイルの混在。 一貫した10枚は、混ざった30枚に勝ります。
- 解像度の間違い。 約1メガピクセルを守ってください。
- guidanceが高すぎる。 約3を超えると画像が焼け始めます。
- LoRAを間違ったフォルダに置く。
models/lorasに置く必要があります。 - 壊れたプロンプトファイル。 大文字、空のネガティブ行、間違ったフォルダがあるとグラフが止まります。
- ループ回数の不一致。 プロンプトの数は自分で数えてください。
著作権について
デューラー、北斎、ルノワールの著作権はとうに切れています。存命の画家は別です。私は友人たちのスタイルで、許可を得てLoRAを学習し、結果を見せて、非公開にしました。まず尋ねてください。なお、ここでスター・ウォーズのキャラクターを使ったのは楽しみのためで、販売するものではありません。
LoRAとプロンプトリストのワークフロー、そして私の3つの画家LoRAは、Patreonにあります。
動画版を見る (19:53)
上の内容はすべて動画でも説明しています。画面を見ながら進めたい方はこちらをどうぞ。 動画は英語です。
よくある質問
LoRAの学習には何枚の画像が必要ですか?
スタイルLoRAなら、一貫したスタイルの画像が6〜15枚です。特徴の強いスタイルなら5枚でも機能することがあります。
LoRAの学習にはいくらかかりますか?
falでデフォルトのステップ数なら約2ドル、2,000ステップなら約4ドルです。テストは1枚あたり約4セントです。
LoRAの学習にはどのくらい時間がかかりますか?
falでスタイルLoRAなら5〜10分です。
FluxのLoRAを使うにはどのGPUが必要ですか?
Flux devを快適に動かすには約12GBのVRAMが必要です。カードが小さい場合は、RTX A5000などのクラウドGPUが使えます。
トリガーワードとは何ですか?
LoRAをオンにするためにプロンプトへ加える固有の単語です。renoir123のように、Fluxが見たことのないものにして、実在の名前は避けてください。

Anton Tenitsky は コンピュータグラフィックスで15年以上の経験を持つ3Dアーティストで、Nickelodeon、Gameloft、Marvel Rivalsをはじめ多くのクライアントと仕事をしてきました。 プロフィールを見る