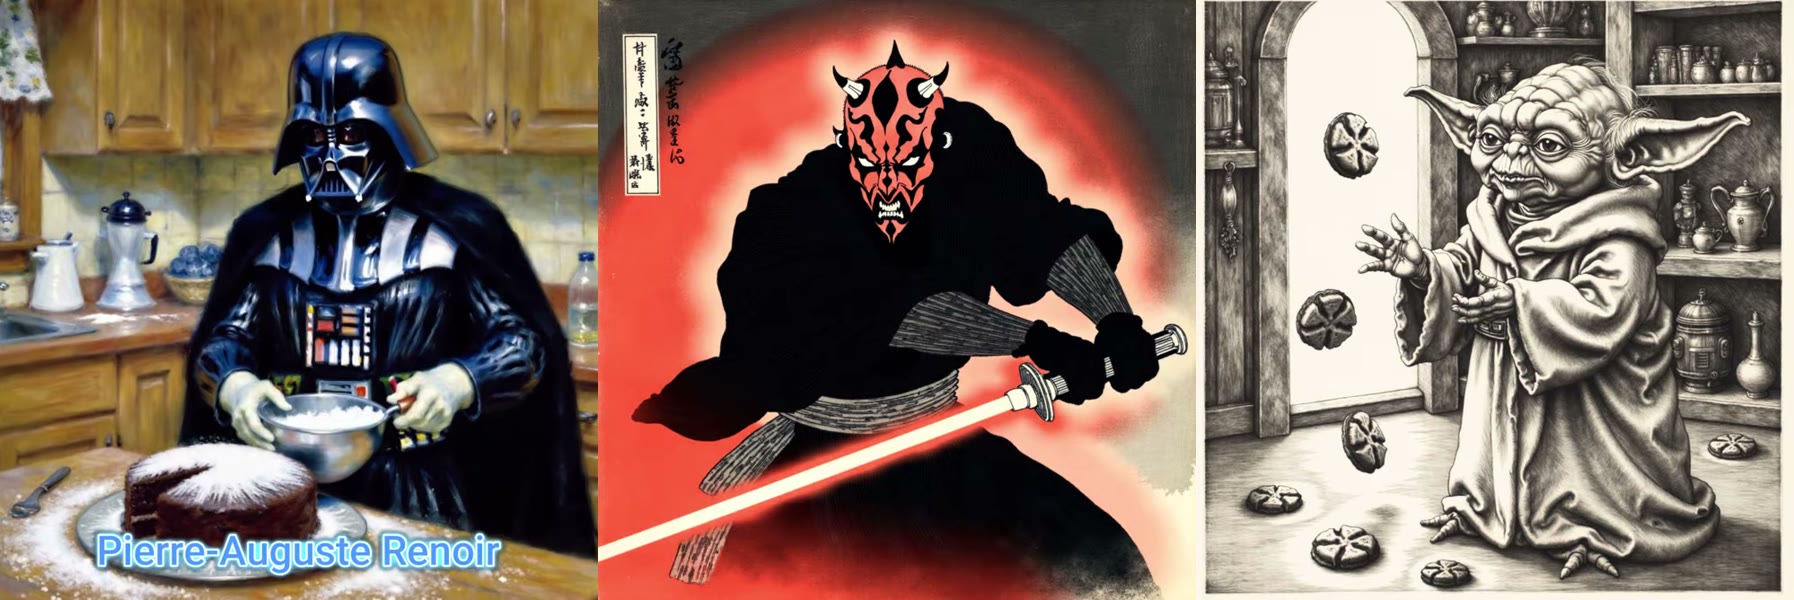
Flux weiß ein bisschen über alles. Es wurde mit Milliarden von Bildern trainiert; bittest du es also um „einen Kupferstich“, bekommst du etwas Kupferstichartiges. Bittest du es um Albrecht Dürers spezielle Kreuzschraffur, rät es.
Ein LoRA behebt das. Es ist ein kleines Zusatzmodell, trainiert mit einer Handvoll Bildern, das Flux in Richtung eines bestimmten Stils, Charakters oder Looks schiebt. Ein Training braucht eine Handvoll Bilder, ein paar Minuten und ein paar Dollar.
In Teil 1 trainiere ich drei Künstlerstil-LoRAs: Renoirs Impressionismus, Hokusais Holzschnitte und Dürers Kupferstiche. In Teil 2 baue ich einen ComfyUI-Workflow, der von allein Hunderte Prompts durchläuft.
Kurz gefasst
- Ein Stil-LoRA braucht nur 6–15 Bilder in einem einheitlichen Stil.
- Das Training auf fal kostet etwa 2 $ und dauert 5–10 Minuten.
- Nimm ein erfundenes Trigger-Wort wie
renoir123, niemals ein echtes Wort. - Generiere mit etwa 1 Megapixel, Flux Guidance 3, 20–25 Schritten.
- Eine Prompt-Liste und ein Loop Counter lassen ComfyUI 50+ Prompts unbeaufsichtigt abarbeiten.
Was ist ein LoRA?
LoRA steht für Low-Rank Adaptation, eine Technik, die in einer Arbeit von Hu et al. aus dem Jahr 2021 vorgestellt wurde. Statt ein ganzes Modell neu zu trainieren, trainierst du einen kleinen Satz zusätzlicher Gewichte, die darauf aufsetzen und steuern, was es erzeugt. Wenn du die Idee ohne Mathematik möchtest, ist dieser Medium-Beitrag eine gute Lektüre.
In der Praxis heißt das:
- Die Datei ist klein. Meine Flux-Stil-LoRAs sind etwa 85 MB groß. Flux dev selbst hat rund 12 GB.
- Das Training ist günstig und schnell: ein paar Dollar und ein paar Minuten.
- Du kannst sie austauschen. Ein Basismodell, so viele LoRAs, wie du willst.
Es gibt zwei gängige Arten. Ein Charakter-LoRA lernt eine Person oder ein Gesicht, oft das eigene. Ein Stil-LoRA lernt einen Look: Pinselführung, Linie, Palette. Ein Stil kann alles sein, von malerischem Realismus bis zu etwas so Flachem und Sauberem wie South Park, wobei ich urheberrechtlich geschützte Stile für alles, was du veröffentlichst, meiden würde. Dieser Leitfaden behandelt Stil-LoRAs, die nachsichtiger sind: keine Gesichtsmasken, keine sorgfältigen Bildunterschriften.
Was du brauchst
- 6–15 Bilder in einem einzigen, einheitlichen Stil.
- Ein fal.ai-Konto mit ein paar Dollar Guthaben. Ich habe 10 $ aufgeladen und damit mehrere LoRAs trainiert.
- ComfyUI mit Flux dev für Teil 2.
- Etwa 12 GB VRAM, um Flux gut auszuführen, lokal oder auf einer Cloud-GPU.
Ich trainiere LoRAs nicht lokal. Es dauert viel länger, und ein Durchlauf kann auf halbem Weg scheitern. Auf fal kostet ein LoRA etwa 2 $ und ist in Minuten fertig.
Schritt 1: Trainingsbilder sammeln
Für Alte Meister sind Wikipedia und Wikimedia Commons die besten Quellen: hochauflösende Scans, meist gemeinfrei.
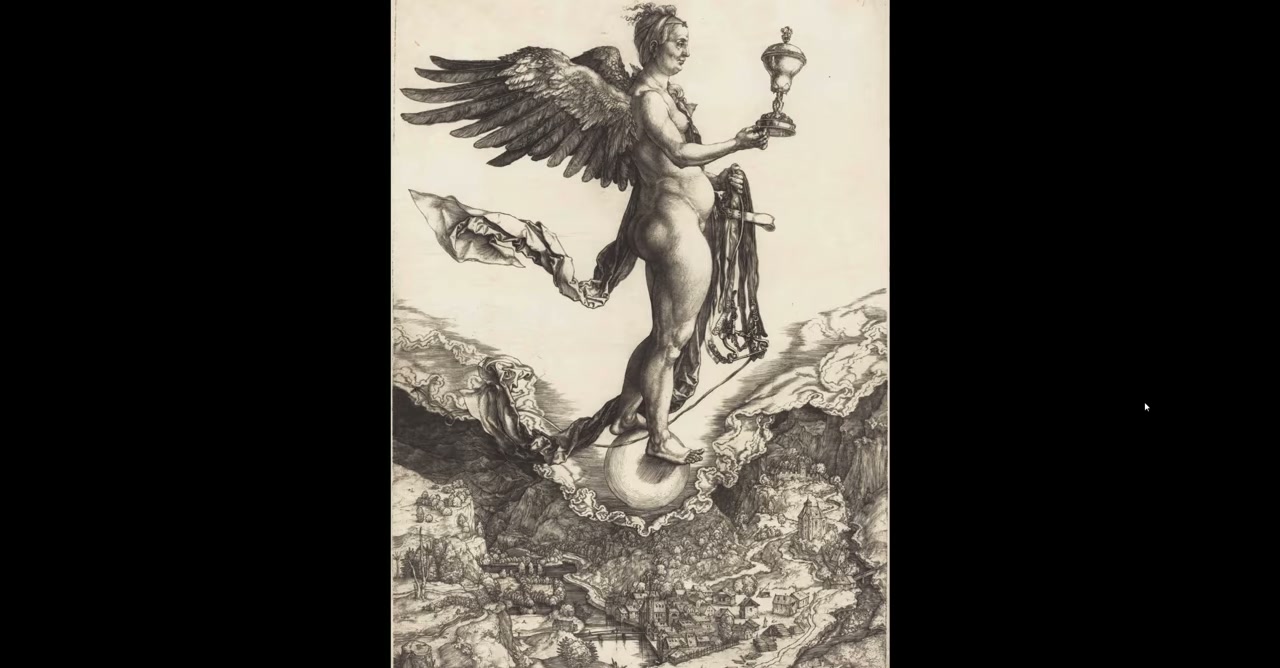
Einheitlichkeit ist wichtiger als Menge. Für Dürer habe ich nur Kupferstiche mit seiner dichten Schraffur ausgewählt. Seine Aquarelle, wie den berühmten Feldhasen, habe ich übersprungen, weil sie das LoRA in eine andere Richtung ziehen würden.
| LoRA | Bilder | Was ich ausgewählt habe |
|---|---|---|
| Albrecht Dürer | 10 | Kupferstiche mit starker Kreuzschraffur |
| Hokusai | etwa 15 | Holzschnitte |
| Renoir | 11 | Impressionistische Gemälde |
Für einen starken, markanten Stil kannst du bis auf fünf Bilder heruntergehen.
Schritt 2: Das LoRA auf fal trainieren
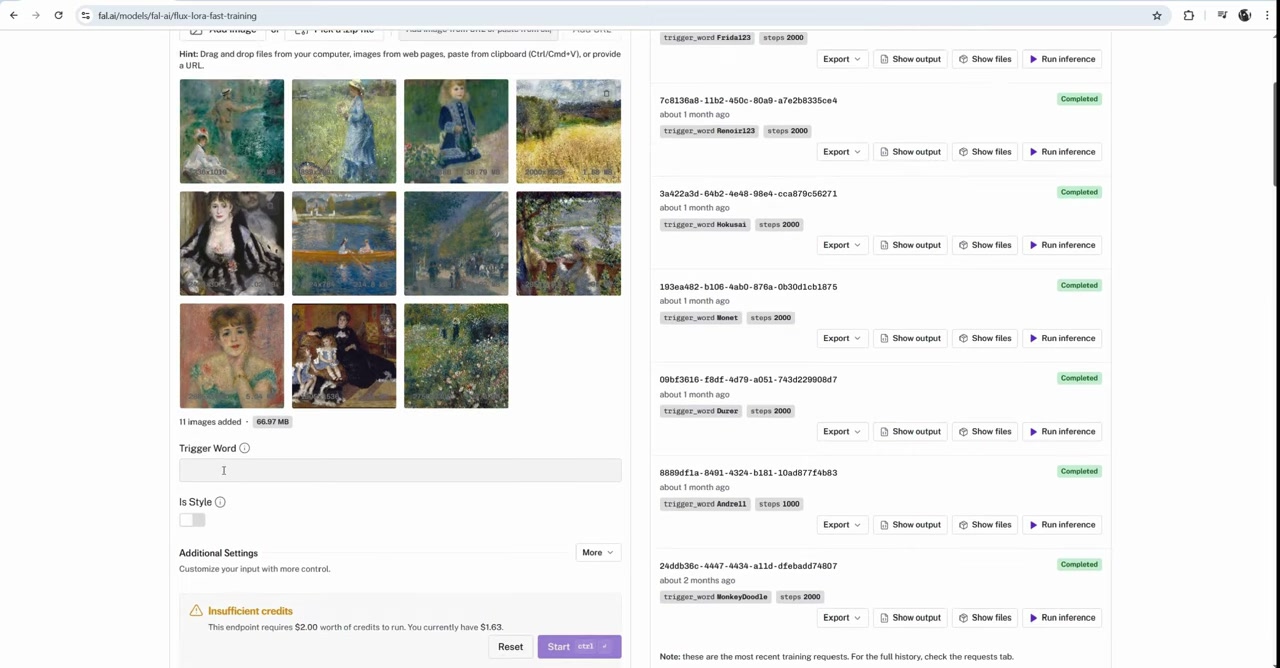
Öffne auf fal das Modell Flux LoRA Fast Training. Auf fal gibt es mehrere Flux-Modelle; lass die neueren Varianten wie Kontext und Krea hierfür aus. Als ich das aufgenommen habe, unterstützten sie ControlNet nicht, du würdest also später die Posenkontrolle verlieren. Trainiere für Flux dev.
Ziehe deine Bilder hinein und stelle diese Optionen ein:
| Einstellung | Was ich nutze | Warum |
|---|---|---|
| Trigger-Wort | renoir123 |
Einzigartig, damit Flux es nicht mit etwas verwechseln kann, das es schon kennt |
| Is style | An | Es ist ein Stil, keine Person |
| Masks | Aus | Masken sind für Gesichter |
| Steps | Standard oder 2.000 | 2.000 Schritte ergeben bessere Qualität, verdoppeln aber die Kosten auf etwa 4 $ |
Klicke auf Start. Das Training dauert 5–10 Minuten.
Der Fehler mit dem Trigger-Wort, den ich gemacht habe: Mein erster Versuch war ein Claude-Monet-LoRA mit dem Trigger-Wort monet. Es hat nicht funktioniert. „Monet“ ist ein Wort, zu dem Flux bereits starke Vorstellungen hat, sodass das LoRA nicht übernehmen konnte. monet123 hätte funktioniert. Hänge immer Zahlen oder Unsinn an, damit das Trigger-Wort einzigartig wird.
Schritt 3: Herunterladen, umbenennen und installieren
Wenn das Training fertig ist, öffne Show files und lade die .safetensors-Datei herunter, etwa 85 MB. Safetensors ist das Standardformat zum Teilen von Modellgewichten, weil es im Gegensatz zu älteren Formaten keinen ausführbaren Code enthalten kann.
fal nennt die Datei pytorch_lora_weights.safetensors. Benenne sie sofort um. Ich setze das Trigger-Wort in den Dateinamen, damit ich nie nachschlagen muss, welches Wort zu welchem LoRA gehört:
ComfyUI/models/loras/lora_renoir123.safetensorsSie muss in den Ordner loras, sonst sieht der LoRA-Loader sie nicht. Auf einem RunPod-Pod lädst du sie über JupyterLab in denselben Ordner auf deinem Network Volume hoch.
Schritt 4: Testen
fal hat neben deinem trainierten LoRA eine Schaltfläche Run inference, sodass du testen kannst, bevor du ComfyUI anfasst. Mein erster Prompt, renoir123, Darth Maul standing on a turtle, ergab den Stil, aber nicht viel mehr. Mit Yoda lief es viel besser, bei etwa 4 Cent pro Bild.
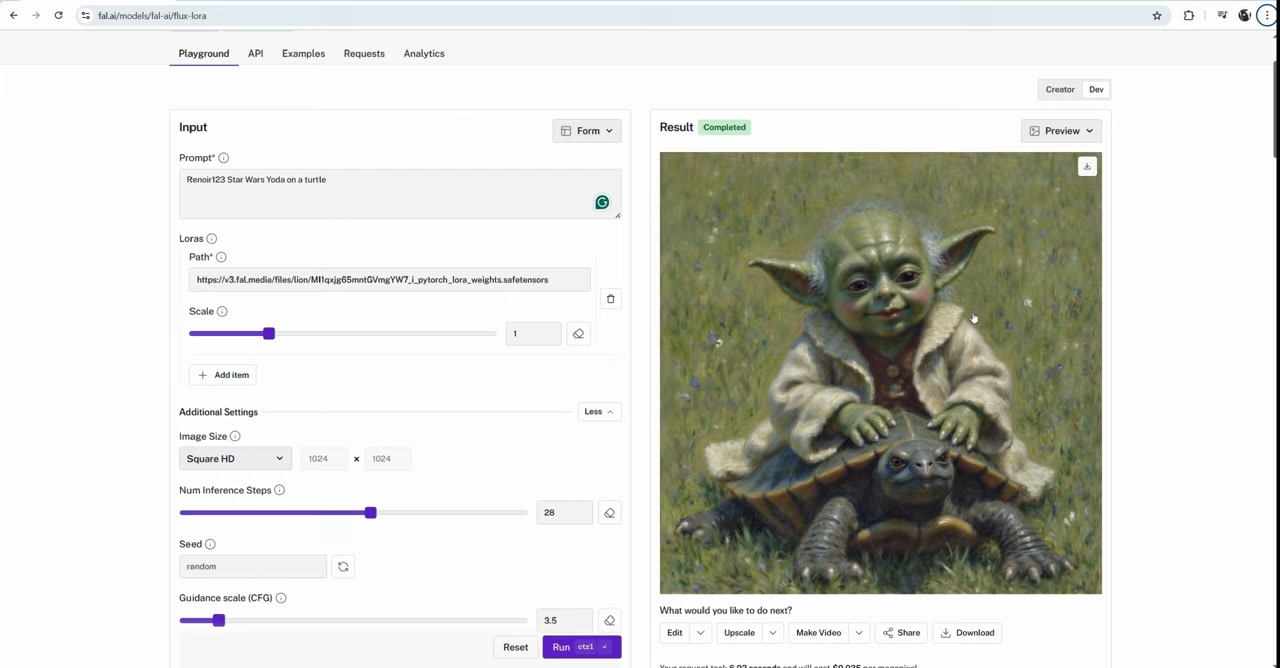
Die Auflösung zählt. Flux funktioniert am besten bei etwa 1 Megapixel: 1024 × 1024, bei fal „square HD“. 512 × 512 ist zu klein für gute Details, und wer auf 2K- oder 4K-Quadrate hochgeht, bekommt schlechtere Bilder als bei 1K. So verhalten sich diese Modelle eben.
Zum Spaß habe ich das Ergebnis in ein Bild-zu-Video-Modell gesteckt, Seedance Lite, ebenfalls auf fal. Für 18 Cent und Standardeinstellungen bekam ich ein paar Sekunden, in denen Yoda auf seiner Schildkröte schwankt.
Schritt 5: Den Flux-+-LoRA-Workflow in ComfyUI bauen
Das Training ist damit erledigt. Der einfache ComfyUI-Graph besteht aus neun Nodes. Hier ist jeder einzelne und wie ich ihn einstelle:
| Node | Einstellung | Hinweise |
|---|---|---|
| Load Diffusion Model | flux1-dev |
Etwa 12 GB; installiere es über den Model Manager |
| Load LoRA | lora_renoir123 |
Liest models/loras |
| DualCLIPLoader | CLIP-L + T5 | Die beiden Text-Encoder, die Flux braucht |
| Empty Latent Image | 1024 × 1024 | Deine Ausgabeauflösung |
| Flux Guidance | 3 | Wie stark der Prompt drückt. Zu hoch verbrennt das Bild |
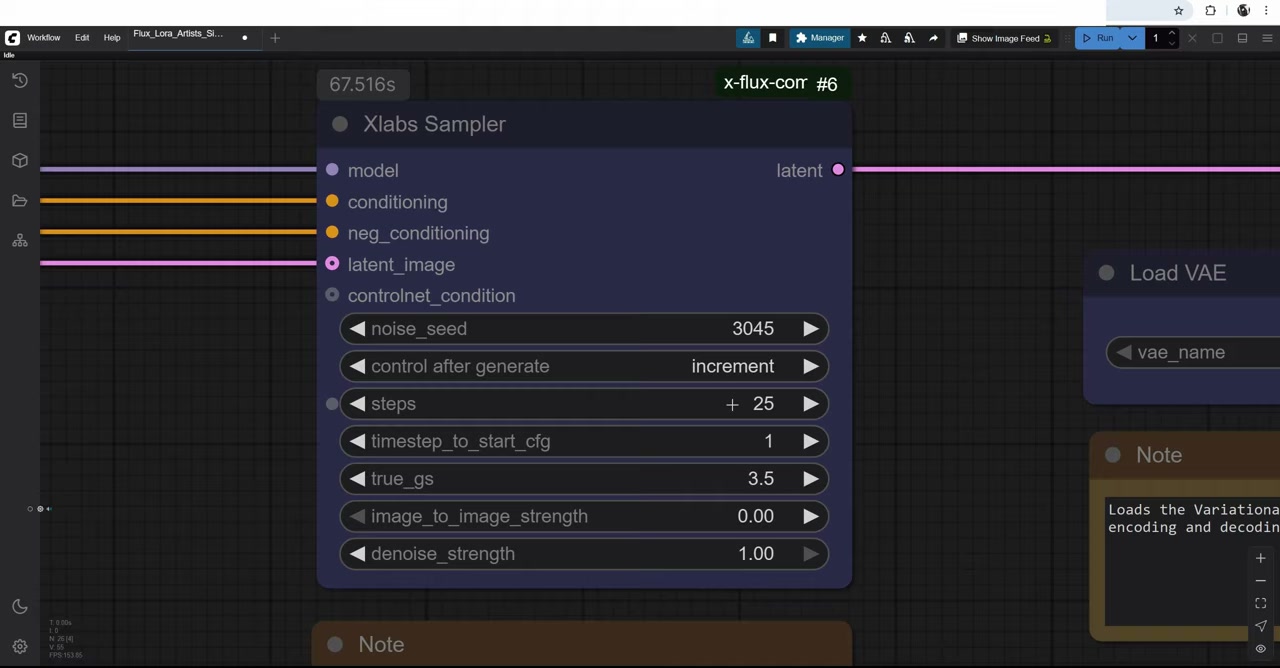
| XLabs Sampler | 25 Schritte, Seed auf increment | 20 ist auch in Ordnung. Alles über 50 ist verschwendete Zeit |
| Negativer Prompt | Leer | Flux ignoriert ihn weitgehend, aber er muss verbunden sein |
| VAE Decode | Flux-VAE | Etwa 300 MB; wandelt das Latent in Pixel um |
| Image Save (WAS) | PNG, eigenes Präfix | Einfachere Dateibenennung als der Standard-Save-Node |
Setze das Trigger-Wort an den Anfang deines positiven Prompts: renoir123, Star Wars, cooking cakes. Wenn du den Seed auf increment stellst, bekommst du außerdem eine fortlaufende Zählung, wie viele Bilder du gemacht hast.
Schritt 6: Hunderte Prompts automatisch ausführen
Ein Bild nach dem anderen zu machen ist das, was man auf einer Website tun würde. ComfyUI zahlt sich aus, wenn du 50 Prompts einreihst und schlafen gehst. Du brauchst drei Custom-Node-Pakete, alle über den ComfyUI Manager installierbar: ComfyUI Inspire Pack, WAS Node Suite und x-flux-comfyui.
1. Die Prompt-Datei schreiben
Ich habe ChatGPT um 50 Star-Wars-Prompts in genau diesem Format gebeten. Gemini funktioniert genauso gut:
positive: Star Wars art, Princess Leia, leading Rebel Alliance troops, holographic maps, determined faces
negative: blurry, cartoonish, scared, disheveled, empty room
---
positive: Star Wars art, Yoda, teaching young Jedi in a serene temple, ancient architecture
negative: blurry, cartoonish, chaotic, angry, noisy environment
Das Format ist streng:
positive:undnegative:müssen kleingeschrieben sein.- Prompts werden durch
---getrennt. - Die negative Zeile darf nicht leer sein, auch wenn Flux sie ignoriert. Eine leere zerstört den ganzen Graphen.
- Lösche jede Einleitungszeile, die der Chatbot oben hinzufügt.
2. In den einen Ordner legen, der funktioniert
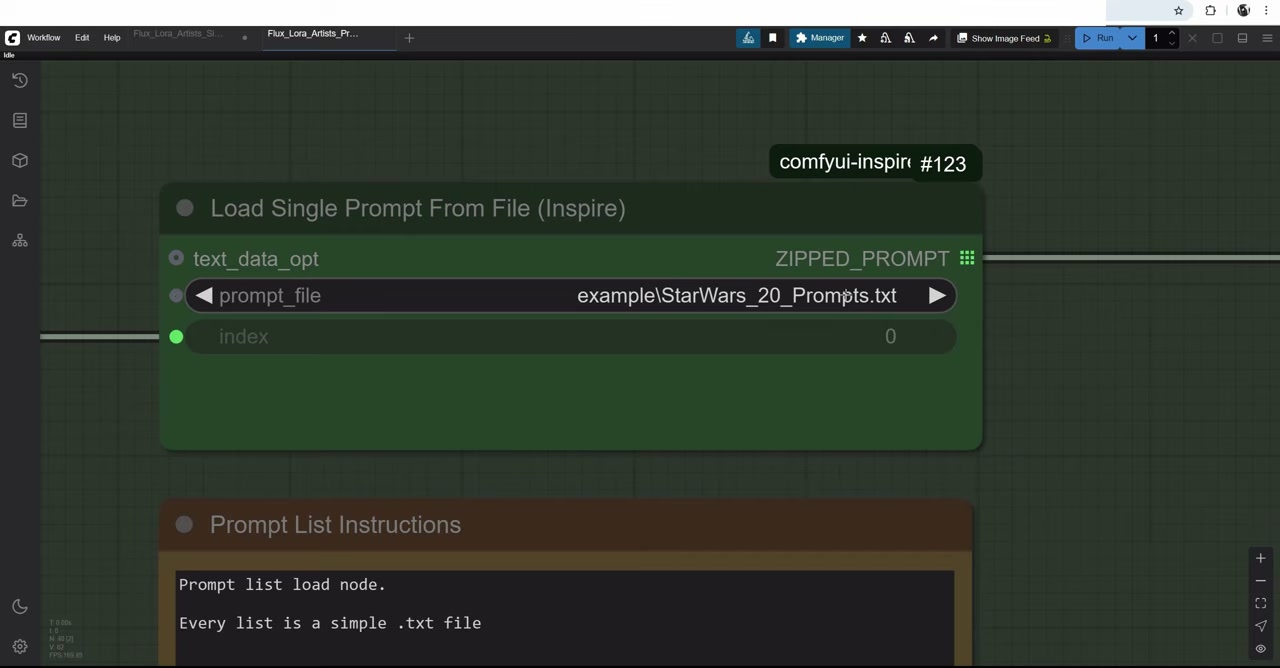
Speichere die Datei unter ComfyUI/custom_nodes/comfyui-inspire-pack/prompts/. Der Node Load Prompts From File schaut nur dort nach.
3. Das Trigger-Wort hinzufügen
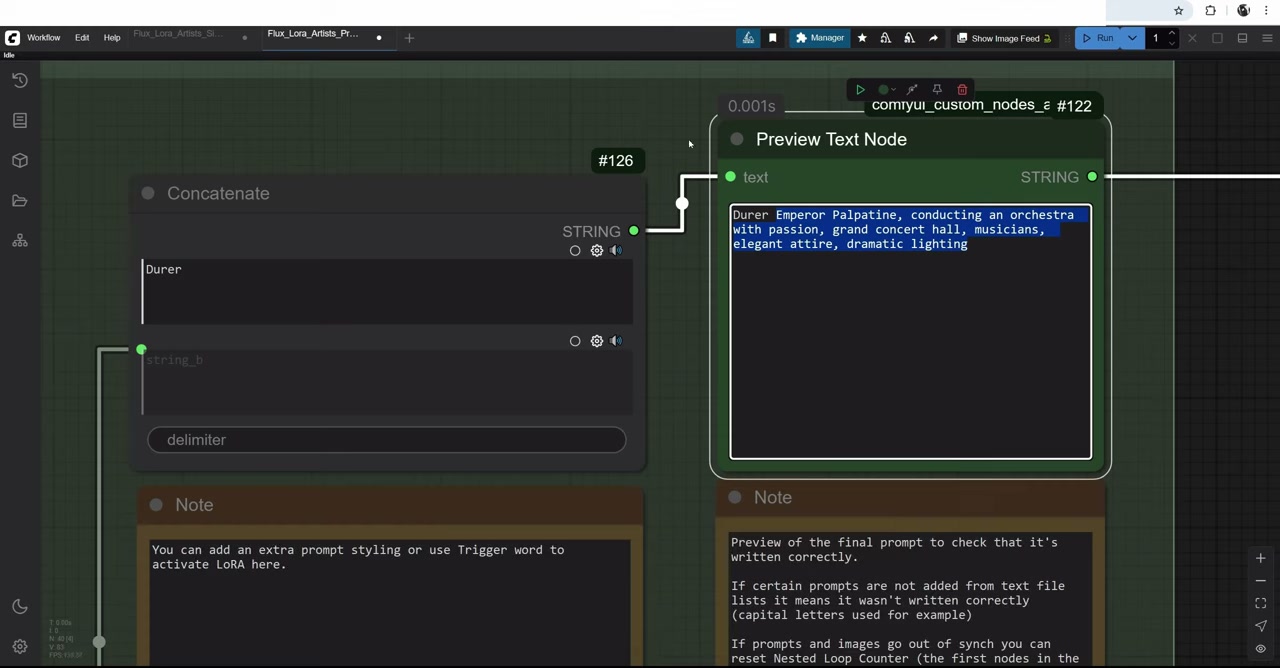
Ein Concatenate-Node setzt das Trigger-Wort vor jeden Prompt, sodass du zum Wechseln des Stils nur ein Feld ändern musst. Lass nach dem Trigger-Wort ein Leerzeichen, sonst klebt es am ersten Wort des Prompts.
4. Es zum Durchlaufen bringen
Hier der Teil, den die meisten Tutorials auslassen: Für sich allein führt die Prompt-Liste immer nur den ersten Prompt aus. Um die Liste durchzugehen, füttere sie mit dem Index eines WAS Nested Loop Counter:
- Setze das Maximum auf die Anzahl der Prompts in deiner Datei, mit einem Inkrement von 1.
- Zähle deine Prompts. Bittest du einen Chatbot um 50, bekommst du oft 48 oder 49. Ich suche in der Datei nach
positive:und nehme die Trefferzahl. - Um von vorn zu beginnen, setze reset für einen Durchlauf auf true, dann zurück auf false. Der Zähler beginnt bei 0, also laufen 50 Prompts von 0 bis 49.
Mit Prompt-Listen befasse ich mich ausführlicher in einem separaten Video.
5. Ausführen und weggehen
Stelle die Warteschlange auf Run (Instant) und lass sie laufen. Einige meiner Bilder über Nacht waren furchtbar, andere großartig. Jeder sucht sich KI-Ausgaben aus; der Trick ist, das Aussuchen billig zu machen.
Was dabei herauskam
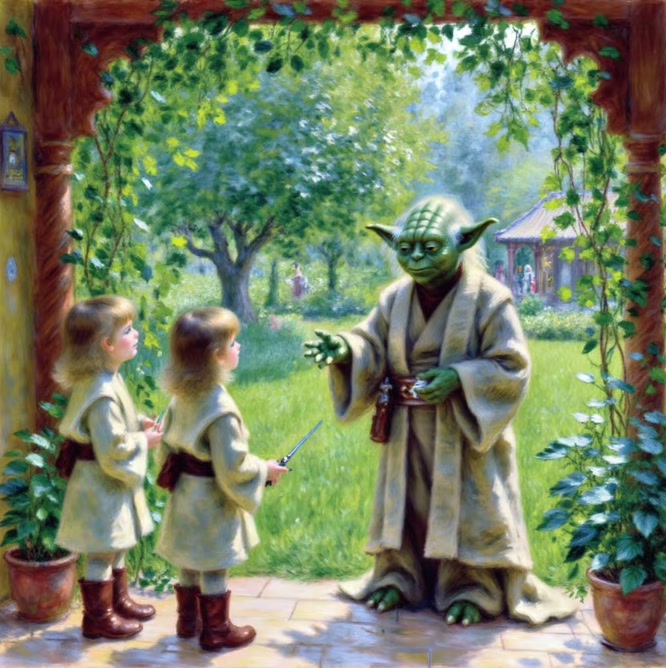
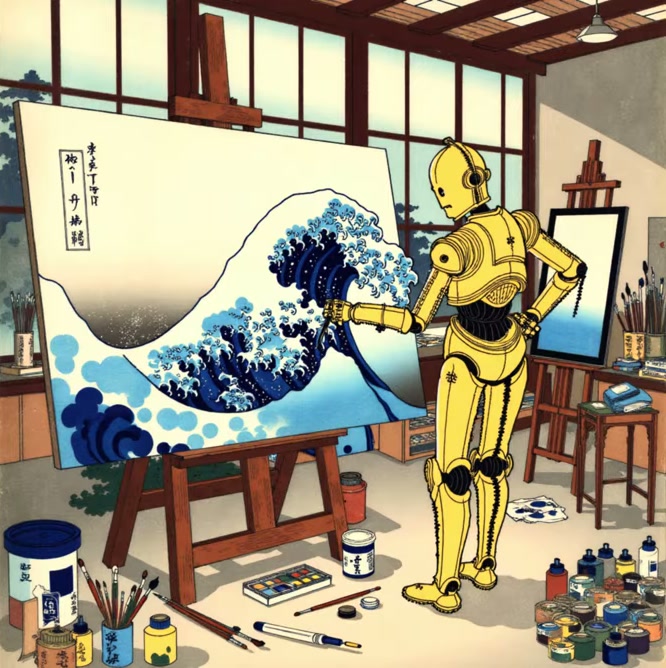
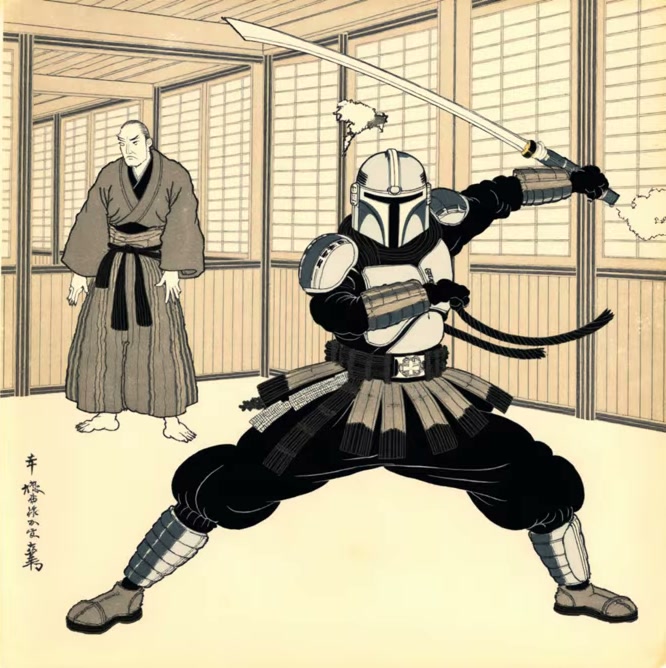
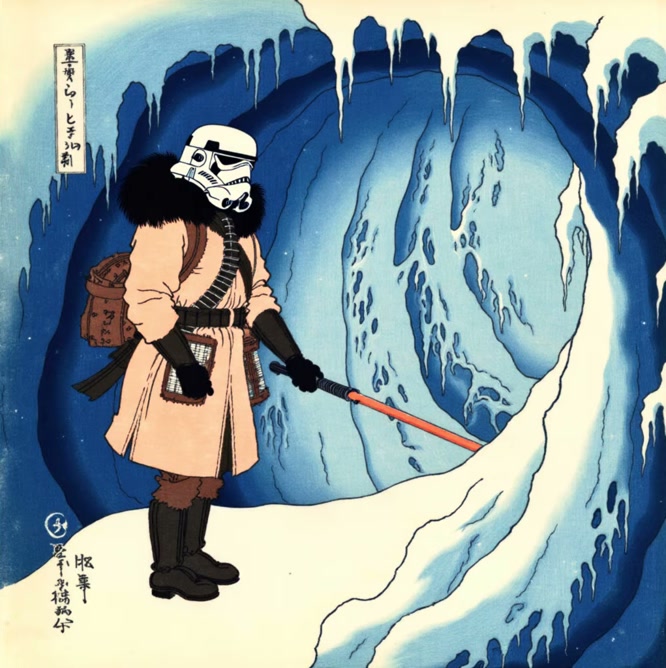
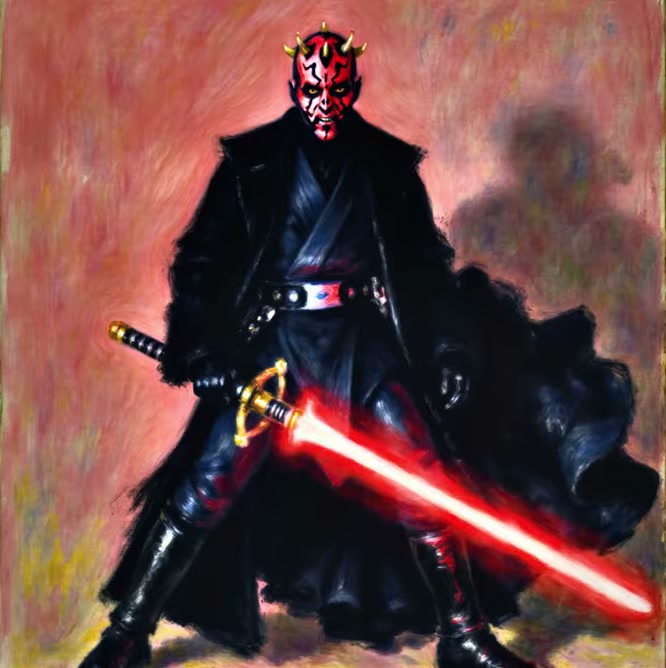
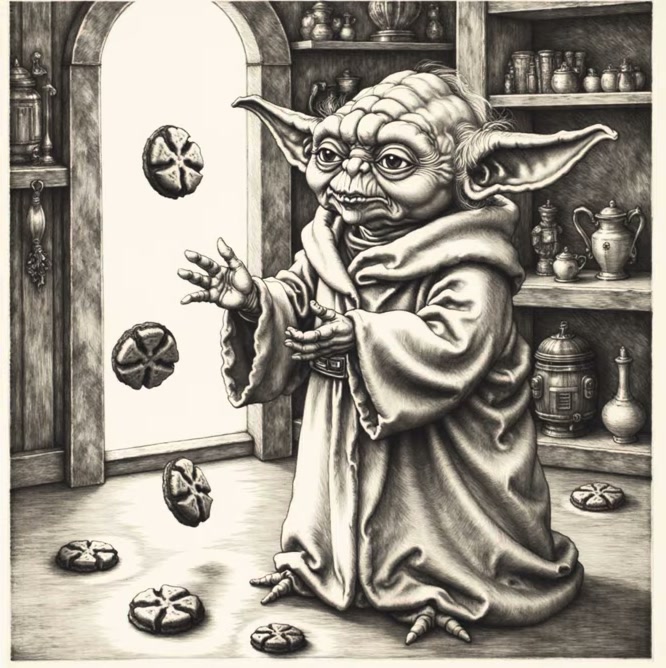
Renoir-, Hokusai- und Dürer-LoRAs, aus derselben Prompt-Liste über Nacht.
Wo du es ausführst
Training und Ausführung sind zwei verschiedene Aufgaben, und ich nutze für jede einen anderen Ort:
| Aufgabe | Wo ich sie erledige | Kosten |
|---|---|---|
| Das LoRA trainieren | fal | Etwa 2 $ pro LoRA |
| Schnelle Tests | fal | Etwa 4 ¢ pro Bild |
| Batches über Nacht in ComfyUI | Deine eigene GPU mit 12 GB+ oder eine Cloud-GPU | Strom, oder ab 0,27 $/Std. für eine RTX A5000 auf RunPod |
Als ich dieses Video aufgenommen habe, lief ComfyUI auf meiner eigenen RTX A5000. Inzwischen bin ich zu RunPod umgezogen: Die Modelle liegen auf einem Network Volume, und ich miete eine GPU nur, solange ein Batch läuft. Wenn du bereits eine Karte mit 12 GB+ hast, führe es lokal aus. Es ist bis auf den Strom kostenlos. Wenn nicht, ist Mieten weit günstiger als Kaufen. Meine Einführung in RunPod behandelt Einrichtung, Kosten und die Wahl der GPU.
Wenn du es ausprobieren möchtest, das ist mein RunPod-Empfehlungslink: Du erhältst nach deinen ersten 10 $ ein Guthaben von 5–500 $ (Anmeldung mit Google), und ich bekomme eine kleine Provision.
Fehler, die du vermeiden solltest
- Ein gängiges Trigger-Wort.
monetscheitert;monet123funktioniert. - Gemischte Stile im Trainingsset. Zehn einheitliche Bilder schlagen dreißig gemischte.
- Die falsche Auflösung. Bleib bei etwa 1 Megapixel.
- Guidance zu hoch. Ab etwa 3 beginnt das Bild zu verbrennen.
- Das LoRA im falschen Ordner. Es muss in
models/lorasliegen. - Eine kaputte Prompt-Datei. Großbuchstaben, eine leere negative Zeile oder der falsche Ordner stoppen den Graphen.
- Eine Schleifenanzahl, die nicht stimmt. Zähle die Prompts selbst.
Ein Hinweis zum Urheberrecht
Dürer, Hokusai und Renoir sind längst nicht mehr urheberrechtlich geschützt. Lebende Künstler sind etwas anderes. Ich habe LoRAs auf den Stil von Freunden trainiert, mit ihrer Erlaubnis, ihnen die Ergebnisse gezeigt und sie privat gehalten. Frag zuerst. Und ich habe hier Star-Wars-Figuren zum Spaß verwendet, nicht für etwas, das ich verkaufen würde.
Die Workflows für LoRA und Prompt-Liste samt meinen drei Künstler-LoRAs gibt es auf Patreon.
Die Videoversion ansehen (19:53)
Alles oben steht auch im Video, falls du lieber am Bildschirm mitmachst. Das Video ist auf Englisch.
Häufige Fragen
Wie viele Bilder brauche ich, um ein LoRA zu trainieren?
Für ein Stil-LoRA 6 bis 15 Bilder in einem einheitlichen Stil. Ein sehr markanter Stil kann mit nur fünf funktionieren.
Wie viel kostet das Training eines LoRA?
Etwa 2 $ auf fal mit den Standardschritten oder etwa 4 $ bei 2.000 Schritten. Tests kosten rund 4 Cent pro Bild.
Wie lange dauert das LoRA-Training?
Fünf bis zehn Minuten auf fal für ein Stil-LoRA.
Welche GPU brauche ich, um ein Flux-LoRA zu nutzen?
Etwa 12 GB VRAM, um Flux dev gut auszuführen. Wenn deine Karte kleiner ist, funktioniert eine Cloud-GPU wie die RTX A5000.
Was ist ein Trigger-Wort?
Ein einzigartiges Wort, das du in deinen Prompt schreibst, um das LoRA einzuschalten. Wähle etwas, das Flux noch nie gesehen hat, wie renoir123, keinen echten Namen.

Anton Tenitsky ist 3D-Artist mit mehr als 15 Jahren Erfahrung in der Computergrafik, tätig für Nickelodeon, Gameloft, Marvel Rivals und viele weitere Kunden. Mehr über mich