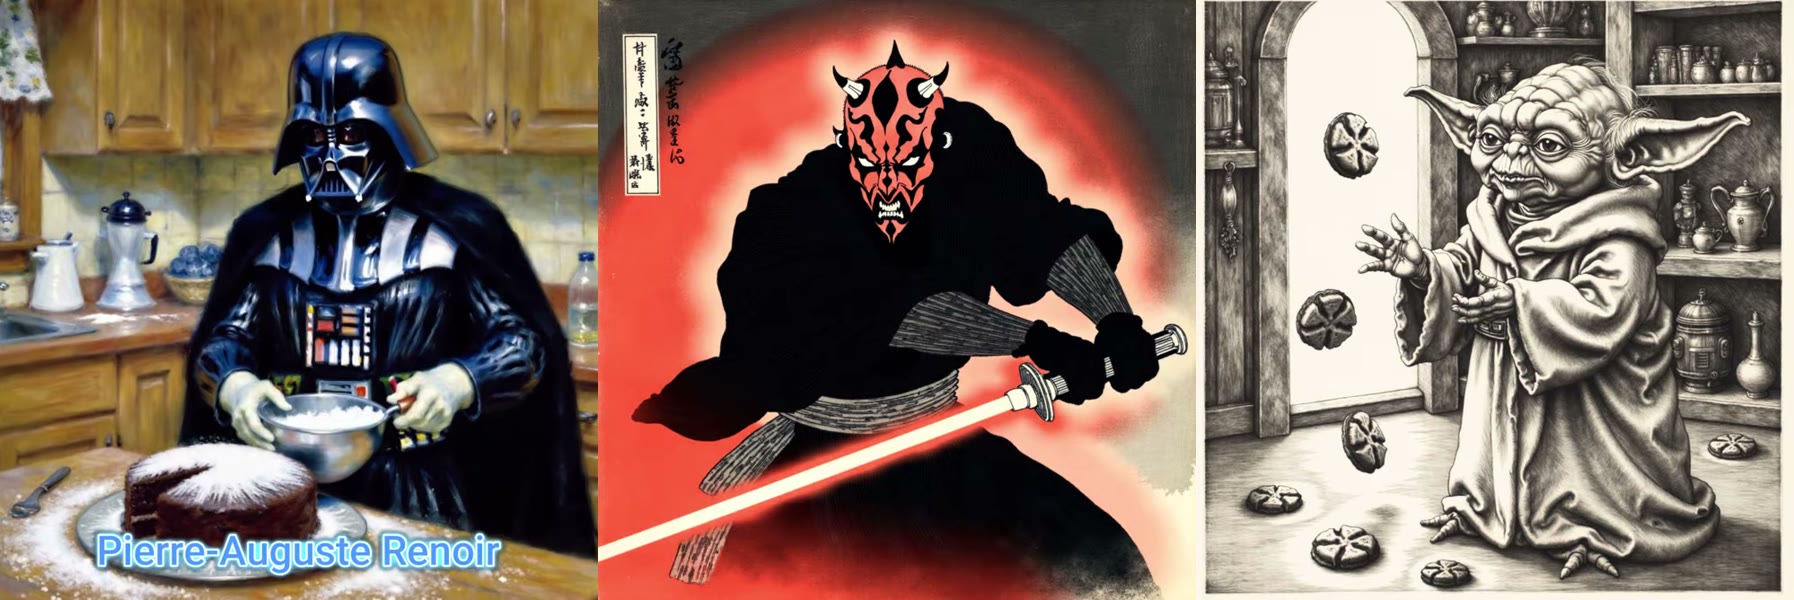
Flux sabe un poco de todo. Se entrenó con miles de millones de imágenes, así que si le pides «un grabado» obtendrás algo parecido a un grabado. Pídele el sombreado cruzado concreto de Albrecht Dürer y lo adivina.
Un LoRA lo arregla. Es un pequeño modelo complementario, entrenado con un puñado de imágenes, que empuja a Flux hacia un estilo, un personaje o un aspecto concretos. Entrenar uno requiere un puñado de imágenes, unos minutos y un par de dólares.
En la parte 1 entreno tres LoRA de estilo de artistas: el impresionismo de Renoir, los grabados japoneses de Hokusai y los grabados de Dürer. En la parte 2 construyo un flujo de ComfyUI que recorre cientos de prompts por sí solo.
En resumen
- Un LoRA de estilo solo necesita 6–15 imágenes con un estilo coherente.
- Entrenar en fal cuesta unos 2 $ y tarda entre 5 y 10 minutos.
- Usa una trigger word inventada como
renoir123, nunca una palabra real. - Genera a alrededor de 1 megapíxel, Flux guidance 3, 20–25 steps.
- Una lista de prompts y un contador de bucle permiten a ComfyUI ejecutar más de 50 prompts sin supervisión.
¿Qué es un LoRA?
LoRA significa low-rank adaptation (adaptación de bajo rango), una técnica presentada en un artículo de 2021 de Hu et al.. En lugar de reentrenar un modelo entero, entrenas un pequeño conjunto de pesos adicionales que se colocan encima y orientan lo que produce. Si quieres la idea sin las matemáticas, esta explicación en Medium es una buena lectura.
En la práctica, eso significa:
- El archivo es pequeño. Mis LoRA de estilo para Flux ocupan unos 85 MB. Flux dev en sí ronda los 12 GB.
- Entrenar es barato y rápido: un par de dólares y unos minutos.
- Puedes intercambiarlos. Un modelo base, tantos LoRA como quieras.
Hay dos tipos habituales. Un LoRA de personaje aprende a una persona o un rostro, a menudo el tuyo. Un LoRA de estilo aprende un aspecto: la pincelada, la línea, la paleta. El estilo puede ser desde realismo pictórico hasta algo tan plano y limpio como South Park, aunque yo evitaría estilos con derechos de autor para cualquier cosa que publiques. Esta guía cubre los LoRA de estilo, que son más tolerantes: sin máscaras de rostro ni descripciones cuidadosas.
Qué necesitas
- 6–15 imágenes con un único estilo coherente.
- Una cuenta en fal.ai con unos dólares de saldo. Yo recargué 10 $ y entrené varios LoRA con ellos.
- ComfyUI con Flux dev para la parte 2.
- Unos 12 GB de VRAM para ejecutar Flux bien, en local o en una GPU en la nube.
No entreno LoRA en local. Lleva mucho más tiempo y una ejecución puede fallar a medias. En fal, un LoRA cuesta unos 2 $ y está listo en minutos.
Paso 1: reúne tus imágenes de entrenamiento
Para los maestros antiguos, Wikipedia y Wikimedia Commons son las mejores fuentes: escaneos de alta resolución, en su mayoría de dominio público.
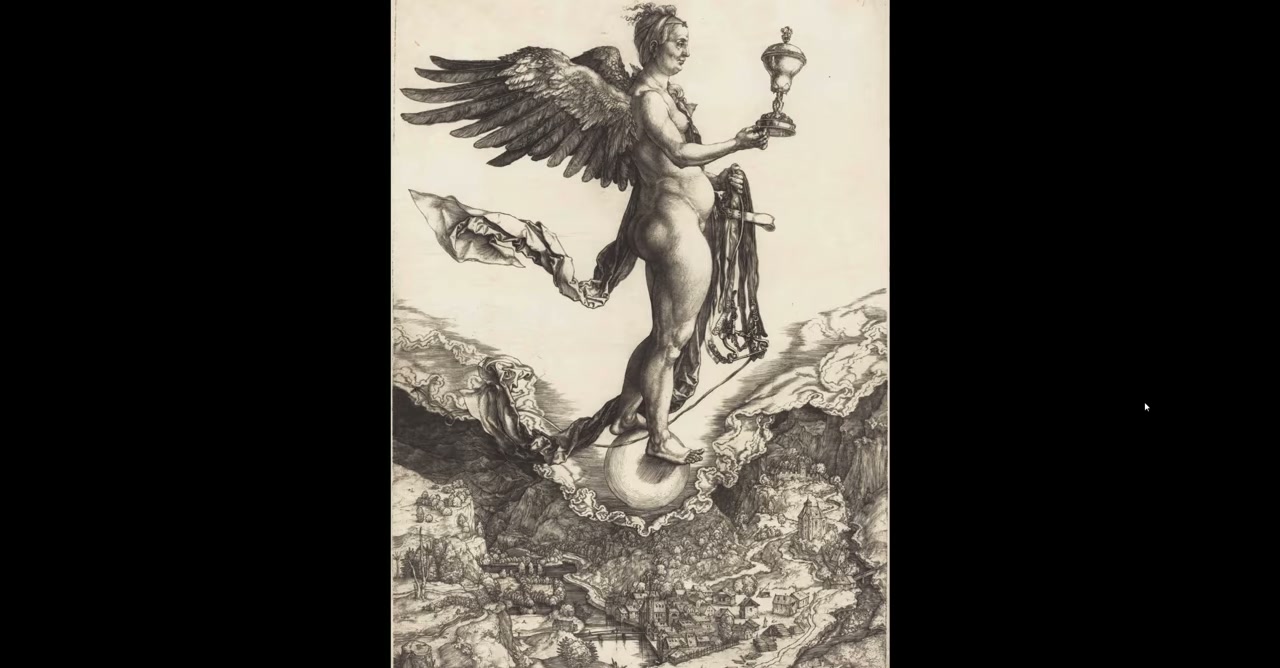
La coherencia importa más que la cantidad. Para Dürer elegí solo grabados con su sombreado denso. Descarté sus acuarelas, como la famosa Joven liebre, porque llevarían al LoRA en otra dirección.
| LoRA | Imágenes | Qué elegí |
|---|---|---|
| Albrecht Dürer | 10 | Grabados con sombreado cruzado intenso |
| Hokusai | unas 15 | Grabados japoneses en madera |
| Renoir | 11 | Pinturas impresionistas |
Para un estilo fuerte y distintivo puedes bajar hasta cinco imágenes.
Paso 2: entrena el LoRA en fal
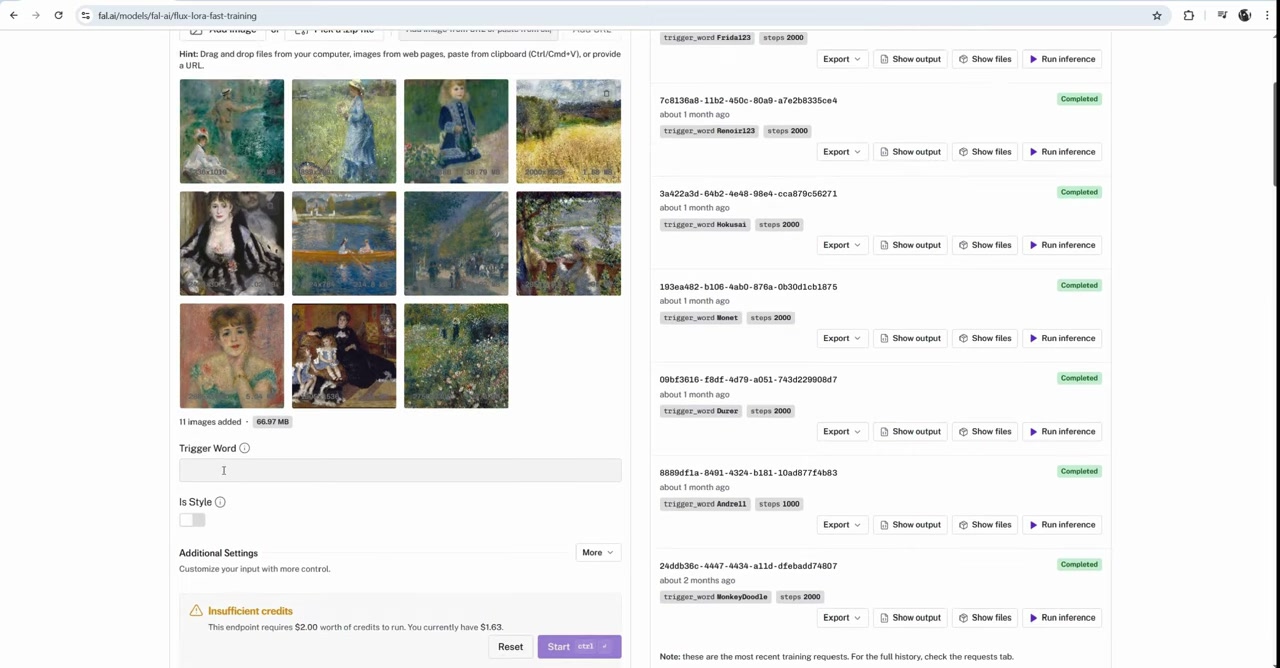
En fal, abre el modelo Flux LoRA Fast Training. Hay varios modelos de Flux en fal; para esto, salta las variantes más nuevas como Kontext y Krea. Cuando grabé esto, no admitían ControlNet, así que perderías el control de la pose más adelante. Entrena para Flux dev.
Arrastra tus imágenes y ajusta estas opciones:
| Ajuste | Lo que uso | Por qué |
|---|---|---|
| Trigger word | renoir123 |
Única, para que Flux no la confunda con nada que ya conozca |
| Is style | Activado | Es un estilo, no una persona |
| Masks | Desactivado | Las máscaras son para rostros |
| Steps | Por defecto, o 2000 | 2000 steps da mejor calidad pero duplica el coste, a unos 4 $ |
Haz clic en Start. El entrenamiento tarda entre 5 y 10 minutos.
El error que cometí con la trigger word: mi primer intento fue un LoRA de Claude Monet con la trigger word monet. No funcionó. «Monet» es una palabra sobre la que Flux ya tiene ideas muy firmes, así que el LoRA no pudo imponerse. monet123 habría funcionado. Añade siempre números o letras sin sentido para que la trigger word sea única.
Paso 3: descarga, renombra e instala
Cuando termine el entrenamiento, abre Show files y descarga el archivo .safetensors, de unos 85 MB. Safetensors es el formato estándar para compartir pesos de modelos porque, a diferencia de los formatos antiguos, no puede contener código ejecutable.
fal llama al archivo pytorch_lora_weights.safetensors. Cámbiale el nombre enseguida. Yo pongo la trigger word en el nombre del archivo, para no tener que buscar qué palabra corresponde a cada LoRA:
ComfyUI/models/loras/lora_renoir123.safetensorsTiene que ir en la carpeta loras, o el cargador de LoRA no lo verá. En un pod de RunPod, súbelo con JupyterLab a la misma carpeta de tu volumen de red.
Paso 4: pruébalo
fal tiene un botón Run inference junto a tu LoRA entrenado, así que puedes probar antes de tocar ComfyUI. Mi primer prompt, renoir123, Darth Maul standing on a turtle, consiguió el estilo pero poco más. Cambiar a Yoda funcionó mucho mejor, a unos 4 céntimos por imagen.
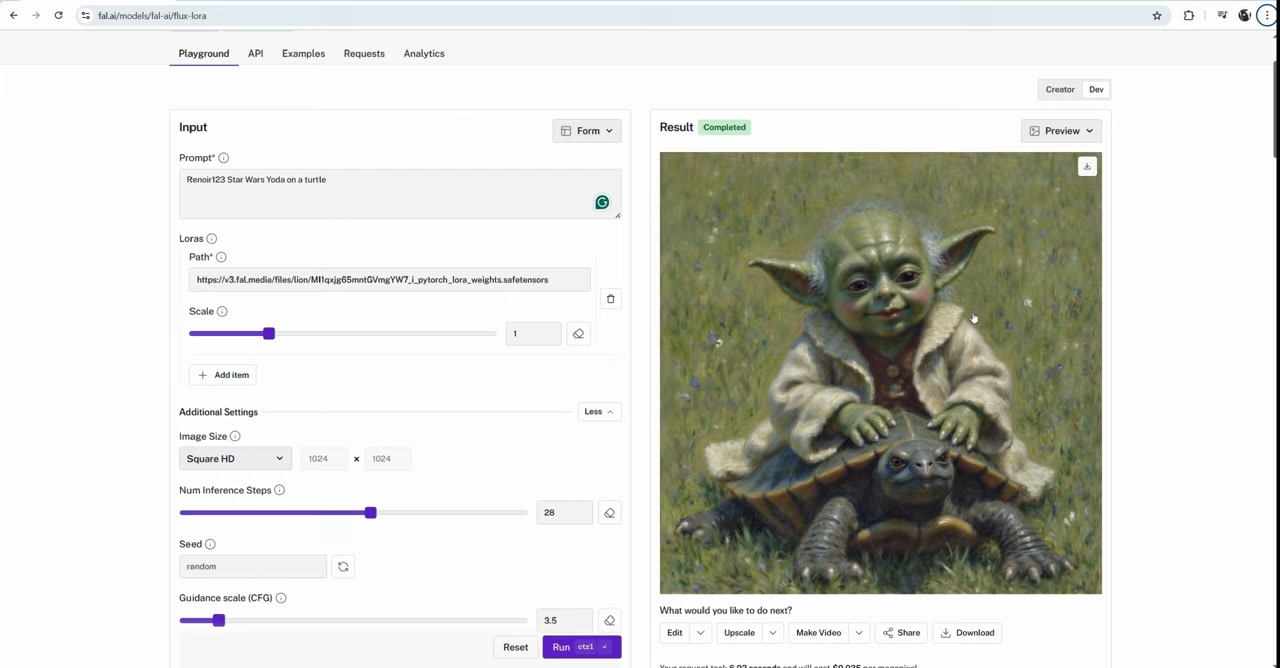
La resolución importa. Flux funciona mejor a alrededor de 1 megapíxel: 1024 × 1024, o «square HD» en fal. 512 × 512 es demasiado pequeño para tener buen detalle, y subir a cuadrados de 2K o 4K da imágenes peores que 1K. Así se comportan estos modelos.
Por diversión, pasé el resultado a un modelo de imagen a vídeo, Seedance Lite, también en fal. Por 18 céntimos y con los ajustes por defecto, obtuve unos segundos de Yoda balanceándose sobre su tortuga.
Paso 5: construye el flujo de Flux + LoRA en ComfyUI
Con eso termina el entrenamiento. El grafo básico de ComfyUI tiene nueve nodos. Aquí está cada uno y cómo lo configuro:
| Nodo | Ajuste | Notas |
|---|---|---|
| Load Diffusion Model | flux1-dev |
Unos 12 GB; instálalo desde el Model Manager |
| Load LoRA | lora_renoir123 |
Lee models/loras |
| DualCLIPLoader | CLIP-L + T5 | Los dos codificadores de texto que necesita Flux |
| Empty Latent Image | 1024 × 1024 | La resolución de salida |
| Flux Guidance | 3 | Con cuánta fuerza empuja el prompt. Demasiado alto quema la imagen |
| XLabs Sampler | 25 steps, seed en increment | 20 también está bien. Más de 50 es perder tiempo |
| Negative prompt | Vacío | Flux casi lo ignora, pero debe estar conectado |
| VAE Decode | Flux VAE | Unos 300 MB; convierte el latente en píxeles |
| Image Save (WAS) | PNG, prefijo personalizado | Nombres de archivo más fáciles que con el nodo Save por defecto |
Pon la trigger word al principio de tu prompt positivo: renoir123, Star Wars, cooking cakes. Poner la seed en increment también te da un recuento de cuántas imágenes llevas.
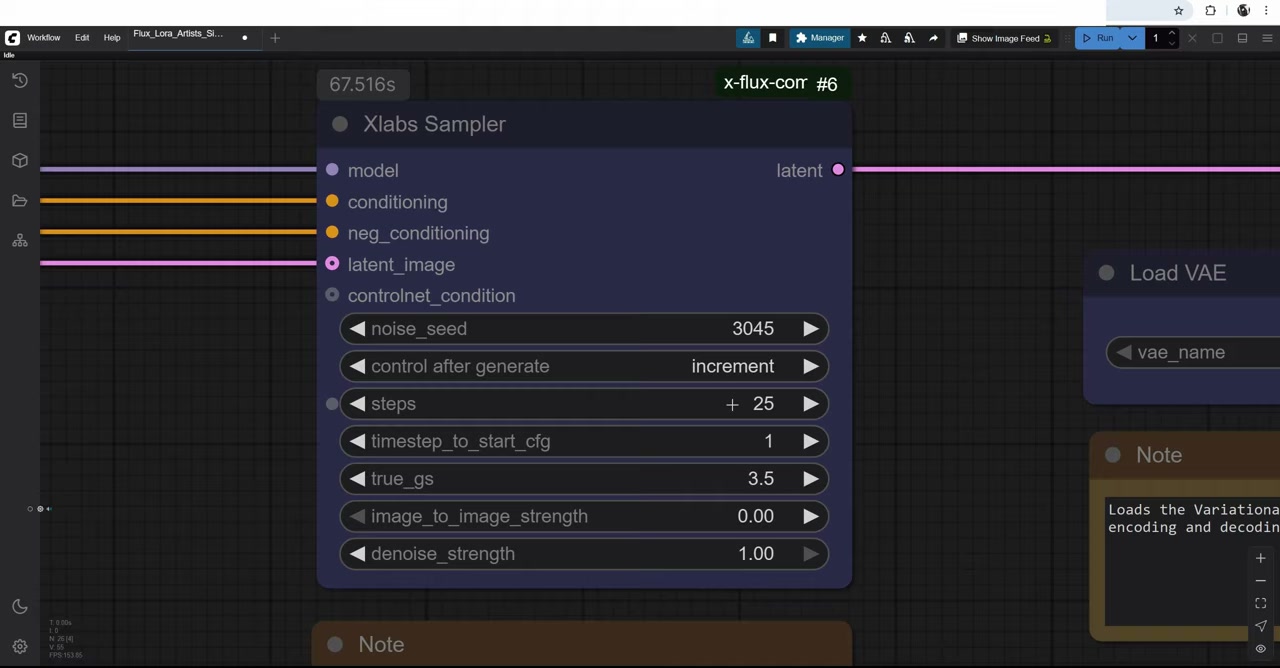
Paso 6: ejecuta cientos de prompts automáticamente
Hacer una imagen cada vez es lo que harías en una web. ComfyUI se justifica cuando pones en cola 50 prompts y te vas a dormir. Necesitarás tres paquetes de nodos personalizados, todos instalables desde el ComfyUI Manager: ComfyUI Inspire Pack, WAS Node Suite y x-flux-comfyui.
1. Escribe el archivo de prompts
Le pedí a ChatGPT 50 prompts de Star Wars con este formato exacto. Gemini funciona igual de bien:
positive: Star Wars art, Princess Leia, leading Rebel Alliance troops, holographic maps, determined faces
negative: blurry, cartoonish, scared, disheveled, empty room
---
positive: Star Wars art, Yoda, teaching young Jedi in a serene temple, ancient architecture
negative: blurry, cartoonish, chaotic, angry, noisy environment
El formato es estricto:
positive:ynegative:deben ir en minúsculas.- Los prompts se separan con
---. - La línea negative no puede estar vacía, aunque Flux la ignore. Una vacía rompe todo el grafo.
- Borra cualquier línea de introducción que añada el chatbot al principio.
2. Ponlo en la única carpeta que funciona
Guarda el archivo en ComfyUI/custom_nodes/comfyui-inspire-pack/prompts/. El nodo Load Prompts From File solo mira ahí.
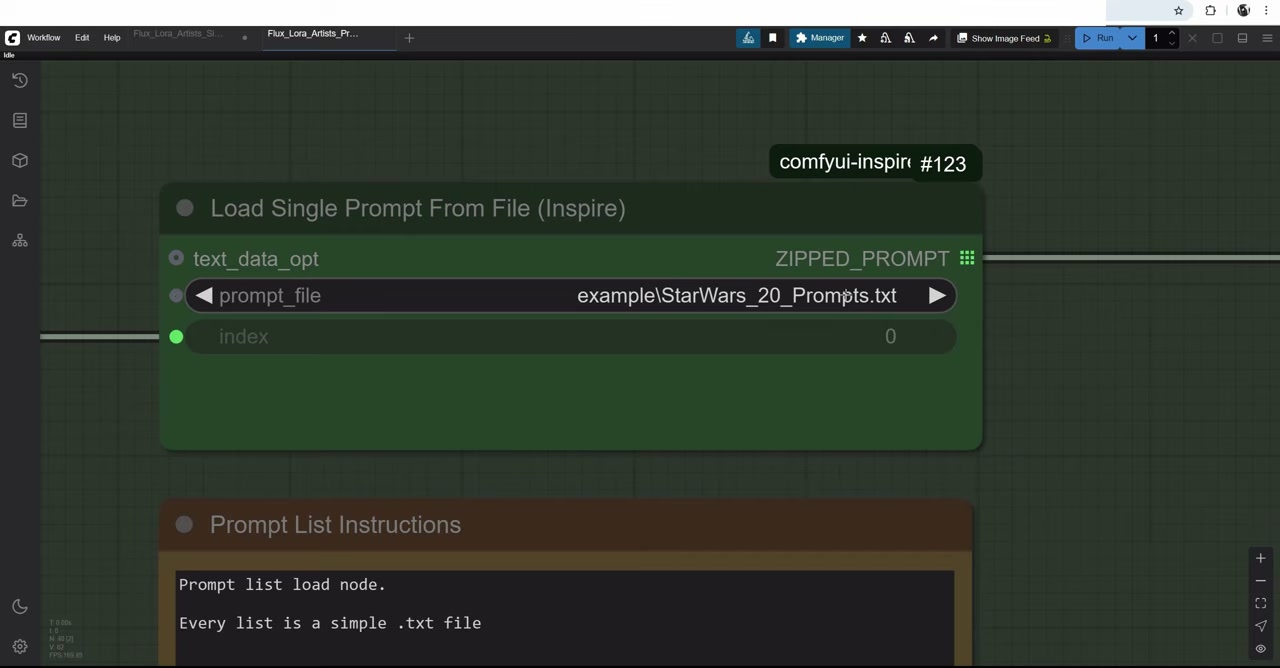
3. Añade la trigger word
Un nodo Concatenate pone la trigger word delante de cada prompt, así que cambiar de estilo es cambiar un solo campo. Deja un espacio después de la trigger word, o se pegará a la primera palabra del prompt.
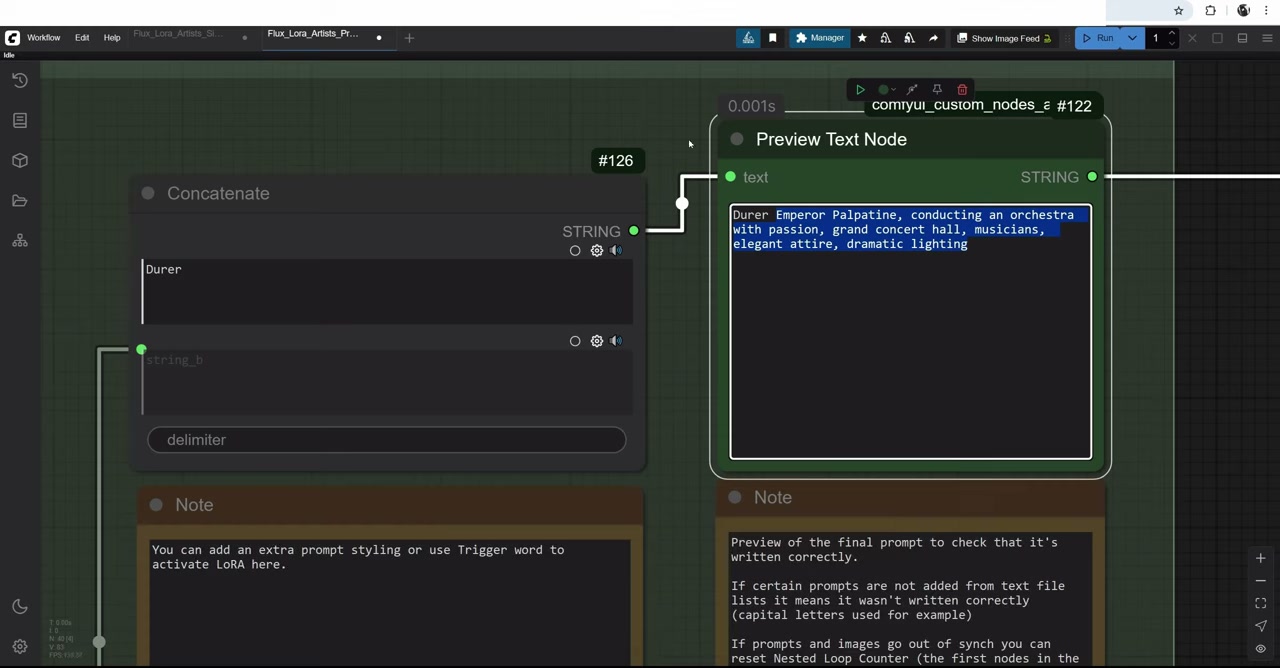
4. Haz que avance
Aquí está lo que la mayoría de los tutoriales pasan por alto: por sí sola, la lista de prompts solo ejecuta el primer prompt. Para recorrer la lista, alimenta el índice con un WAS Nested Loop Counter:
- Pon el máximo igual al número de prompts de tu archivo, con un incremento de 1.
- Cuenta tus prompts. Si le pides 50 a un chatbot, a menudo recibirás 48 o 49. Yo busco
positive:en el archivo y uso el número de coincidencias. - Para empezar de nuevo, pon reset en true durante una ejecución y luego otra vez en false. El contador empieza en 0, así que 50 prompts van de 0 a 49.
Hablo con más detalle de las listas de prompts en otro vídeo.
5. Ejecútalo y márchate
Pon la cola en Run (Instant) y déjalo. Algunas de mis imágenes de la noche eran horribles y otras estupendas. Todo el mundo selecciona lo mejor de lo que produce la IA; el truco es que seleccionar salga barato.
Qué salió
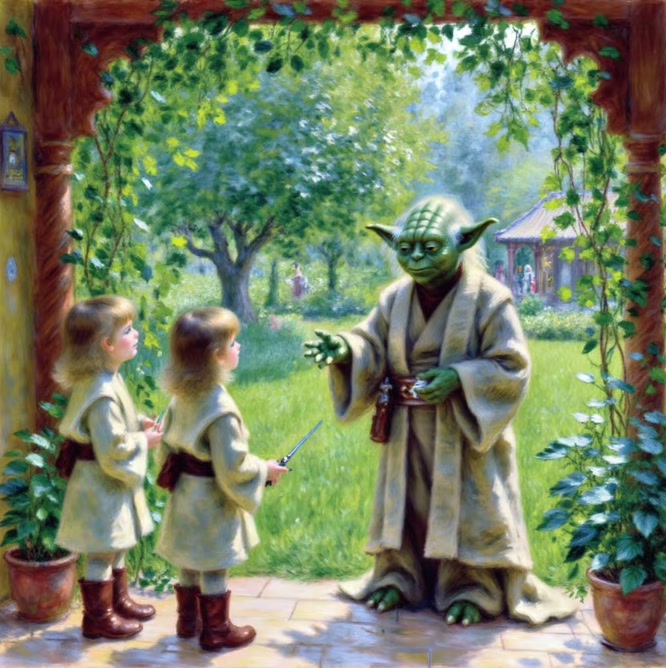
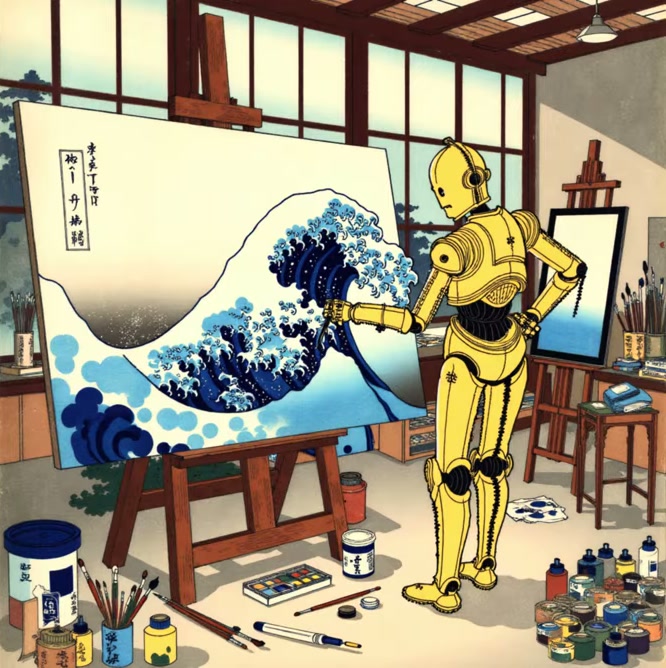
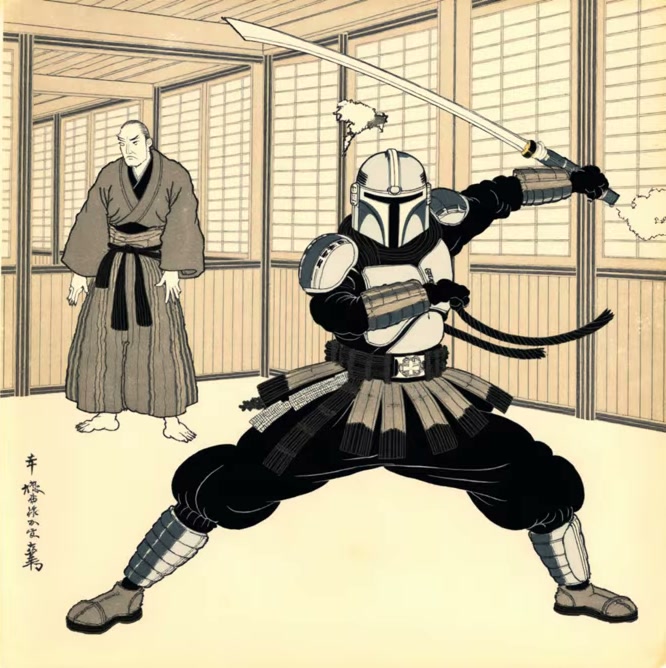
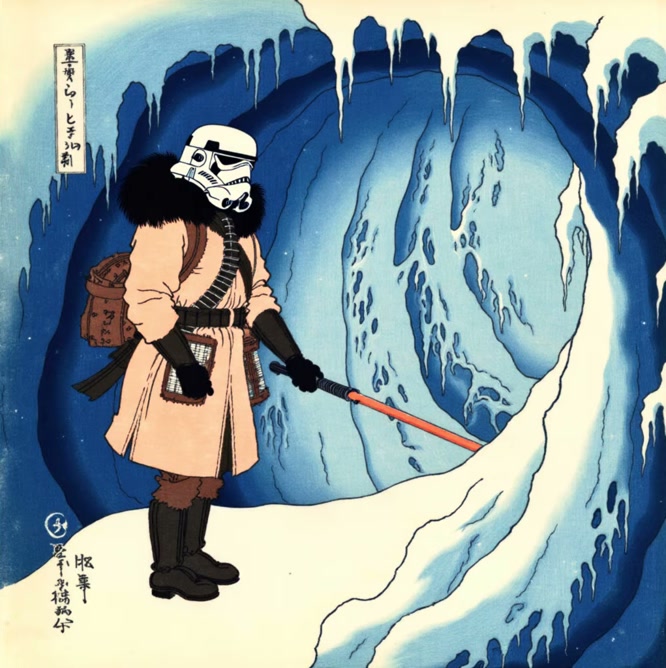
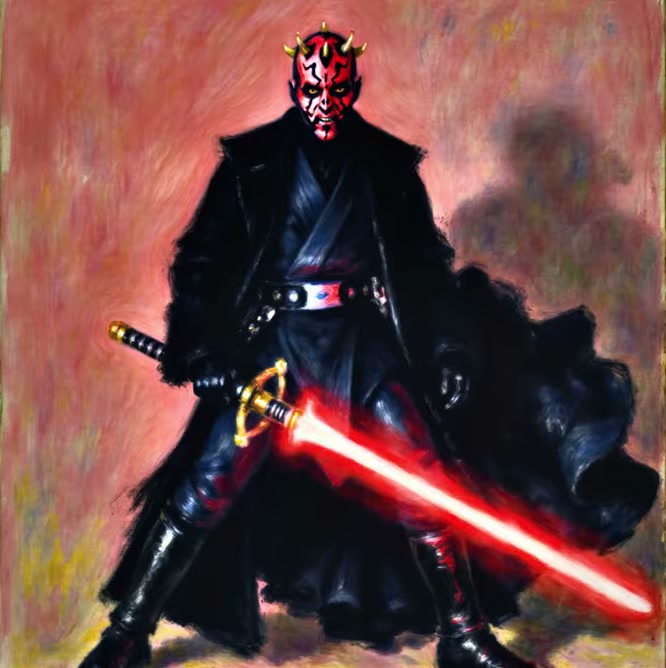
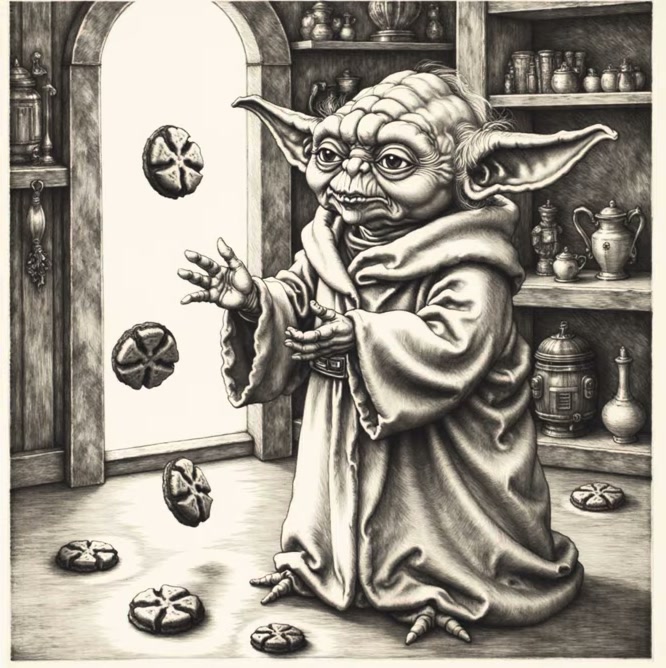
LoRA de Renoir, Hokusai y Dürer, de la misma lista de prompts de la noche.
Dónde ejecutarlo
Entrenar y ejecutar son dos trabajos distintos, y uso un sitio diferente para cada uno:
| Trabajo | Dónde lo hago | Coste |
|---|---|---|
| Entrenar el LoRA | fal | Unos 2 $ por LoRA |
| Pruebas rápidas | fal | Unos 4 ¢ por imagen |
| Lotes nocturnos en ComfyUI | Tu propia GPU de 12 GB o más, o una GPU en la nube | Electricidad, o desde 0,27 $/h por una RTX A5000 en RunPod |
Cuando grabé este vídeo, ComfyUI funcionaba en mi propia RTX A5000. Desde entonces lo he pasado a RunPod: los modelos viven en un volumen de red y alquilo una GPU solo mientras se ejecuta un lote. Si ya tienes una tarjeta de 12 GB o más, ejecútalo en local. Es gratis salvo por la electricidad. Si no, alquilar sale mucho más barato que comprar una. Mi introducción a RunPod explica la configuración, los costes y qué GPU elegir.
Si quieres probarlo, este es mi enlace de referido de RunPod: recibes entre 5 y 500 $ de crédito después de tus primeros 10 $ (regístrate con Google), y yo recibo una pequeña comisión.
Errores que evitar
- Una trigger word común.
monetfalla;monet123funciona. - Estilos mezclados en el conjunto de entrenamiento. Diez imágenes coherentes valen más que treinta mezcladas.
- La resolución equivocada. Mantente alrededor de 1 megapíxel.
- Guidance demasiado alto. Por encima de 3, más o menos, la imagen empieza a quemarse.
- El LoRA en la carpeta equivocada. Tiene que ser
models/loras. - Un archivo de prompts roto. Las mayúsculas, una línea negative vacía o la carpeta equivocada detendrán el grafo.
- Un recuento de bucle que no coincide. Cuenta tú mismo los prompts.
Una nota sobre los derechos de autor
Dürer, Hokusai y Renoir hace mucho que están fuera de derechos de autor. Los artistas vivos son otra cosa. He entrenado LoRA con los estilos de amigos con su permiso, les enseñé los resultados y los mantuve en privado. Pregunta primero. Y aquí usé personajes de Star Wars por diversión, no para nada que fuera a vender.
Los flujos de LoRA y de lista de prompts, junto con mis tres LoRA de artistas, están en Patreon.
Ver la versión en vídeo (19:53)
Todo lo anterior también está en el vídeo, si prefieres seguirlo en pantalla. El vídeo está en inglés.
Preguntas frecuentes
¿Cuántas imágenes necesito para entrenar un LoRA?
Para un LoRA de estilo, entre 6 y 15 imágenes con un estilo coherente. Un estilo muy distintivo puede funcionar con solo cinco.
¿Cuánto cuesta entrenar un LoRA?
Unos 2 $ en fal con los steps por defecto, o unos 4 $ con 2000 steps. Probarlo cuesta unos 4 céntimos por imagen.
¿Cuánto tarda el entrenamiento de un LoRA?
Entre cinco y diez minutos en fal para un LoRA de estilo.
¿Qué GPU necesito para usar un LoRA de Flux?
Unos 12 GB de VRAM para ejecutar bien Flux dev. Si tu tarjeta es más pequeña, sirve una GPU en la nube como una RTX A5000.
¿Qué es una palabra gatillo (trigger word)?
Una palabra única que añades a tu prompt para activar el LoRA. Que sea algo que Flux no haya visto nunca, como renoir123, no un nombre real.

Anton Tenitsky es artista 3D con más de 15 años en gráficos por ordenador, que ha trabajado con Nickelodeon, Gameloft, Marvel Rivals y muchos otros clientes. Más sobre mí