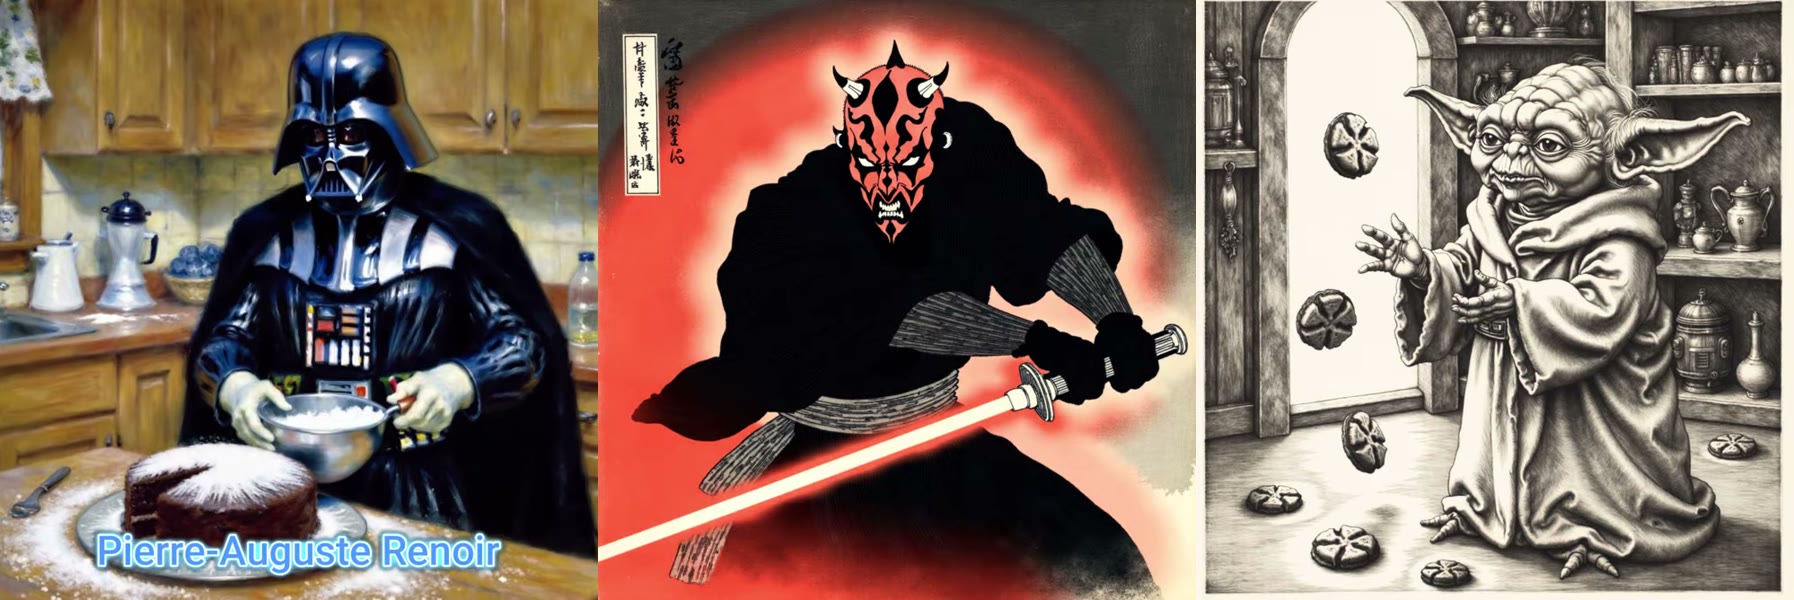
Flux sait un peu de tout. Il a été entraîné sur des milliards d’images : demandez-lui « une gravure » et vous obtiendrez quelque chose qui y ressemble. Demandez-lui les hachures croisées propres à Albrecht Dürer et il devine.
Un LoRA corrige cela. C’est un petit modèle complémentaire, entraîné sur une poignée d’images, qui oriente Flux vers un style, un personnage ou un rendu précis. L’entraîner demande une poignée d’images, quelques minutes et quelques dollars.
Dans la partie 1, j’entraîne trois LoRA de style d’artiste : l’impressionnisme de Renoir, les estampes sur bois d’Hokusai et les gravures de Dürer. Dans la partie 2, je construis un workflow ComfyUI qui parcourt tout seul des centaines de prompts.
En bref
- Un LoRA de style n’a besoin que de 6 à 15 images dans un style cohérent.
- L’entraînement sur fal coûte environ 2 $ et dure de 5 à 10 minutes.
- Utilisez un mot déclencheur inventé comme
renoir123, jamais un vrai mot. - Générez à environ 1 mégapixel, Flux guidance 3, 20 à 25 étapes.
- Une liste de prompts et un compteur de boucle permettent à ComfyUI d’exécuter plus de 50 prompts sans surveillance.
Qu’est-ce qu’un LoRA ?
LoRA signifie low-rank adaptation (adaptation de bas rang), une technique introduite dans un article de Hu et al. de 2021. Au lieu de réentraîner un modèle entier, on entraîne un petit ensemble de poids supplémentaires qui se superposent à lui et orientent ce qu’il produit. Si vous voulez l’idée sans les mathématiques, cette explication sur Medium est une bonne lecture.
Concrètement :
- Le fichier est petit. Mes LoRA de style pour Flux font environ 85 Mo. Flux dev lui-même pèse environ 12 Go.
- L’entraînement est rapide et bon marché : quelques dollars et quelques minutes.
- On peut les échanger. Un modèle de base, autant de LoRA que vous voulez.
Il y a deux types courants. Un LoRA de personnage apprend une personne ou un visage, souvent le vôtre. Un LoRA de style apprend un rendu : coup de pinceau, trait, palette. Un style peut être n’importe quoi, du réalisme pictural à quelque chose d’aussi plat et net que South Park, même si j’éviterais les styles protégés par le droit d’auteur pour tout ce que vous publiez. Ce guide traite des LoRA de style, plus indulgents : pas de masques de visage, pas de légendes soignées.
Ce dont vous avez besoin
- De 6 à 15 images dans un seul style cohérent.
- Un compte fal.ai avec quelques dollars de crédit. J’ai rechargé 10 $ et entraîné plusieurs LoRA avec.
- ComfyUI avec Flux dev pour la partie 2.
- Environ 12 Go de VRAM pour faire tourner Flux correctement, en local ou sur un GPU cloud.
Je n’entraîne pas de LoRA en local. C’est bien plus long, et un entraînement peut échouer en cours de route. Sur fal, un LoRA coûte environ 2 $ et est terminé en quelques minutes.
Étape 1 : rassembler vos images d’entraînement
Pour les maîtres anciens, Wikipédia et Wikimedia Commons sont les meilleures sources : des numérisations haute résolution, pour la plupart dans le domaine public.
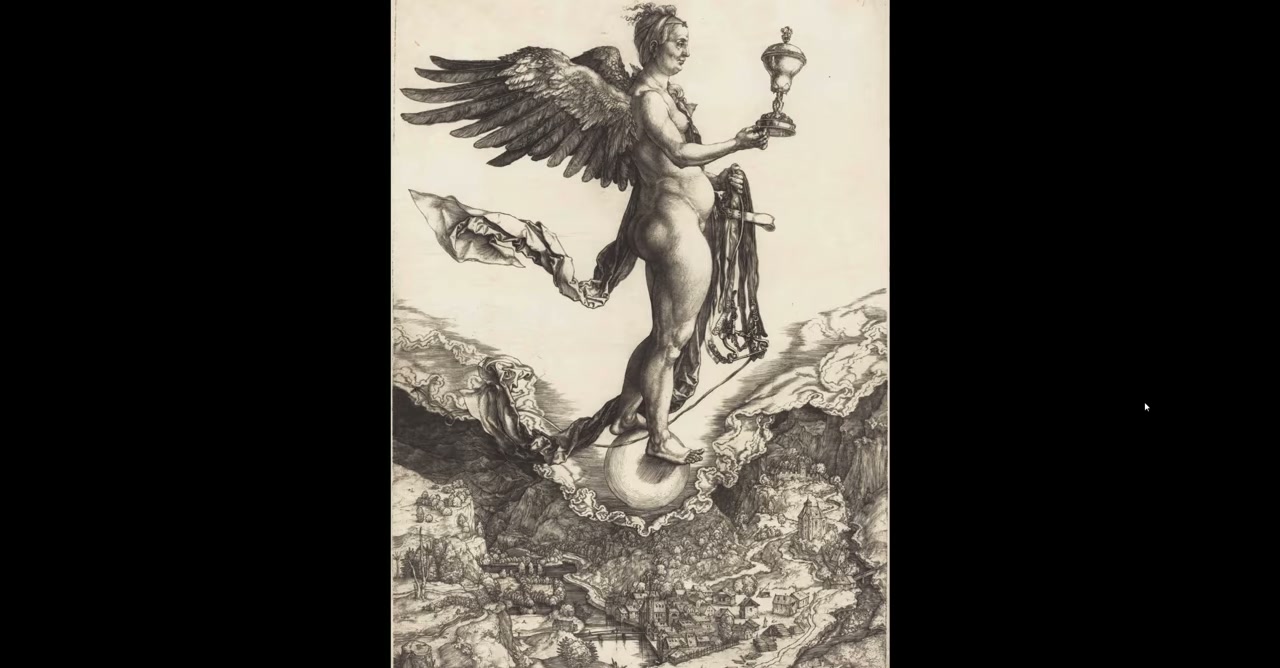
La cohérence compte plus que la quantité. Pour Dürer, je n’ai retenu que les gravures à ses hachures denses. J’ai laissé de côté ses aquarelles, comme le célèbre Jeune lièvre, parce qu’elles tireraient le LoRA dans une autre direction.
| LoRA | Images | Ce que j’ai retenu |
|---|---|---|
| Albrecht Dürer | 10 | Gravures à fortes hachures croisées |
| Hokusai | environ 15 | Estampes sur bois |
| Renoir | 11 | Peintures impressionnistes |
Pour un style fort et distinctif, on peut descendre jusqu’à cinq images.
Étape 2 : entraîner le LoRA sur fal
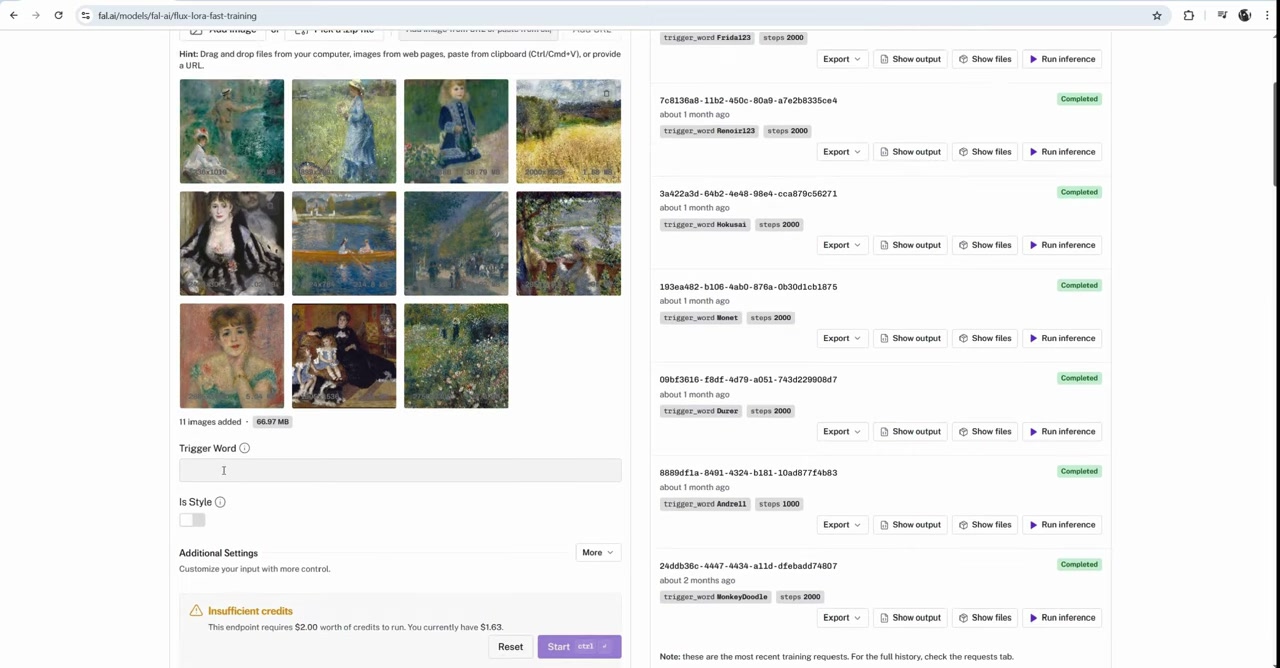
Sur fal, ouvrez le modèle Flux LoRA Fast Training. Il y a plusieurs modèles Flux sur fal ; laissez de côté les variantes plus récentes comme Kontext et Krea. Quand j’ai enregistré ceci, elles ne prenaient pas en charge ControlNet, vous perdriez donc le contrôle de la pose plus tard. Entraînez pour Flux dev.
Glissez vos images et réglez ces options :
| Réglage | Ce que j’utilise | Pourquoi |
|---|---|---|
| Mot déclencheur | renoir123 |
Unique, pour que Flux ne puisse pas le confondre avec ce qu’il connaît déjà |
| Is style | Activé | C’est un style, pas une personne |
| Masks | Désactivé | Les masques servent aux visages |
| Steps | Par défaut, ou 2 000 | 2 000 étapes donnent une meilleure qualité mais doublent le coût, à environ 4 $ |
Cliquez sur Start. L’entraînement dure de 5 à 10 minutes.
L’erreur de mot déclencheur que j’ai faite : mon premier essai était un LoRA Claude Monet avec le mot déclencheur monet. Cela n’a pas fonctionné. « Monet » est un mot sur lequel Flux a déjà des idées bien arrêtées, le LoRA n’a donc pas pu prendre le dessus. monet123 aurait fonctionné. Ajoutez toujours des chiffres ou du charabia pour rendre le mot déclencheur unique.
Étape 3 : télécharger, renommer et installer
Quand l’entraînement est terminé, ouvrez Show files et téléchargez le fichier .safetensors, environ 85 Mo. Safetensors est le format standard pour partager des poids de modèles car, contrairement aux anciens formats, il ne peut pas contenir de code exécutable.
fal nomme le fichier pytorch_lora_weights.safetensors. Renommez-le tout de suite. Je mets le mot déclencheur dans le nom du fichier, pour ne jamais avoir à chercher quel mot va avec quel LoRA :
ComfyUI/models/loras/lora_renoir123.safetensorsIl doit aller dans le dossier loras, sinon le chargeur de LoRA ne le verra pas. Sur un pod RunPod, envoyez-le via JupyterLab dans le même dossier de votre volume réseau.
Étape 4 : le tester
fal propose un bouton Run inference à côté de votre LoRA entraîné, vous pouvez donc tester avant de toucher à ComfyUI. Mon premier prompt, renoir123, Darth Maul standing on a turtle, a donné le style mais pas grand-chose d’autre. Passer à Yoda a beaucoup mieux fonctionné, à environ 4 centimes l’image.
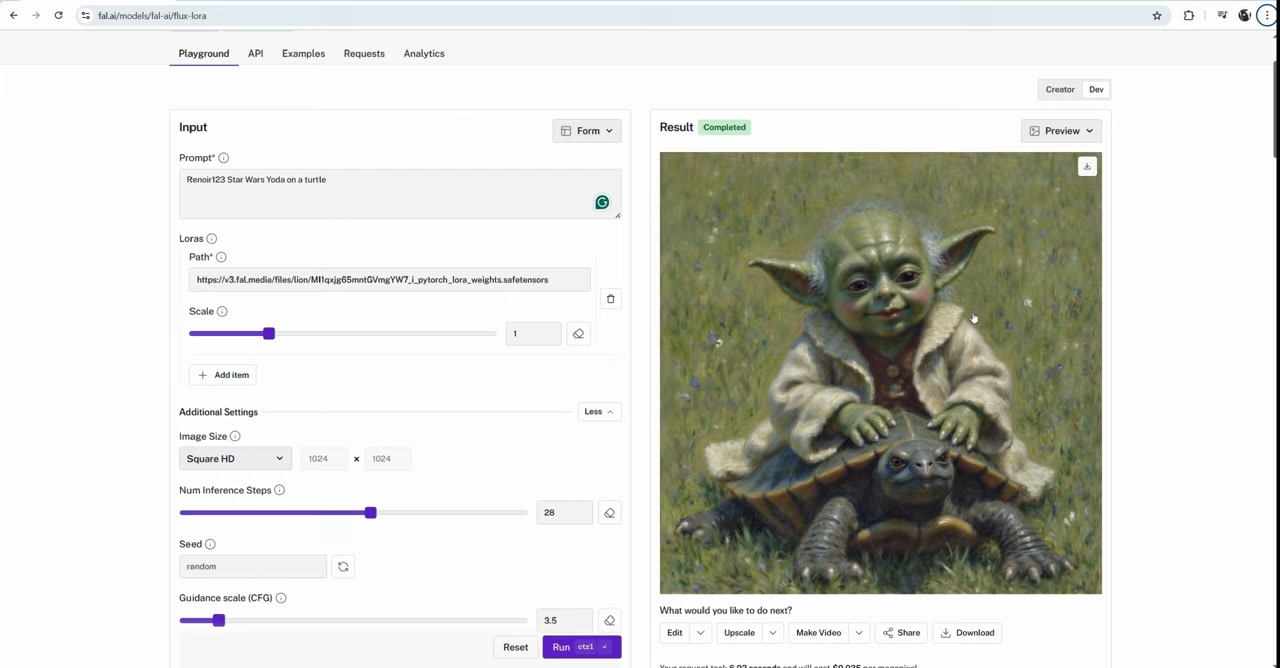
La résolution compte. Flux fonctionne mieux à environ 1 mégapixel : 1024 × 1024, ou « square HD » sur fal. 512 × 512 est trop petit pour un bon niveau de détail, et passer à des carrés de 2K ou 4K donne de moins bonnes images qu’en 1K. C’est simplement le comportement de ces modèles.
Pour le plaisir, j’ai envoyé le résultat dans un modèle d’image vers vidéo, Seedance Lite, également sur fal. Pour 18 centimes et les réglages par défaut, j’ai obtenu quelques secondes de Yoda se balançant sur sa tortue.
Étape 5 : construire le workflow Flux + LoRA dans ComfyUI
L’entraînement est terminé. Le graphe ComfyUI de base compte neuf nodes. Voici chacun d’eux et comment je le règle :
| Node | Réglage | Notes |
|---|---|---|
| Load Diffusion Model | flux1-dev |
Environ 12 Go ; installez-le depuis le Model Manager |
| Load LoRA | lora_renoir123 |
Lit models/loras |
| DualCLIPLoader | CLIP-L + T5 | Les deux encodeurs de texte dont Flux a besoin |
| Empty Latent Image | 1024 × 1024 | Votre résolution de sortie |
| Flux Guidance | 3 | Force avec laquelle le prompt pousse. Trop haut, l’image brûle |
| XLabs Sampler | 25 étapes, seed en increment | 20 convient aussi. Au-delà de 50, c’est du temps perdu |
| Prompt négatif | Vide | Flux l’ignore en grande partie, mais il doit être connecté |
| VAE Decode | VAE de Flux | Environ 300 Mo ; transforme le latent en pixels |
| Image Save (WAS) | PNG, préfixe personnalisé | Nommage de fichiers plus simple que le node Save par défaut |
Mettez le mot déclencheur au début de votre prompt positif : renoir123, Star Wars, cooking cakes. Régler la seed sur increment vous donne aussi un décompte du nombre d’images produites.
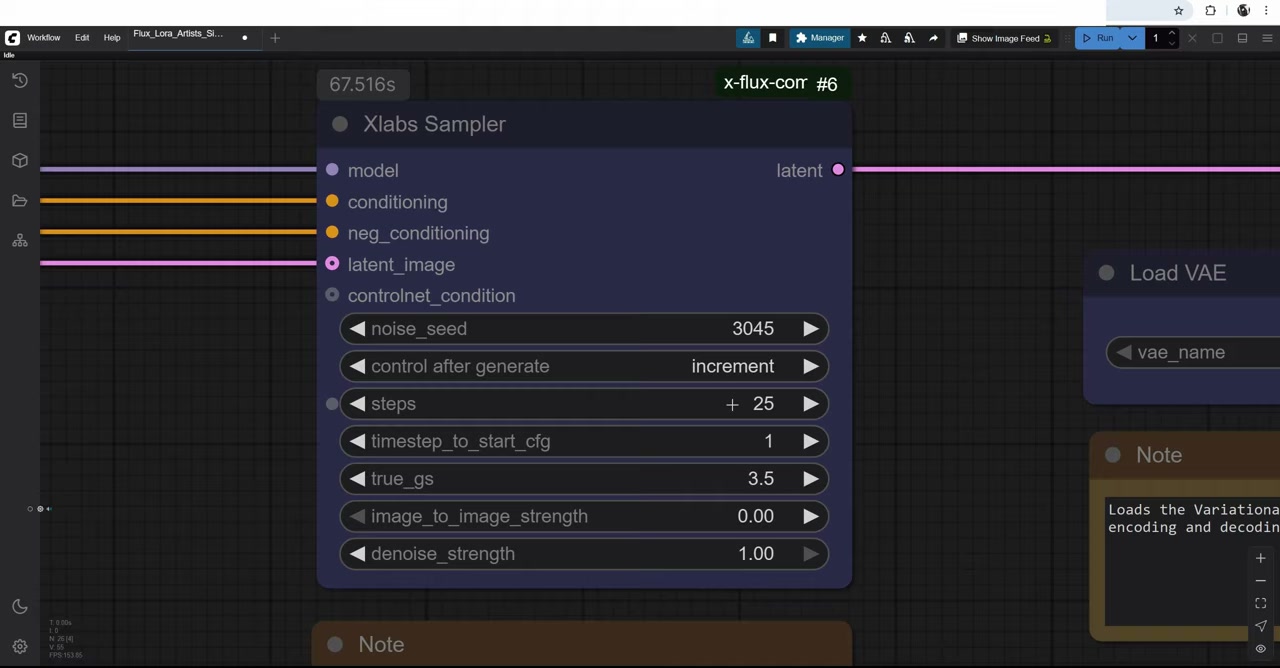
Étape 6 : exécuter des centaines de prompts automatiquement
Produire une image à la fois, c’est ce qu’on ferait sur un site web. ComfyUI trouve son intérêt quand vous mettez 50 prompts en file et allez dormir. Il vous faudra trois packs de custom nodes, tous installables depuis le ComfyUI Manager : ComfyUI Inspire Pack, WAS Node Suite et x-flux-comfyui.
1. Écrire le fichier de prompts
J’ai demandé à ChatGPT 50 prompts Star Wars dans ce format exact. Gemini marche aussi bien :
positive: Star Wars art, Princess Leia, leading Rebel Alliance troops, holographic maps, determined faces
negative: blurry, cartoonish, scared, disheveled, empty room
---
positive: Star Wars art, Yoda, teaching young Jedi in a serene temple, ancient architecture
negative: blurry, cartoonish, chaotic, angry, noisy environment
Le format est strict :
positive:etnegative:doivent être en minuscules.- Les prompts sont séparés par
---. - La ligne négative ne peut pas être vide, même si Flux l’ignore. Une ligne vide casse tout le graphe.
- Supprimez toute ligne d’introduction que le chatbot ajoute en haut.
2. Le placer dans le seul dossier qui fonctionne
Enregistrez le fichier dans ComfyUI/custom_nodes/comfyui-inspire-pack/prompts/. Le node Load Prompts From File ne cherche que là.
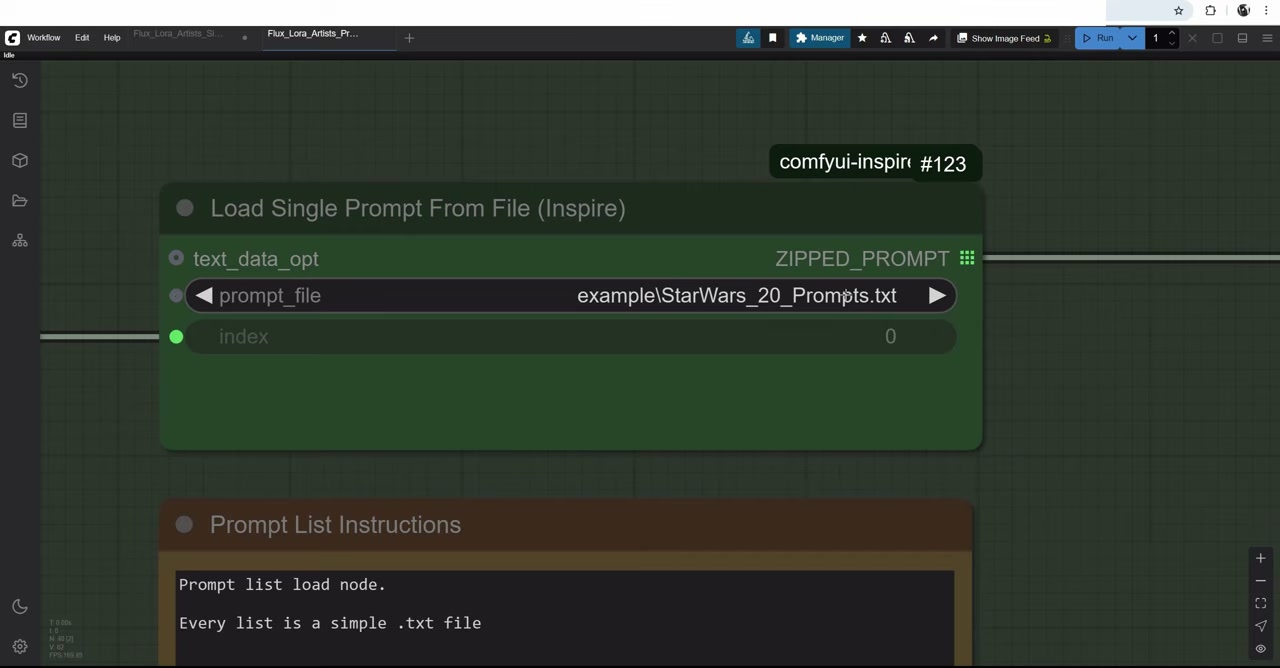
3. Ajouter le mot déclencheur
Un node Concatenate place le mot déclencheur devant chaque prompt, de sorte que changer de style revient à modifier un seul champ. Laissez un espace après le mot déclencheur, sinon il se colle au premier mot du prompt.
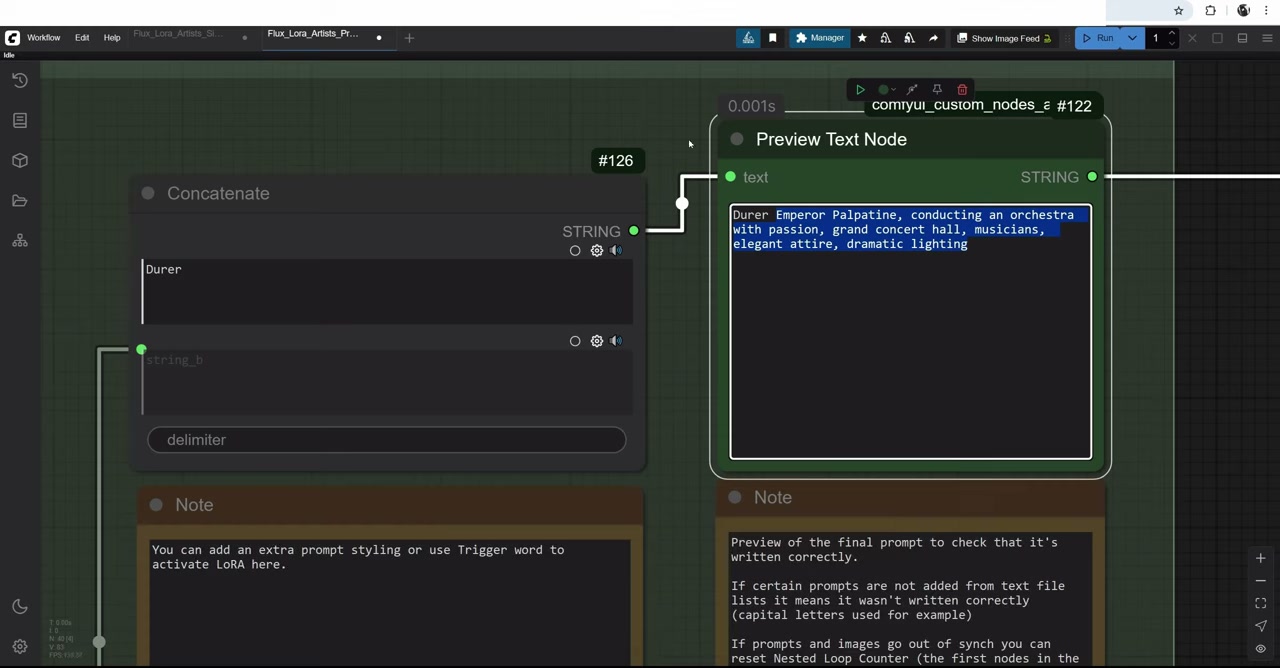
4. Le faire défiler
Voici la partie que la plupart des tutoriels oublient : seule, la liste de prompts n’exécute jamais que le premier prompt. Pour parcourir la liste, alimentez-la avec l’index d’un WAS Nested Loop Counter :
- Réglez le maximum sur le nombre de prompts de votre fichier, avec un incrément de 1.
- Comptez vos prompts. Si vous en demandez 50 à un chatbot, vous en obtiendrez souvent 48 ou 49. Je cherche
positive:dans le fichier et j’utilise le nombre de résultats. - Pour recommencer, mettez reset à true pour une exécution, puis remettez-le à false. Le compteur part de 0, donc 50 prompts vont de 0 à 49.
J’approfondis les listes de prompts dans une vidéo à part.
5. Lancer et s’éloigner
Réglez la file sur Run (Instant) et laissez-la tourner. Certaines de mes images de la nuit étaient affreuses, d’autres superbes. Tout le monde trie les résultats de l’IA ; l’astuce est de rendre ce tri peu coûteux.
Ce qui en est sorti
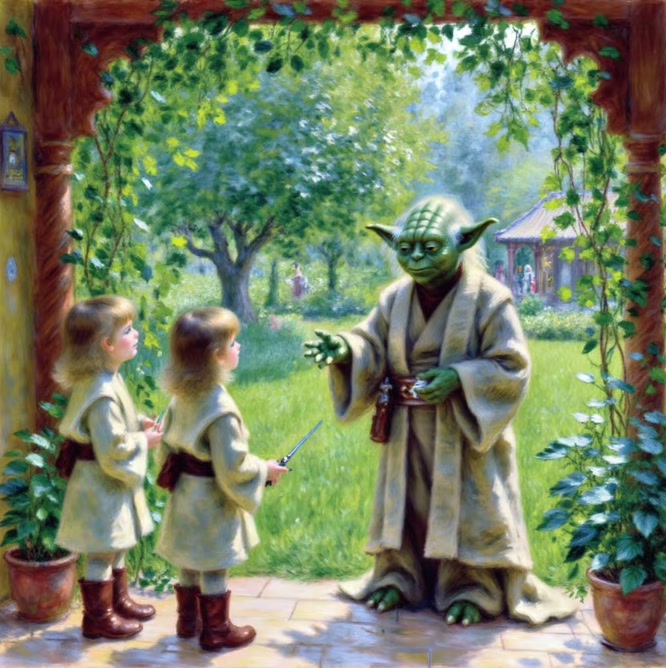
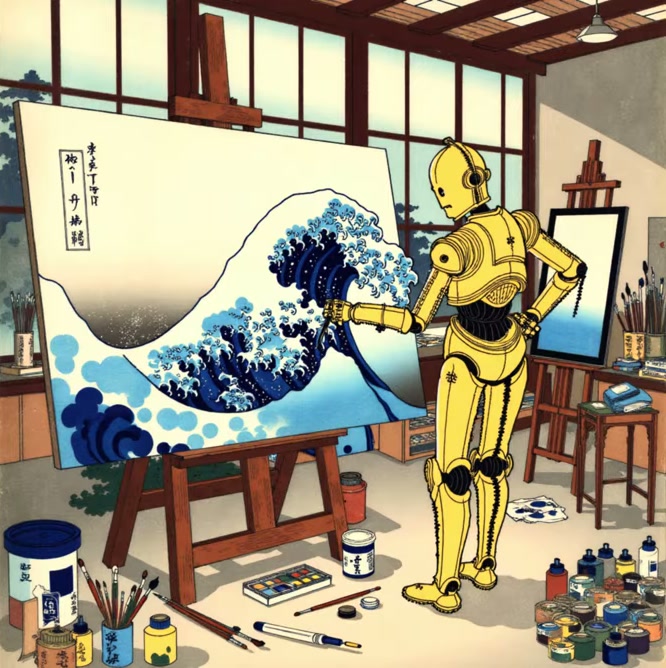
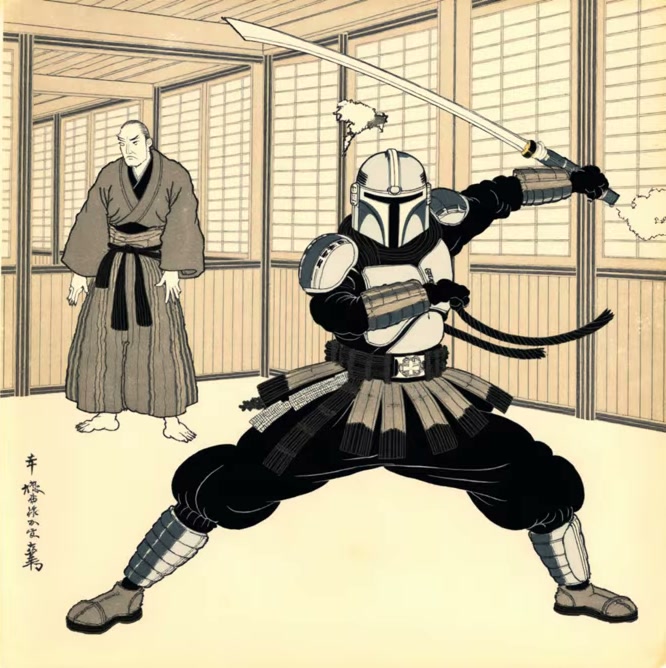
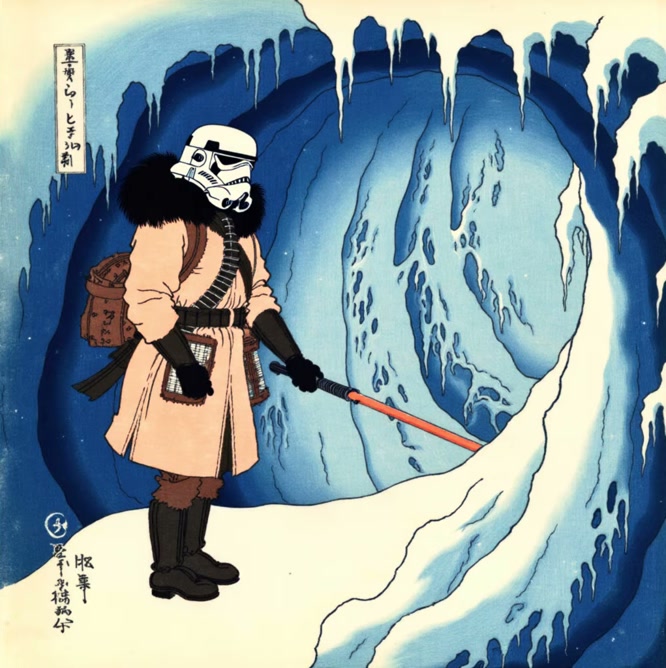
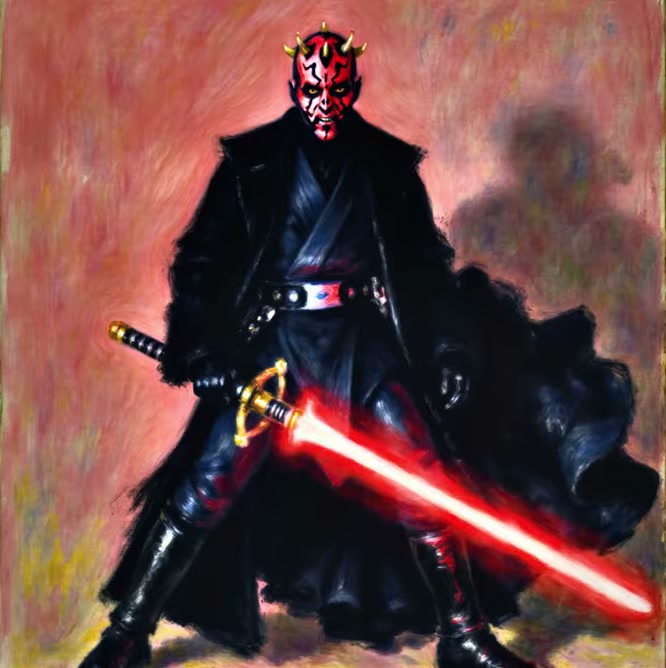
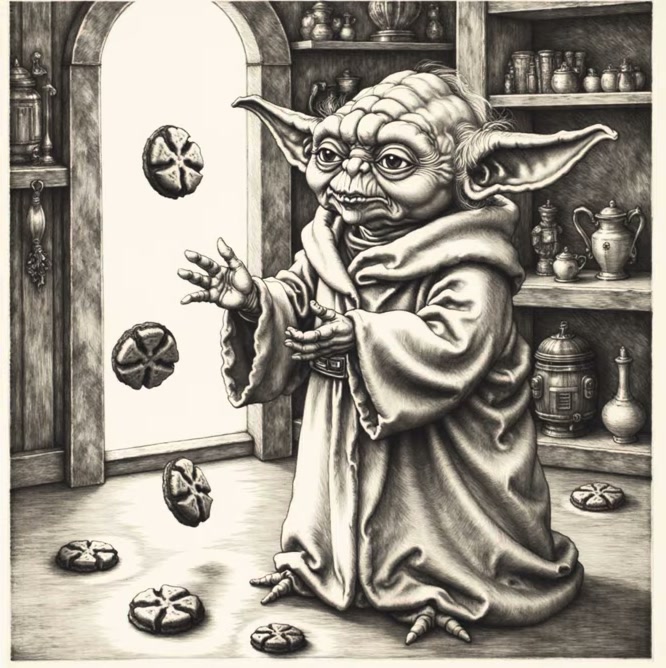
Les LoRA Renoir, Hokusai et Dürer, à partir de la même liste de prompts nocturne.
Où l’exécuter
Entraîner et exécuter sont deux tâches différentes, et j’utilise un endroit différent pour chacune :
| Tâche | Où je la fais | Coût |
|---|---|---|
| Entraîner le LoRA | fal | Environ 2 $ par LoRA |
| Tests rapides | fal | Environ 4 ¢ par image |
| Lots de nuit dans ComfyUI | Votre propre GPU de 12 Go ou plus, ou un GPU cloud | L’électricité, ou à partir de 0,27 $/h pour une RTX A5000 sur RunPod |
Quand j’ai enregistré cette vidéo, ComfyUI tournait sur ma propre RTX A5000. Depuis, je suis passé à RunPod : les modèles vivent sur un volume réseau, et je ne loue un GPU que le temps d’un lot. Si vous avez déjà une carte de 12 Go ou plus, exécutez-le en local. C’est gratuit, hors électricité. Sinon, louer revient bien moins cher qu’acheter. Mon introduction à RunPod couvre la mise en place, les coûts et le choix du GPU.
Si vous voulez l'essayer, voici mon lien de parrainage RunPod : vous recevez entre 5 et 500 $ de crédit après vos 10 premiers dollars (inscription avec Google), et je touche une petite commission.
Erreurs à éviter
- Un mot déclencheur courant.
monetéchoue ;monet123fonctionne. - Des styles mélangés dans le jeu d’entraînement. Dix images cohérentes valent mieux que trente mélangées.
- La mauvaise résolution. Restez autour de 1 mégapixel.
- Une guidance trop élevée. Au-dessus d’environ 3, l’image commence à brûler.
- Le LoRA dans le mauvais dossier. Il doit être dans
models/loras. - Un fichier de prompts cassé. Des majuscules, une ligne négative vide ou le mauvais dossier bloqueront le graphe.
- Un nombre de boucles qui ne correspond pas. Comptez vous-même les prompts.
Une note sur le droit d’auteur
Dürer, Hokusai et Renoir sont depuis longtemps libres de droits. Les artistes vivants, c’est autre chose. J’ai entraîné des LoRA sur le style d’amis avec leur permission, je leur ai montré les résultats et je les ai gardés privés. Demandez d’abord. Et j’ai utilisé ici des personnages de Star Wars pour le plaisir, pas pour quoi que ce soit que je vendrais.
Les workflows LoRA et liste de prompts, ainsi que mes trois LoRA d’artistes, sont sur Patreon.
Voir la version vidéo (19:53)
Tout ce qui précède est aussi dans la vidéo, si vous préférez suivre à l’écran. La vidéo est en anglais.
Questions fréquentes
De combien d'images ai-je besoin pour entraîner un LoRA ?
Pour un LoRA de style, de 6 à 15 images dans un style cohérent. Un style très marqué peut fonctionner avec seulement cinq.
Combien coûte l'entraînement d'un LoRA ?
Environ 2 $ sur fal avec les étapes par défaut, ou environ 4 $ à 2 000 étapes. Les tests coûtent environ 4 centimes par image.
Combien de temps dure l'entraînement d'un LoRA ?
De cinq à dix minutes sur fal pour un LoRA de style.
De quel GPU ai-je besoin pour utiliser un LoRA Flux ?
Environ 12 Go de VRAM pour faire tourner Flux dev correctement. Si votre carte est plus petite, un GPU cloud comme la RTX A5000 convient.
Qu'est-ce qu'un mot déclencheur ?
Un mot unique que vous ajoutez à votre prompt pour activer le LoRA. Choisissez quelque chose que Flux n'a jamais vu, comme renoir123, pas un vrai nom.

Anton Tenitsky est artiste 3D avec plus de 15 ans d'expérience en infographie, qui a travaillé avec Nickelodeon, Gameloft, Marvel Rivals et de nombreux autres clients. En savoir plus sur moi