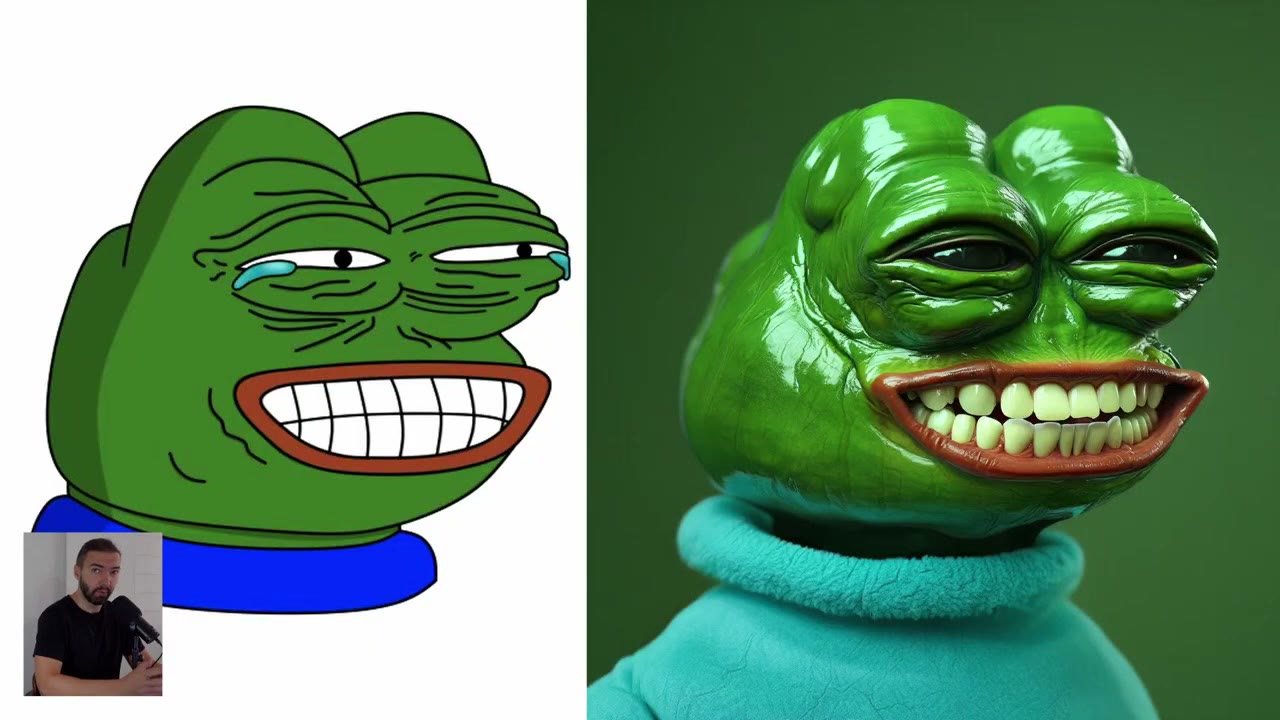
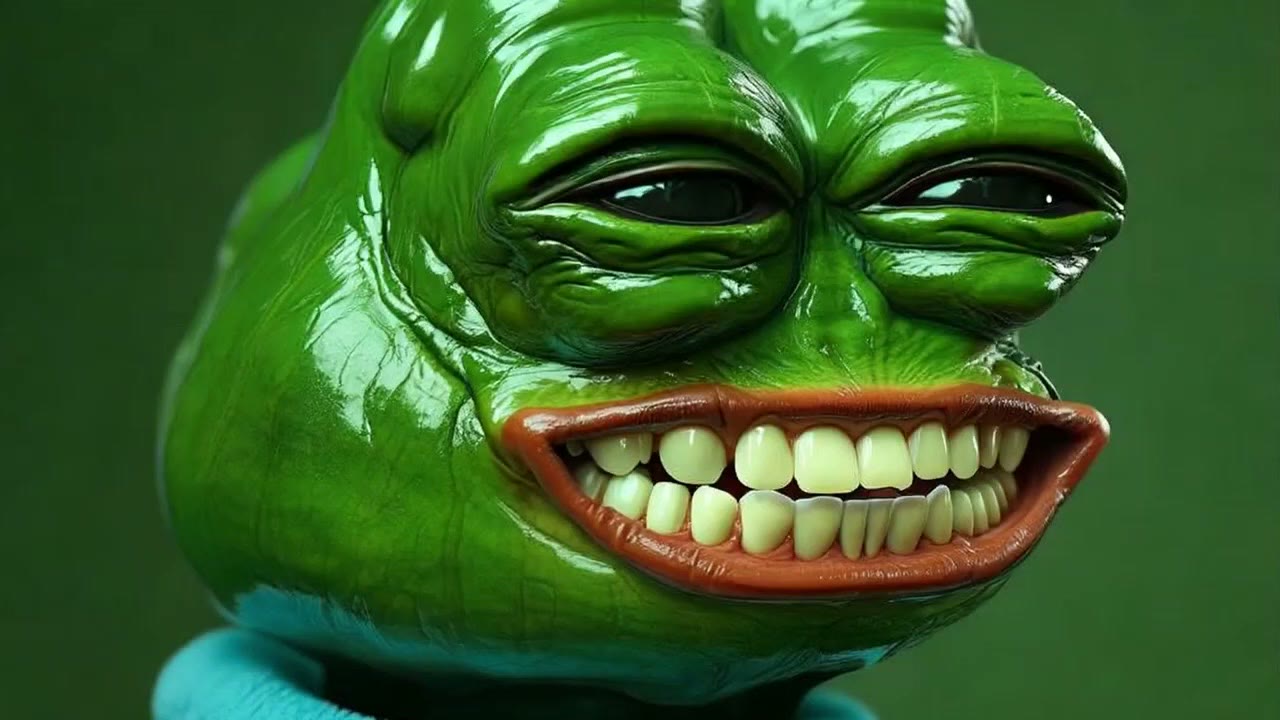
Un dessin animé plat n’a ni profondeur, ni peau, ni lumière. Flux peut ajouter les trois, si vous lui donnez la forme et décrivez le reste avec assez de détail. Ce guide transforme Pepe the Frog en un « vrai » Pepe photoréaliste et angoissant. Tout le mérite de Pepe revient à son créateur, Matt Furie.
Il tourne en local dans ComfyUI avec Flux dev, et demande une machine costaude : au moins 16 Go de VRAM, je dirais. J’ai 24 Go. Si ce n’est pas votre cas, le workflow tourne aussi dans le cloud (voir la fin).
En bref
- Forme : Depth Anything lit la profondeur même d’un dessin animé plat.
- ControlNet : Flux depth ControlNet ; moins de force donne plus de créativité au modèle.
- Prompt : la description du croquis comme une photo par ChatGPT, retouchée à la main : c’est de là que vient le résultat.
- Sampler : 25 étapes, seed en increment.
- Animation : Seedance sur fal, de 20 à 74 centimes pour cinq secondes.
Le workflow
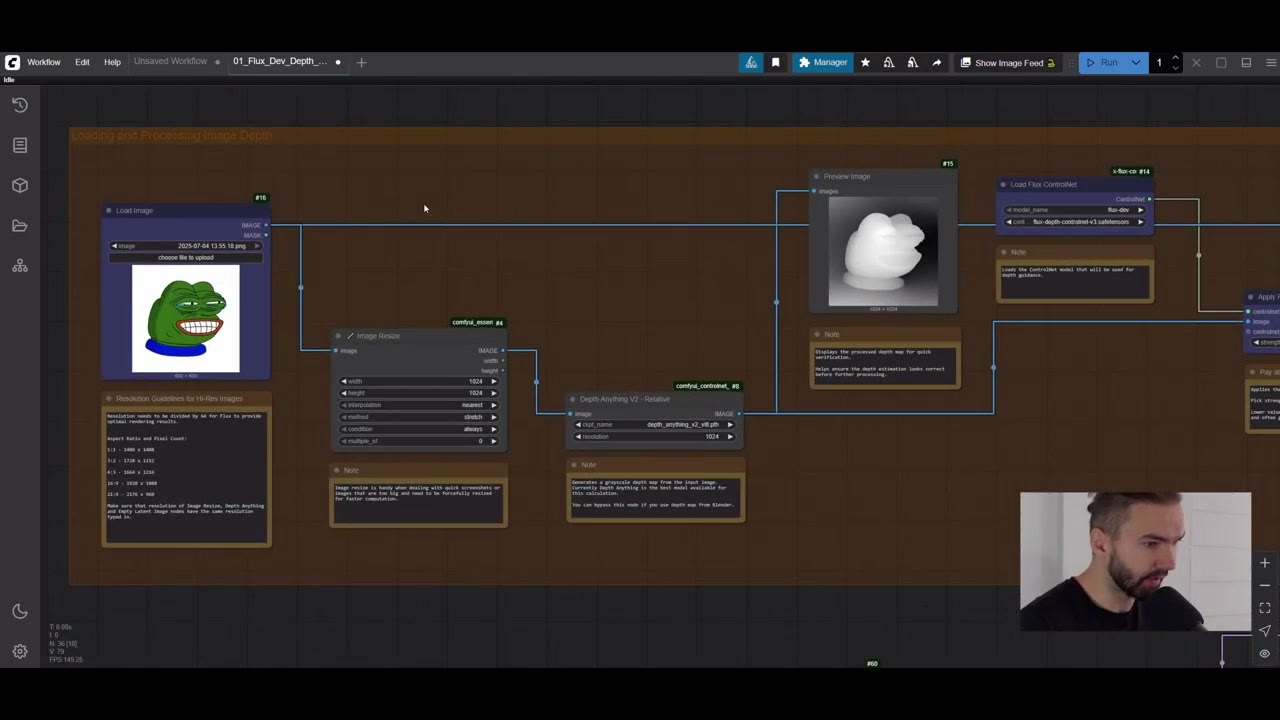
C’est un réseau simple. La seule partie inhabituelle est la lecture de la profondeur à partir d’un croquis. Il vous faudra comfyui_controlnet_aux, rgthree, x-flux-comfyui, ComfyUI Essentials et ComfyUI-GGUF depuis le Manager.
1. La profondeur à partir du dessin
Chargez l’image (la mienne était carrée) et redimensionnez-la à 1024 pixels. Depth Anything extrait alors une carte de profondeur, même d’un croquis plat : les valeurs blanches sont près de vous, les valeurs noires sont loin. C’est ce qui aide Flux à comprendre le dessin comme une forme 3D. (Le réglage de résolution propre à Depth Anything redimensionne déjà à 1024, vous pouvez donc contourner le node de redimensionnement séparé.)
2. Le ControlNet
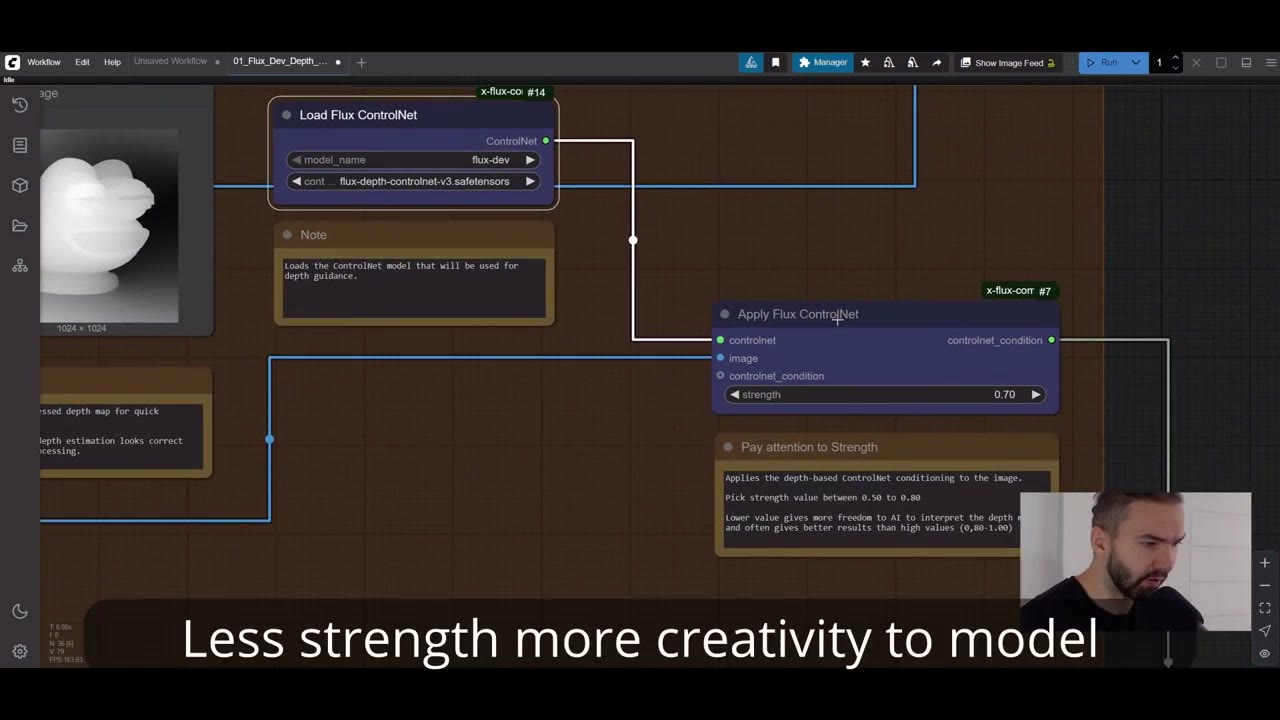
Load Flux ControlNet charge un ControlNet de profondeur pour Flux capable d’interpréter l’image de profondeur, et Apply Flux ControlNet le combine avec la carte de profondeur. Le résultat alimente l’entrée ControlNet du XLabs Sampler. La force contrôle la rigueur avec laquelle la profondeur est suivie : moins de force donne plus de créativité au modèle.
3. Modèle et toile
Flux dev va dans l’entrée de modèle du sampler. L’Empty Latent Image doit correspondre à la taille de votre image de profondeur : 1024 × 1024 ici. Le paysage fonctionne aussi ; changez simplement la taille partout. Des notes dans le workflow listent de bonnes résolutions.
4. Le prompt : d’où vient vraiment le résultat
Le DualCLIPLoader charge les deux encodeurs de texte de Flux (T5 XXL et CLIP-L, tous deux dans le Model Manager). Le prompt négatif reste vide ; Flux n’en utilise pas comme SDXL.
Pour le prompt positif, j’ai donné le croquis de Pepe à ChatGPT en lui demandant un prompt décrivant une image photoréaliste de celui-ci. Puis je l’ai retouché. La tête bulbeuse ne sortait pas correctement, et elle était trop lisse, j’ai donc ajouté des rides partout. Cela a fait une grande différence.
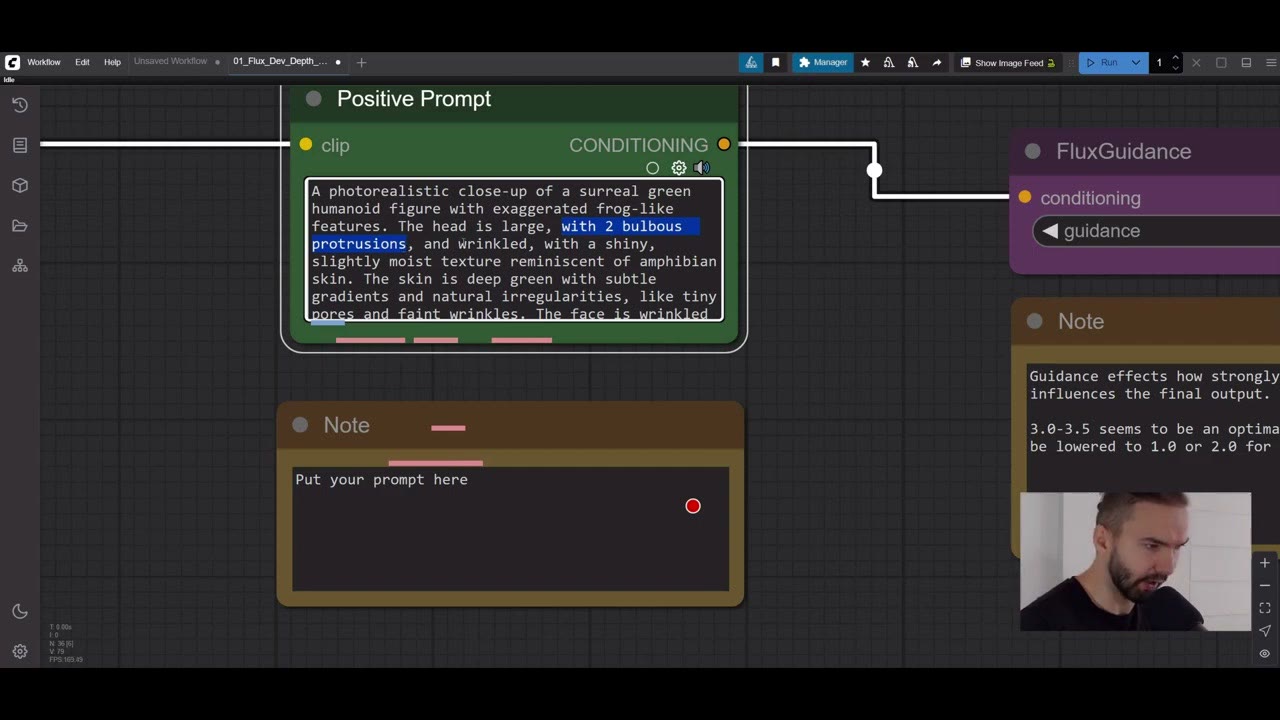
Voici le prompt complet (il peut être plus court) :
A photorealistic close-up of a surreal green humanoid figure with exaggerated frog-like features. The head is large, bulbous, wrinkly with a shiny, slightly moist texture reminiscent of amphibian skin. The skin is deep green with subtle gradients and natural irregularities, like tiny pores and faint wrinkles. The face shows an awkward forced grin, exposing perfectly aligned, unnaturally bright white teeth. The mouth is wide with pronounced reddish-brown lips that contrast with the green skin. The figure's eyes are narrow and squinting in the middle of the face, with small black pupils looking slightly to the side, very wrinkly on sides. At the corners of the eyes are glistening tear streaks, as if the character is crying while smiling. The tears reflect ambient light, adding to the surreal emotional contrast. The neck is thick, and the figure wears a plain, bright blue fabric collar that appears slightly soft and textured, like fleece or cotton. The lighting is studio-like with soft shadows, emphasizing the glossy, slimy surface of the skin and the moisture of the tears. No nostrils.Remarquez la part qui décrit les matières et la lumière : peau humide, pores, larmes brillantes, polaire, ombres de studio. C’est ce qui transforme un dessin animé en photo. Les deux prompts passent par Flux Guidance vers le conditionnement du sampler.
5. Échantillonner, décoder, enregistrer
- Étapes : 25, pour une qualité un peu meilleure. Je laisse les autres réglages tels quels ; ils marchent.
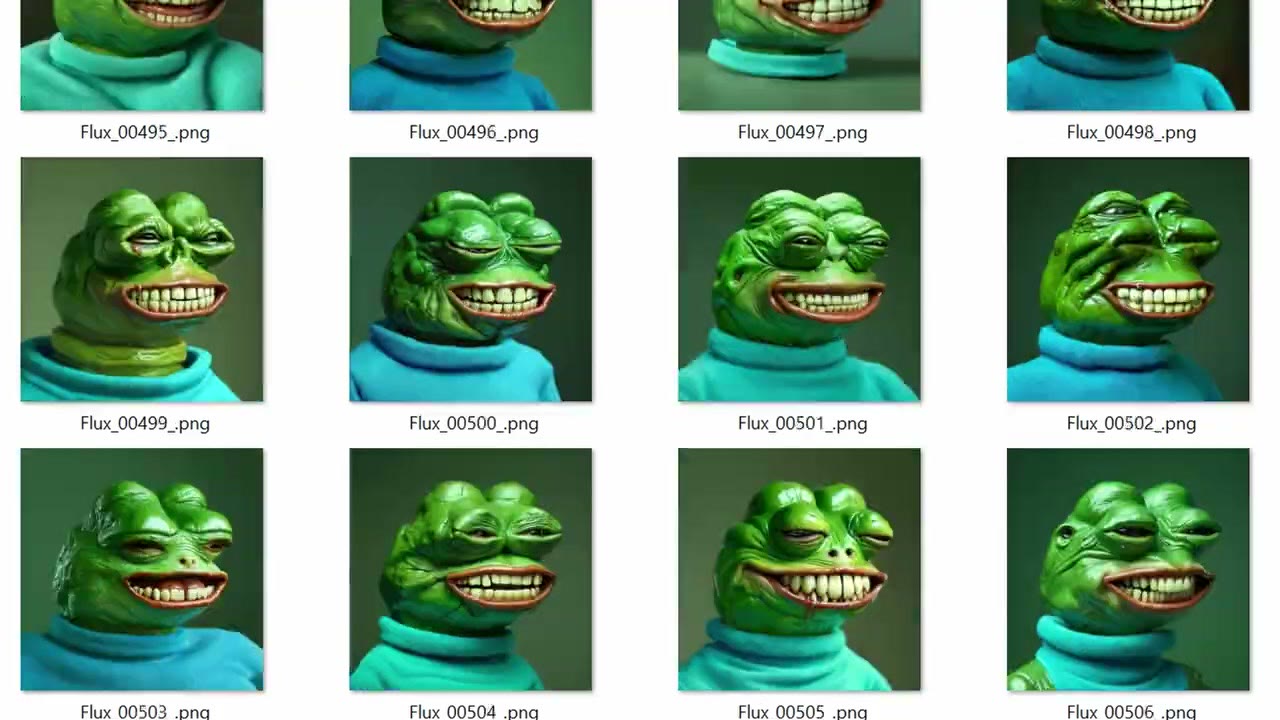
- Seed en increment. Sur quelques semaines, j’ai fait environ 2 000 images, et chaque nouvelle est simplement le nombre suivant, ce qui rend les exécutions de nuit faciles à suivre.
VAE Decode retransforme le résultat en pixels. Le sampler travaille dans l’espace latent, une version compressée de l’image huit fois plus petite, il faut donc la décoder. Un node de comparaison montre l’avant et l’après, et l’image est enregistrée avec le préfixe « flux ».
L’animer avec Seedance sur fal
Pour le faire bouger, j’ai utilisé fal et le modèle d’image vers vidéo Seedance de ByteDance (cherchez « Seedance » et choisissez image vers vidéo). Envoyez l’image et écrivez un prompt de mouvement. J’ai copié mon prompt Flux et ajouté « squinting » au début ; effort minimal, et cela a bien marché. À la fin, c’est vraiment angoissant.
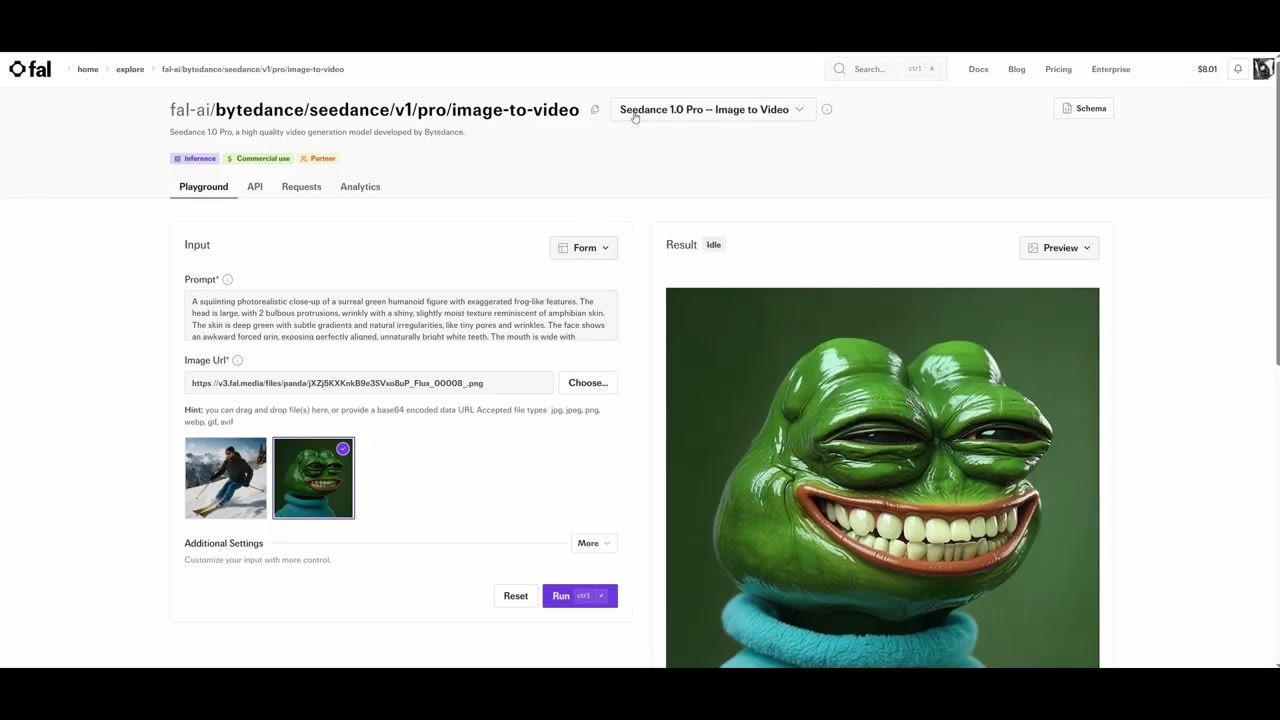
Coût : Seedance Lite coûte environ 20 centimes pour cinq secondes, ce qui est bon marché selon tous les critères. J’ai utilisé Pro pour une meilleure qualité sur YouTube, à 74 centimes.
Vous pouvez aussi animer en local dans ComfyUI, mais cela demande beaucoup plus de calcul et peut prendre une heure ou deux. Pour une animation de mème rapide, c’était la voie facile.
Pas de GPU de 16 Go ?
Le même workflow est configuré sur RunComfy, vous pouvez donc l’exécuter dans le navigateur. Aujourd’hui j’utilise RunPod pour ce genre de travail ; mon introduction à RunPod montre comment. Pour un aperçu pas à pas de la même configuration de profondeur sur n’importe quel croquis, voir du croquis à l’art avec Flux.
Le lien RunComfy est un lien de parrainage, tout comme mon lien de parrainage RunPod : les nouveaux comptes RunPod inscrits avec Google reçoivent entre 5 et 500 $ de crédit après leurs 10 premiers dollars, et je touche une petite commission.
Voir la version vidéo (7:37)
Tout ce qui précède est aussi dans la vidéo, si vous préférez suivre à l’écran. La vidéo est en anglais.
Questions fréquentes
De combien de VRAM ai-je besoin pour ce workflow Flux ?
Je dirais au moins 16 Go. Je l'ai fait tourner sur 24 Go. Avec moins, utilisez un GPU cloud.
Comment faire une version photoréaliste d'un dessin animé ?
Utilisez la carte de profondeur du dessin pour conserver la forme, puis décrivez-le en détail comme une photographie. J'ai demandé à ChatGPT un premier prompt à partir du croquis, puis je l'ai retouché à la main, en ajoutant des rides et en retirant ce qui ne marchait pas.
Combien coûte l'animation de l'image ?
Sur fal, Seedance Lite image vers vidéo coûtait environ 20 centimes pour cinq secondes ; la version Pro que j'ai utilisée a coûté 74 centimes.

Anton Tenitsky est artiste 3D avec plus de 15 ans d'expérience en infographie, qui a travaillé avec Nickelodeon, Gameloft, Marvel Rivals et de nombreux autres clients. En savoir plus sur moi