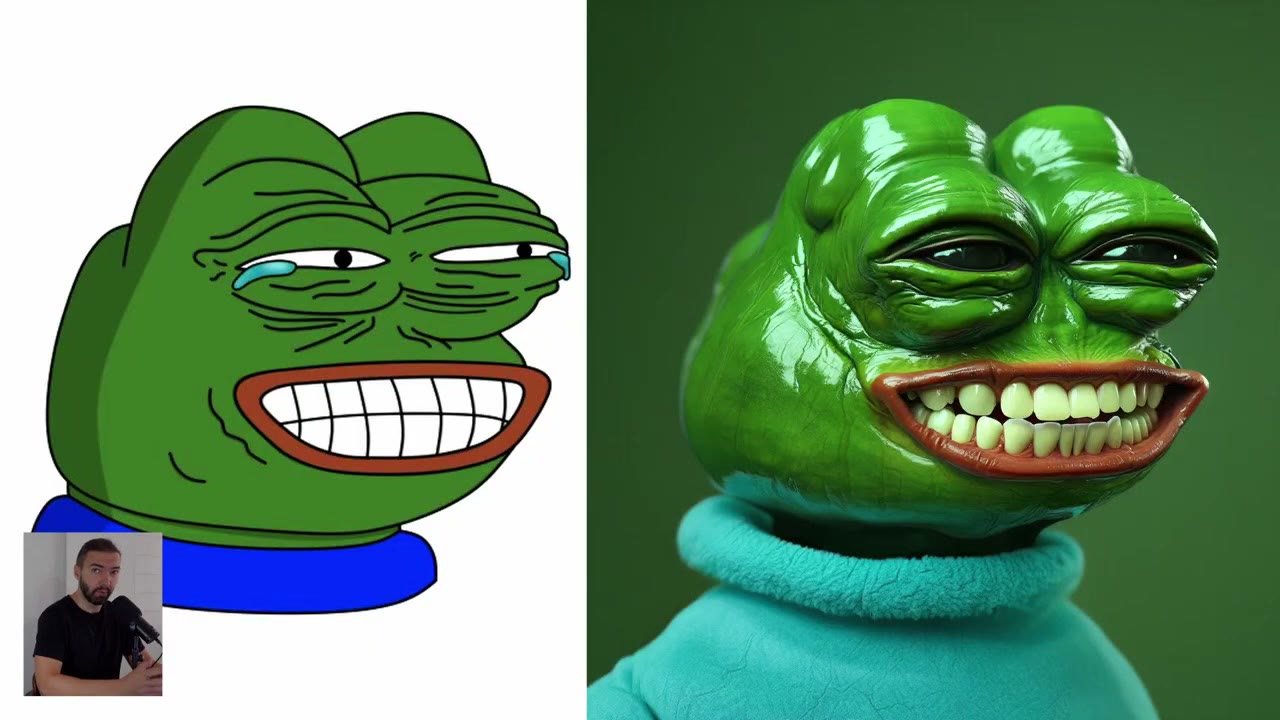
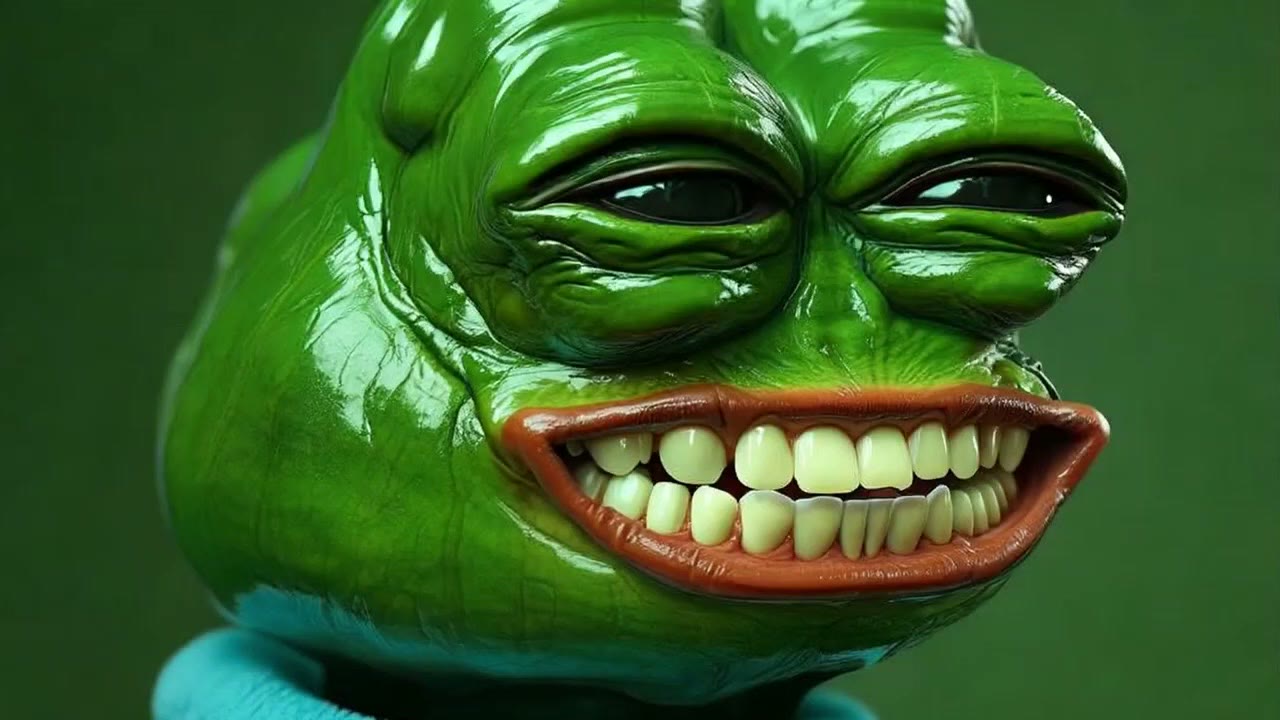
Ein flacher Cartoon hat keine Tiefe, keine Haut und kein Licht. Flux kann alle drei hinzufügen, wenn du ihm die Form gibst und den Rest ausreichend detailliert beschreibst. Dieser Leitfaden verwandelt Pepe the Frog in einen gruseligen, fotorealistischen „echten“ Pepe. Alle Ehre für Pepe gebührt seinem Schöpfer, Matt Furie.
Er läuft lokal in ComfyUI mit Flux dev und braucht eine kräftige Maschine: mindestens 16 GB VRAM, würde ich sagen. Ich habe 24 GB. Wenn du das nicht hast, läuft der Workflow auch in der Cloud (siehe das Ende).
Kurz gefasst
- Form: Depth Anything liest Tiefe selbst aus einem flachen Cartoon.
- ControlNet: Flux Depth ControlNet; weniger Stärke gibt dem Modell mehr Kreativität.
- Prompt: ChatGPTs Beschreibung der Skizze als Foto, von Hand bearbeitet: Daher kommt das Ergebnis.
- Sampler: 25 Schritte, Seed auf increment.
- Animation: Seedance auf fal, 20–74 Cent für fünf Sekunden.
Der Workflow
Es ist ein einfaches Netz. Der einzige ungewöhnliche Teil ist das Lesen von Tiefe aus einer Skizze. Du brauchst comfyui_controlnet_aux, rgthree, x-flux-comfyui, ComfyUI Essentials und ComfyUI-GGUF aus dem Manager.
1. Tiefe aus der Zeichnung
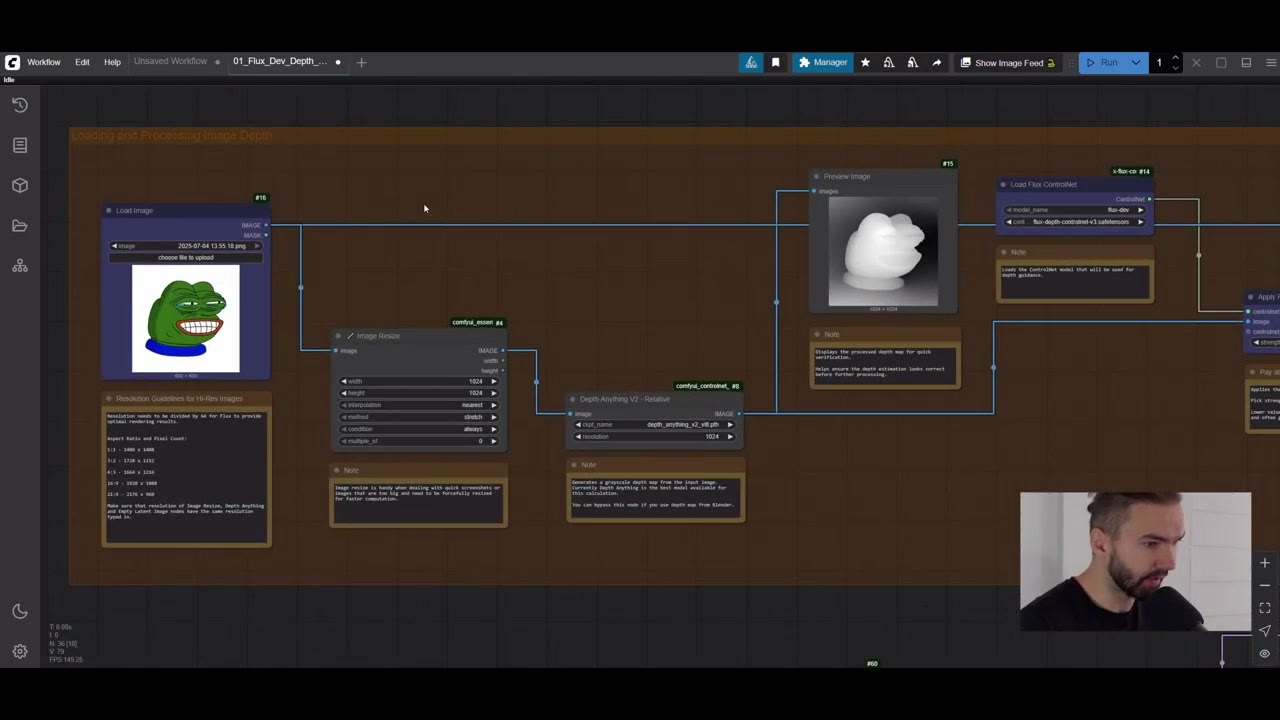
Lade das Bild (meines war quadratisch) und skaliere es auf 1024 Pixel. Depth Anything extrahiert dann eine Tiefenkarte, selbst aus einer flachen Skizze: Weiße Werte sind nah bei dir, schwarze Werte weit weg. Das hilft Flux, die Zeichnung als 3D-Form zu verstehen. (Die eigene Auflösungseinstellung von Depth Anything skaliert bereits auf 1024, du kannst also den separaten Skalierungs-Node umgehen.)
2. Das ControlNet
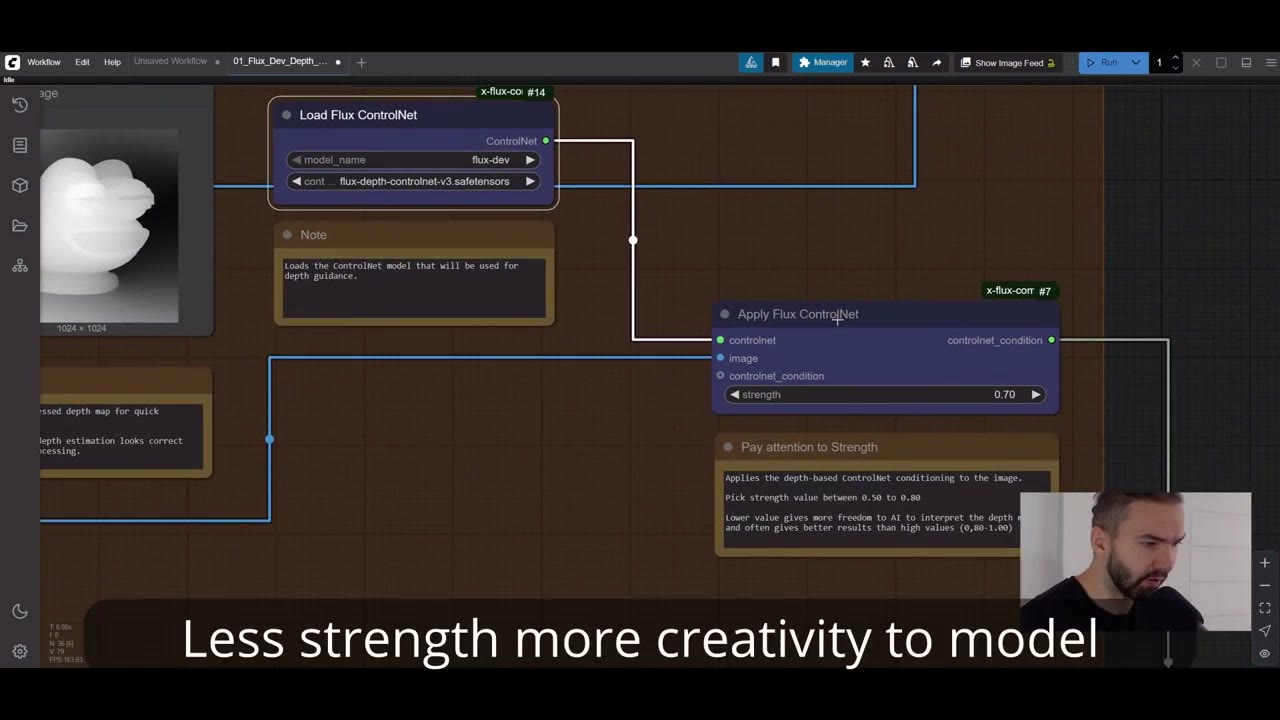
Load Flux ControlNet lädt ein Flux-Depth-ControlNet, das das Tiefenbild interpretieren kann, und Apply Flux ControlNet kombiniert es mit der Tiefenkarte. Das Ergebnis speist den ControlNet-Eingang des XLabs Sampler. Die Stärke steuert, wie streng die Tiefe befolgt wird: weniger Stärke gibt dem Modell mehr Kreativität.
3. Modell und Leinwand
Flux dev geht in den Modell-Eingang des Samplers. Das Empty Latent Image muss zur Größe deines Tiefenbildes passen: hier 1024 × 1024. Querformat funktioniert auch; ändere einfach die Größe überall. Notizen im Workflow listen gute Auflösungen auf.
4. Der Prompt: Woher das Ergebnis wirklich kommt
Der DualCLIPLoader lädt Flux’ zwei Text-Encoder (T5 XXL und CLIP-L, beide im Model Manager). Der negative Prompt bleibt leer; Flux nutzt keinen wie SDXL.
Für den positiven Prompt gab ich ChatGPT die Pepe-Skizze und bat um einen Prompt, der ein fotorealistisches Bild davon beschreibt. Dann habe ich ihn bearbeitet. Der bauchige Kopf kam nicht richtig heraus und war zu glatt, also fügte ich überall Falten hinzu. Das machte einen großen Unterschied.
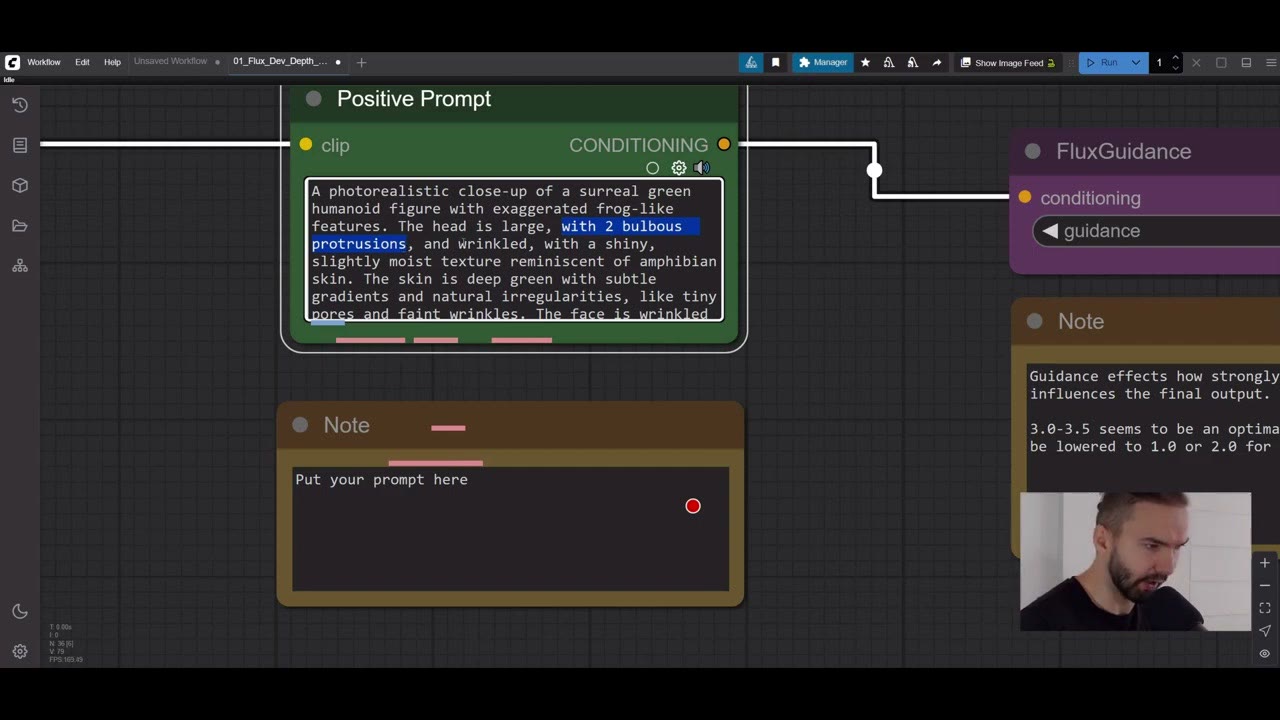
Hier ist der vollständige Prompt (er kann kürzer sein):
A photorealistic close-up of a surreal green humanoid figure with exaggerated frog-like features. The head is large, bulbous, wrinkly with a shiny, slightly moist texture reminiscent of amphibian skin. The skin is deep green with subtle gradients and natural irregularities, like tiny pores and faint wrinkles. The face shows an awkward forced grin, exposing perfectly aligned, unnaturally bright white teeth. The mouth is wide with pronounced reddish-brown lips that contrast with the green skin. The figure's eyes are narrow and squinting in the middle of the face, with small black pupils looking slightly to the side, very wrinkly on sides. At the corners of the eyes are glistening tear streaks, as if the character is crying while smiling. The tears reflect ambient light, adding to the surreal emotional contrast. The neck is thick, and the figure wears a plain, bright blue fabric collar that appears slightly soft and textured, like fleece or cotton. The lighting is studio-like with soft shadows, emphasizing the glossy, slimy surface of the skin and the moisture of the tears. No nostrils.Beachte, wie viel davon Materialien und Licht beschreibt: feuchte Haut, Poren, glänzende Tränen, Fleece, Studioschatten. Das ist es, was einen Cartoon in ein Foto verwandelt. Beide Prompts laufen durch Flux Guidance ins Conditioning des Samplers.
5. Sampeln, dekodieren, speichern
- Schritte: 25, für etwas bessere Qualität. Die anderen Einstellungen lasse ich, wie sie sind; sie funktionieren.
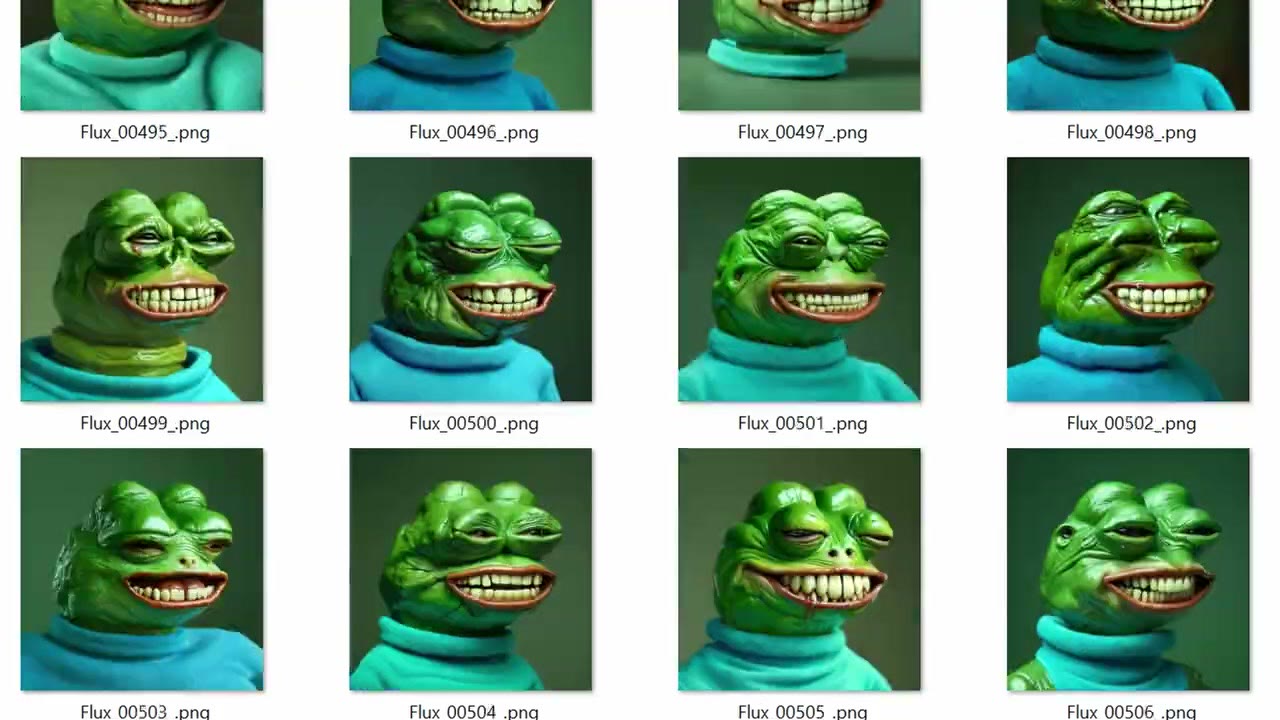
- Seed auf increment. In ein paar Wochen habe ich etwa 2.000 Bilder gemacht, und jedes neue ist einfach die nächste Zahl, was Läufe über Nacht leicht nachverfolgbar macht.
VAE Decode wandelt das Ergebnis zurück in Pixel um. Der Sampler arbeitet im latenten Raum, einer um das Achtfache kleineren komprimierten Version des Bildes, daher muss es dekodiert werden. Ein Vergleichs-Node zeigt das Vorher und Nachher, und das Bild wird mit dem Präfix „flux“ gespeichert.
Mit Seedance auf fal animieren
Damit es sich bewegt, habe ich fal und ByteDances Bild-zu-Video-Modell Seedance genutzt (suche nach „Seedance“ und wähle Image to Video). Lade das Bild hoch und schreibe einen Bewegungs-Prompt. Ich habe meinen Flux-Prompt kopiert und am Anfang „squinting“ hinzugefügt; minimaler Aufwand, und es funktionierte gut. Am Ende sieht es richtig gruselig aus.
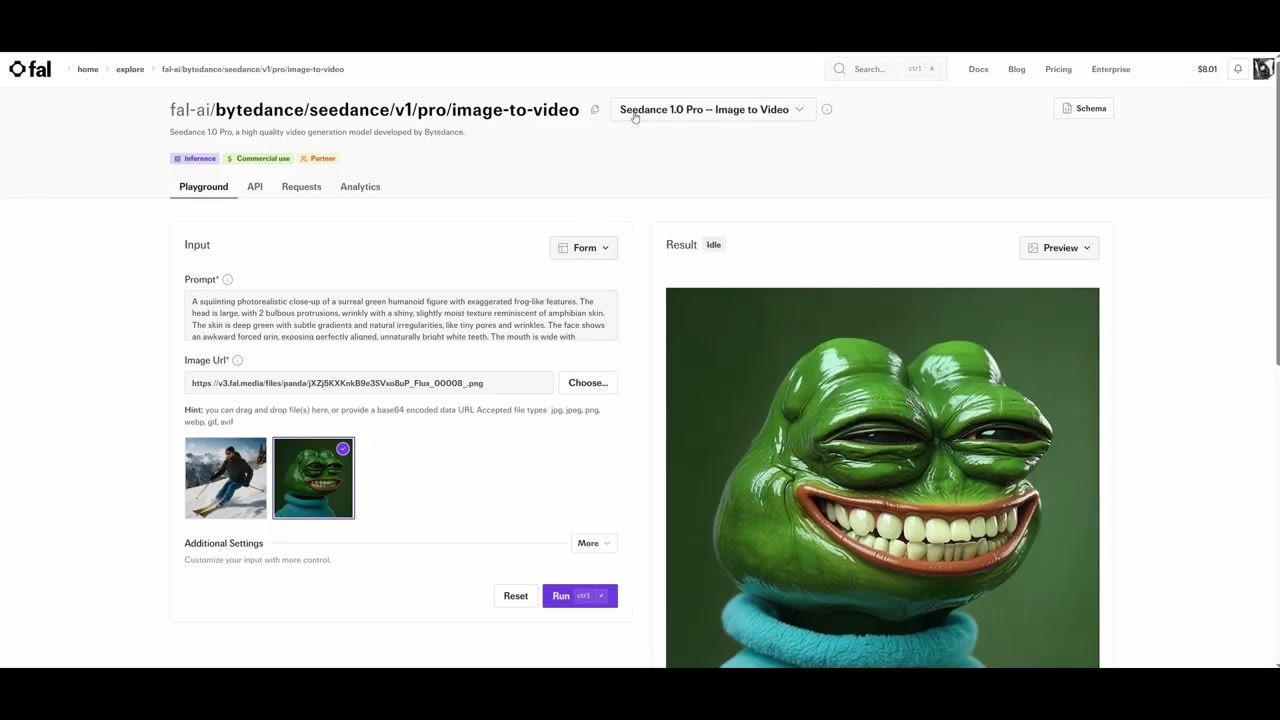
Kosten: Seedance Lite kostet etwa 20 Cent für fünf Sekunden, was nach jedem Maßstab günstig ist. Ich habe Pro für bessere Qualität auf YouTube genutzt, zu 74 Cent.
Du kannst auch lokal in ComfyUI animieren, aber das braucht viel mehr Rechenleistung und kann ein bis zwei Stunden dauern. Für eine schnelle Meme-Animation war dies der einfache Weg.
Keine 16-GB-GPU?
Derselbe Workflow ist bei RunComfy eingerichtet, sodass du ihn im Browser ausführen kannst. Heutzutage nutze ich RunPod für diese Art von Arbeit; meine Einführung in RunPod zeigt, wie. Für einen Schritt-für-Schritt-Blick auf dasselbe Tiefen-Setup bei jeder Skizze siehe Skizze zu Kunst mit Flux.
Der RunComfy-Link ist ein Empfehlungslink, ebenso mein RunPod-Empfehlungslink: Neue RunPod-Konten, die sich mit Google anmelden, erhalten nach ihren ersten 10 $ ein Guthaben von 5–500 $, und ich bekomme eine kleine Provision.
Die Videoversion ansehen (7:37)
Alles oben steht auch im Video, falls du lieber am Bildschirm mitmachst. Das Video ist auf Englisch.
Häufige Fragen
Wie viel VRAM brauche ich für diesen Flux-Workflow?
Ich würde sagen, mindestens 16 GB. Ich habe ihn mit 24 GB ausgeführt. Mit weniger nutze eine Cloud-GPU.
Wie mache ich eine fotorealistische Version eines Cartoons?
Nutze die Tiefenkarte der Zeichnung, um die Form zu behalten, und beschreibe sie dann detailliert als Fotografie. Ich ließ ChatGPT aus der Skizze einen ersten Prompt schreiben und habe ihn dann von Hand bearbeitet, Falten hinzugefügt und entfernt, was nicht funktionierte.
Wie viel kostet es, das Bild zu animieren?
Auf fal kostete Seedance Lite Bild-zu-Video etwa 20 Cent für fünf Sekunden; die Pro-Version, die ich nutzte, kostete 74 Cent.

Anton Tenitsky ist 3D-Artist mit mehr als 15 Jahren Erfahrung in der Computergrafik, tätig für Nickelodeon, Gameloft, Marvel Rivals und viele weitere Kunden. Mehr über mich