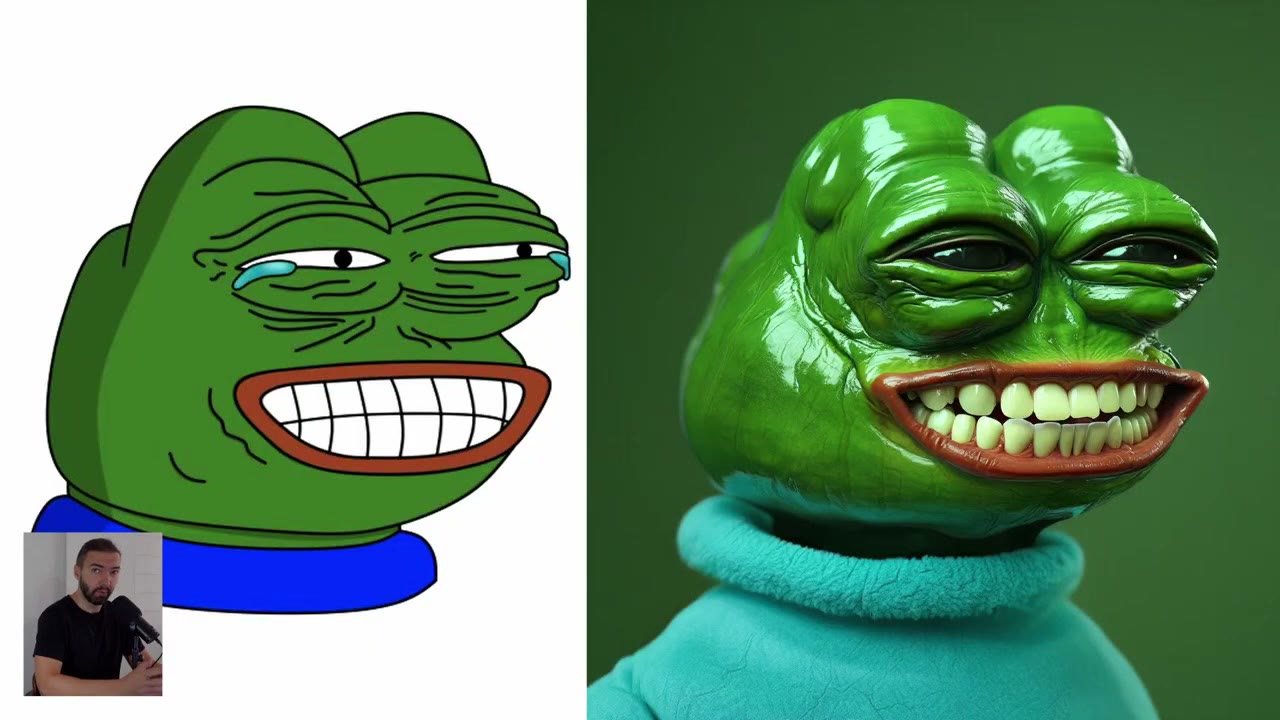
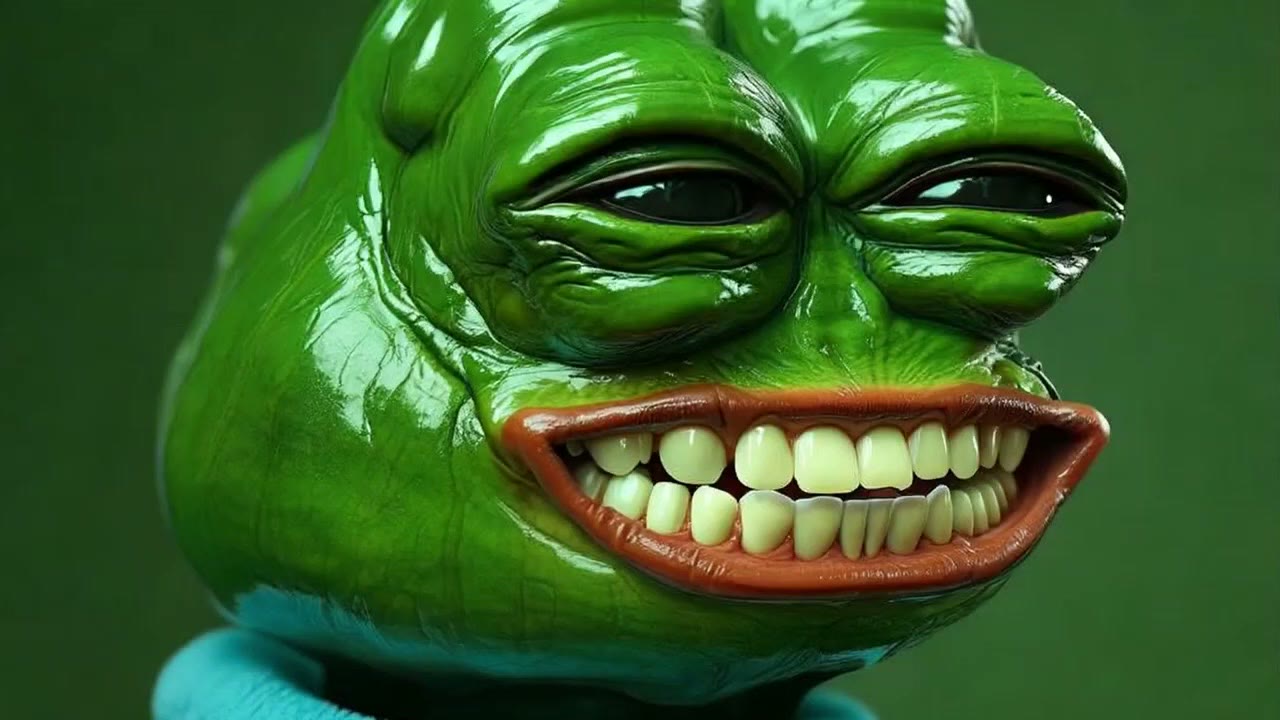
平面的な漫画には、奥行きも、肌も、光もありません。形を与え、残りを十分に詳しく記述すれば、Fluxはその3つすべてを加えられます。このガイドでは、カエルのペペを、不気味でフォトリアルな「本物の」ペペに変えます。ペペの功績はすべて、作者のマット・フューリーにあります。
Flux devを使い、ComfyUIでローカルに動かします。かなりのマシンが必要で、VRAMは最低16GBはほしいと思います。私は24GBです。なければ、このワークフローはクラウドでも動きます(最後を参照)。
ポイント
- 形: Depth Anythingは、平面的な漫画からでも深度を読み取ります。
- ControlNet: Flux depth ControlNet。強度を下げると、モデルがより創造的になります。
- プロンプト: ChatGPTによるスケッチの写真としての記述を、手作業で編集したもの。結果はここから生まれます。
- サンプラー: 25ステップ、seedはincrement。
- アニメーション: falのSeedanceで、5秒あたり20〜74セント。
ワークフロー
シンプルなネットワークです。珍しいのは、スケッチから深度を読む部分だけです。Managerから、comfyui_controlnet_aux、rgthree、x-flux-comfyui、ComfyUI Essentials、ComfyUI-GGUFが必要です。
1. 絵から深度を取る
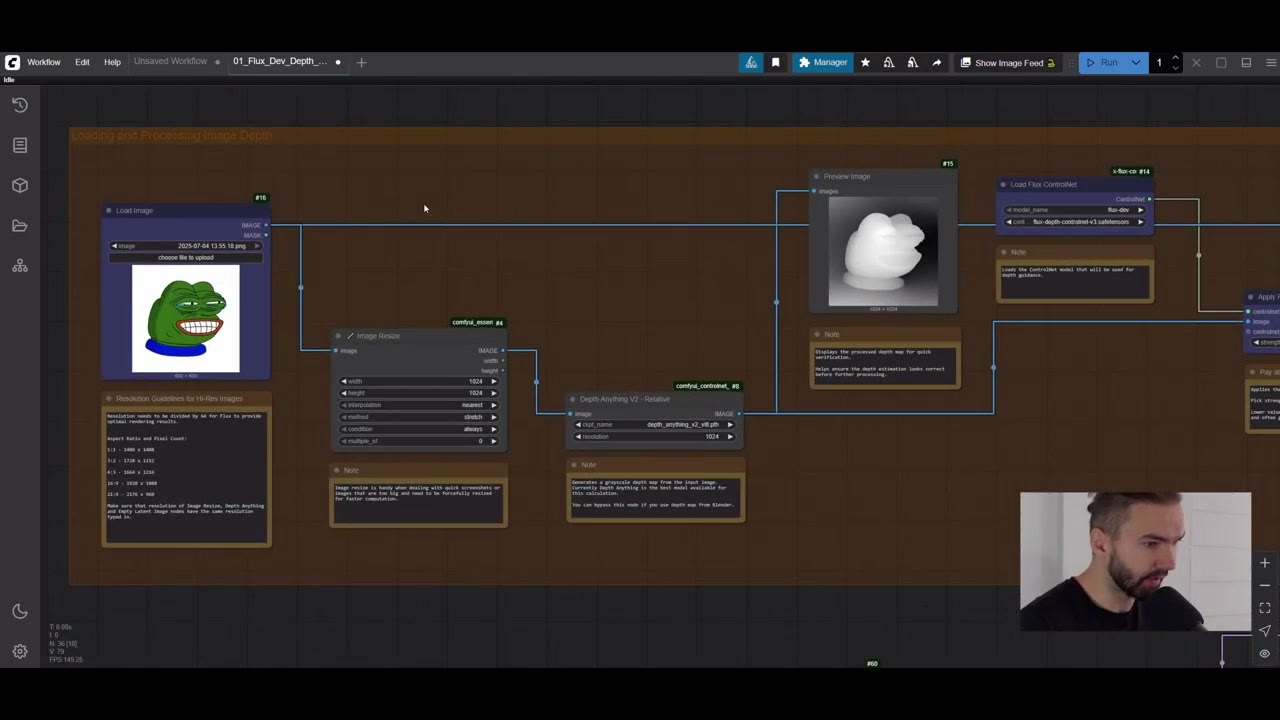
画像(私のは正方形)を読み込み、1024ピクセルにリサイズします。Depth Anythingが、平面的なスケッチからでも深度マップを抽出します。白い値が手前、黒い値が遠くです。これが、Fluxが絵を3次元の形として理解する助けになります。(Depth Anything自身の解像度設定がすでに1024にリサイズするので、別のリサイズノードはバイパスできます。)
2. ControlNet
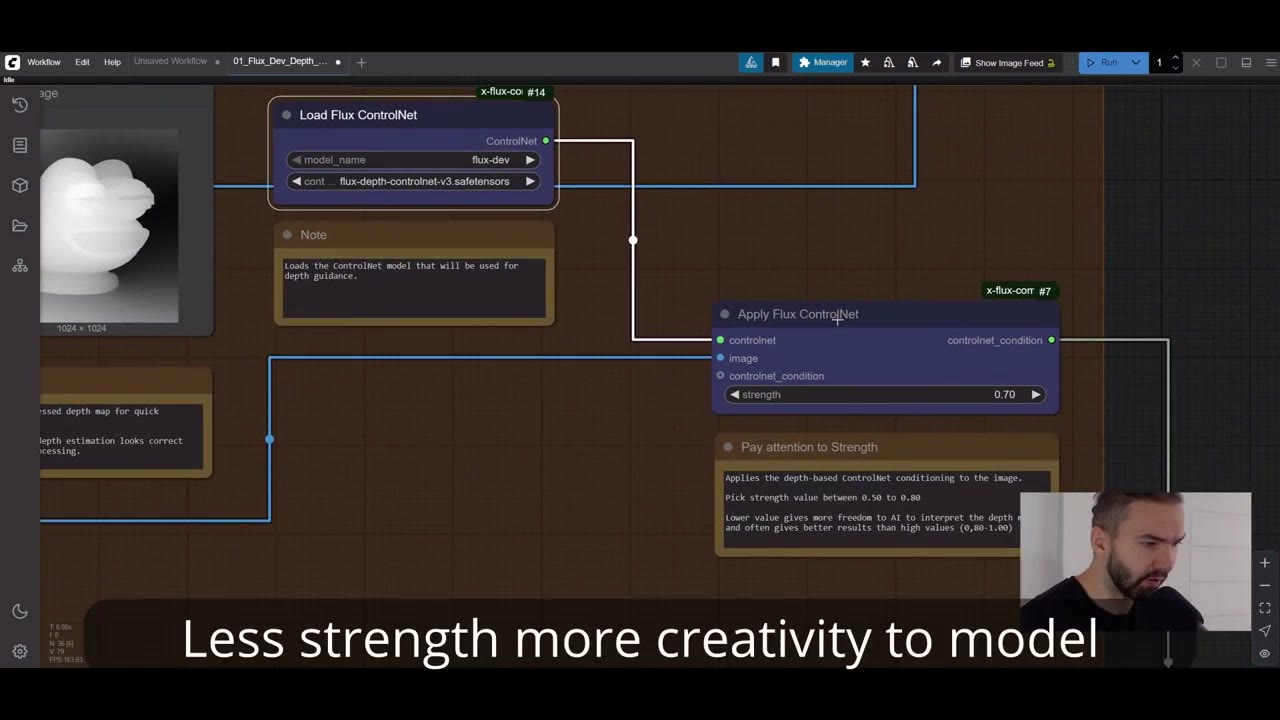
Load Flux ControlNetが、深度画像を解釈できるFlux depth ControlNetを読み込み、Apply Flux ControlNetがそれを深度マップと組み合わせます。結果は、XLabs SamplerのControlNet入力に入ります。Strengthは、深度にどれだけ厳密に従うかを制御します。強度を下げると、モデルがより創造的になります。
3. モデルとキャンバス
Flux devはサンプラーのモデル入力に入ります。Empty Latent Imageは深度画像のサイズと一致させる必要があり、ここでは1024 × 1024です。横向きでも動きます。すべての場所でサイズを変えるだけです。ワークフロー内のノートに、良好な解像度が載っています。
4. プロンプト:結果が本当に生まれる場所
DualCLIPLoaderが、Fluxの2つのテキストエンコーダー(T5 XXLとCLIP-L、どちらもModel Managerにあります)を読み込みます。ネガティブプロンプトは空のままです。FluxはSDXLのようには使いません。
ポジティブプロンプトは、ペペのスケッチをChatGPTに渡し、それのフォトリアルな画像を記述するプロンプトを頼みました。それから編集しました。球根のような頭がうまく出ず、滑らかすぎたので、全体にしわを加えました。それが大きな違いを生みました。
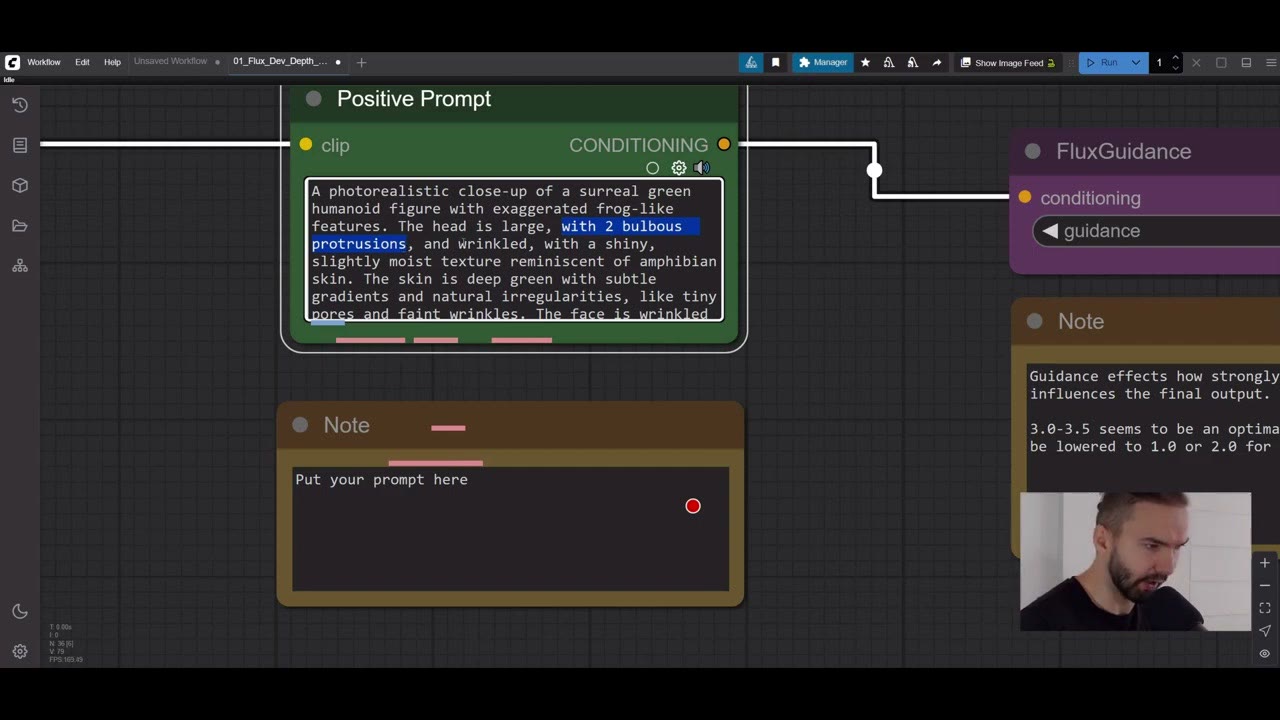
プロンプト全文はこちらです(もっと短くても構いません)。
A photorealistic close-up of a surreal green humanoid figure with exaggerated frog-like features. The head is large, bulbous, wrinkly with a shiny, slightly moist texture reminiscent of amphibian skin. The skin is deep green with subtle gradients and natural irregularities, like tiny pores and faint wrinkles. The face shows an awkward forced grin, exposing perfectly aligned, unnaturally bright white teeth. The mouth is wide with pronounced reddish-brown lips that contrast with the green skin. The figure's eyes are narrow and squinting in the middle of the face, with small black pupils looking slightly to the side, very wrinkly on sides. At the corners of the eyes are glistening tear streaks, as if the character is crying while smiling. The tears reflect ambient light, adding to the surreal emotional contrast. The neck is thick, and the figure wears a plain, bright blue fabric collar that appears slightly soft and textured, like fleece or cotton. The lighting is studio-like with soft shadows, emphasizing the glossy, slimy surface of the skin and the moisture of the tears. No nostrils.どれだけが素材と光の記述かに注目してください。湿った肌、毛穴、光る涙、フリース、スタジオの影。これが漫画を写真に変えるのです。2つのプロンプトはどちらもFlux Guidanceを通って、サンプラーのコンディショニングに入ります。
5. サンプル、デコード、保存
- Steps: 25で、少し品質を上げます。ほかの設定はそのままにしています。それで機能します。
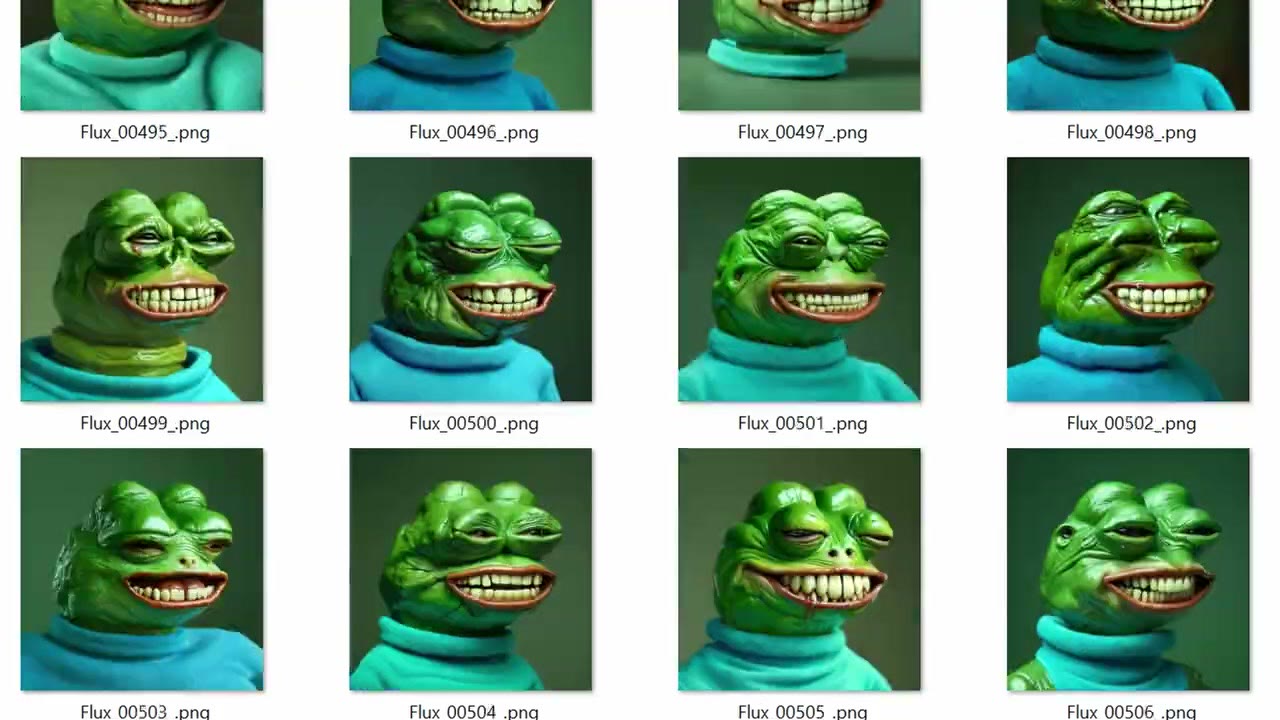
- Seedはincrement。 数週間で約2,000枚の画像を作り、新しい画像は単に次の番号になるので、一晩の実行も追跡しやすくなります。
VAE Decodeが、結果をピクセルに戻します。サンプラーは潜在空間、つまり画像を8分の1に圧縮したバージョンで動いているため、デコードが必要です。比較ノードが前後を表示し、画像はプレフィックス「flux」で保存されます。
falのSeedanceでアニメーション化する
動かすために、falとByteDanceのSeedance画像から動画へのモデルを使いました(「Seedance」を検索して、image to videoを選びます)。画像をアップロードして、動きのプロンプトを書きます。Fluxのプロンプトをコピーして、先頭にsquintingを加えました。最小限の手間でしたが、うまくいきました。最後には、ちゃんと不気味に見えます。
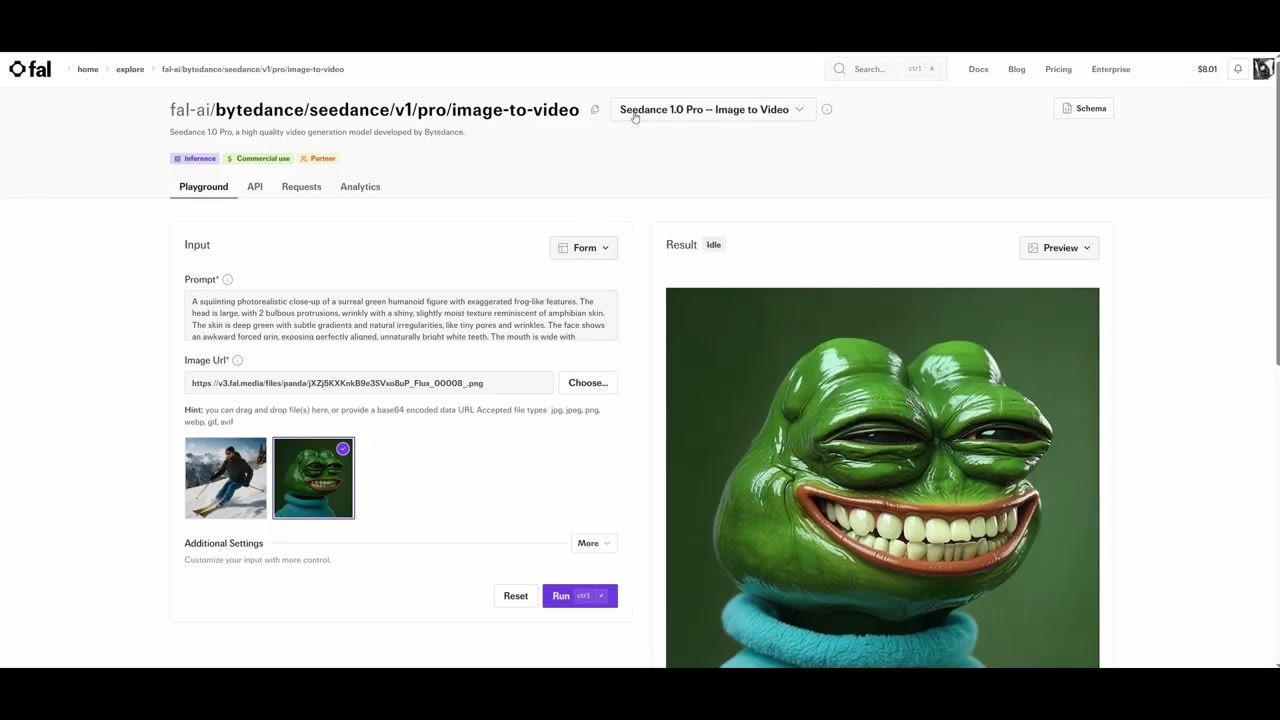
費用: Seedance Liteは5秒で約20セントで、どう見ても安価です。YouTube用により良い品質を得るためProを使い、74セントでした。
ComfyUIでローカルにアニメーション化することもできますが、はるかに多くの計算が必要で、1〜2時間かかることもあります。手早いミームのアニメーションには、これが簡単な方法でした。
VRAM 16GBのGPUがない?
同じワークフローは、ブラウザで実行できるRunComfyに設定されています。最近は、この種の作業にRunPodを使っています。RunPod入門で方法を説明しています。あらゆるスケッチに同じ深度の構成を使う手順は、Fluxでスケッチからアートへをご覧ください。
RunComfyのリンクは紹介リンクで、私のRunPod紹介リンクも同様です。Googleでサインアップした新規RunPodアカウントは最初の10ドルの利用後に5〜500ドル分のクレジットを受け取れ、私には少額の紹介報酬が入ります。
動画版を見る (7:37)
上の内容はすべて動画でも説明しています。画面を見ながら進めたい方はこちらをどうぞ。 動画は英語です。
よくある質問
このFluxのワークフローには、VRAMがどのくらい必要ですか?
最低16GBはほしいと思います。私は24GBで実行しました。それ以下なら、クラウドGPUを使ってください。
漫画をフォトリアルなバージョンにするにはどうしますか?
絵の深度マップで形を保ち、写真として詳細に記述します。私はスケッチからChatGPTに最初のプロンプトを書かせ、手作業で編集し、しわを加えてうまくいかない部分を削りました。
画像をアニメーション化するにはいくらかかりますか?
falでは、Seedance Liteの画像から動画への変換が5秒で約20セント、私が使ったPro版は74セントでした。

Anton Tenitsky は コンピュータグラフィックスで15年以上の経験を持つ3Dアーティストで、Nickelodeon、Gameloft、Marvel Rivalsをはじめ多くのクライアントと仕事をしてきました。 プロフィールを見る