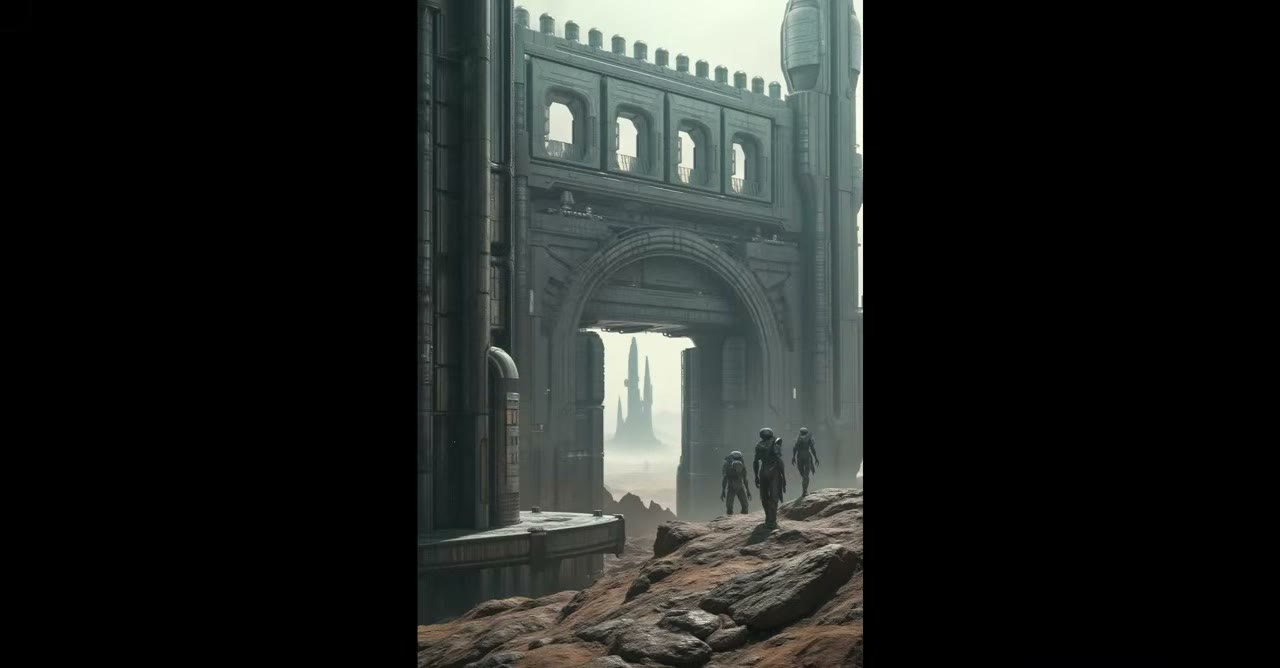
このワークフローにフォルダの写真を渡すと、写真の構造と構図を保ったまま、それ以外をすべて作り変えて、1枚ずつコンセプトアートにします。古い城壁に囲まれた砂漠の町の約700枚の写真パックで実行したところ、SFの塔、門、壁が生まれました。
ComfyUIで、Flux 1 devを使いローカルで動かします。あえてFlux 2は使いません。ずっと重くて遅く、アイデアを大量に生成するときには速度が重要だからです。Flux 1は、VRAM 8〜24GBのカードで動きます。
ポイント
- 入力: 写真のフォルダを、1枚ずつ読み込みます。
- 構造: Depth Anything V2の深度マップが、Flux depth ControlNetを動かします。
- 設定: ControlNetの強度は約0.8、Flux guidanceは3、25ステップ。
- 出力: すべての結果が、元の写真の名前で保存されます。
- 完成したワークフローは私のPatreonにありますが、秘密はありません。すべて以下で説明します。
必要なカスタムノード
すべてComfyUI Managerからインストールできます。
- 画像ユーティリティとリサイズ用のComfyUI EssentialsとKJNodes。
- Depth Anything V2ノードを提供するcomfyui_controlnet_aux。
- FluxのControlNetとサンプラー用のXLabsのx-flux-comfyui。
- ビフォーアフターの比較用のrgthree。
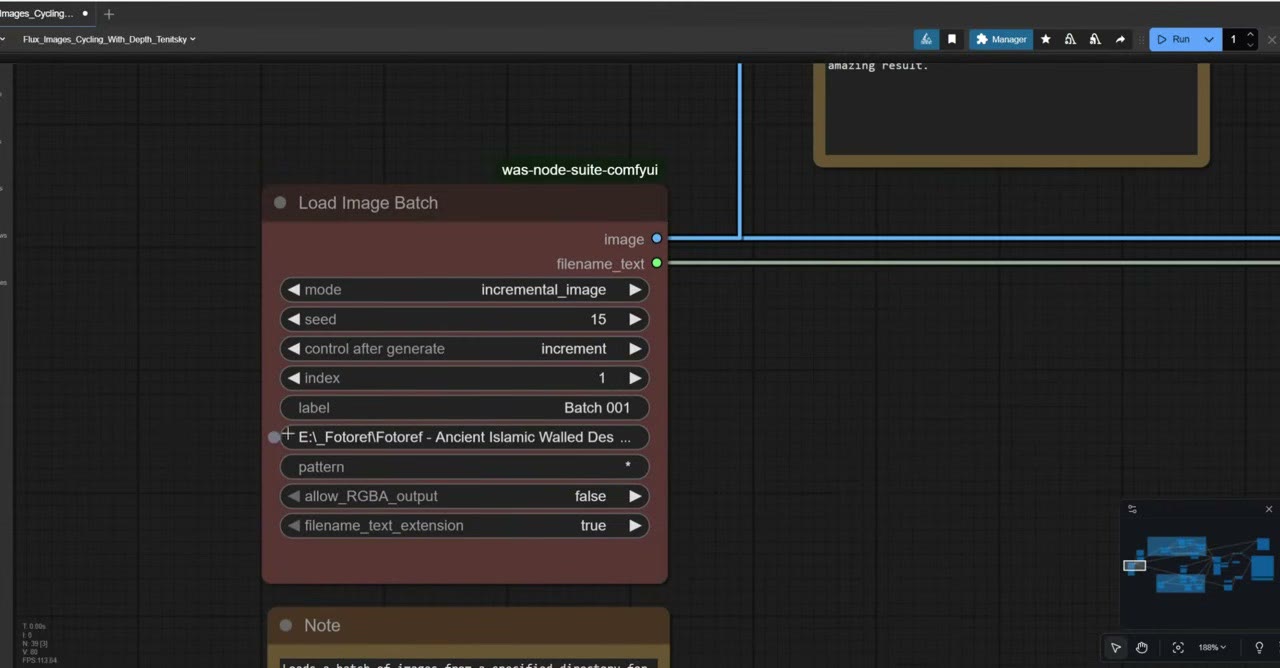
1. 写真をバッチで読み込む
Load Image Batchノードはフォルダを指定し、実行のたびに1枚ずつ進みます。隣のプレビューノードは、正しい画像が入っているかを確認するためのトラブルシューティング用です。
私の写真は大きく、動画のものは3867 × 2578ピクセルで、Fluxに必要な大きさをはるかに超えていました。次のノードが縮小します。
2. 深度マップを作ってリサイズする
Depth Anything V2ノードは2つの仕事をします。各写真をグレースケールの深度マップ(近くが明るく、遠くが暗い)に変換し、resolution設定で、短辺がそのピクセル数になるように写真を縮小します。長辺はそれに合わせて縮尺されます。縦向きでも横向きでも、比率はきちんと保たれます。
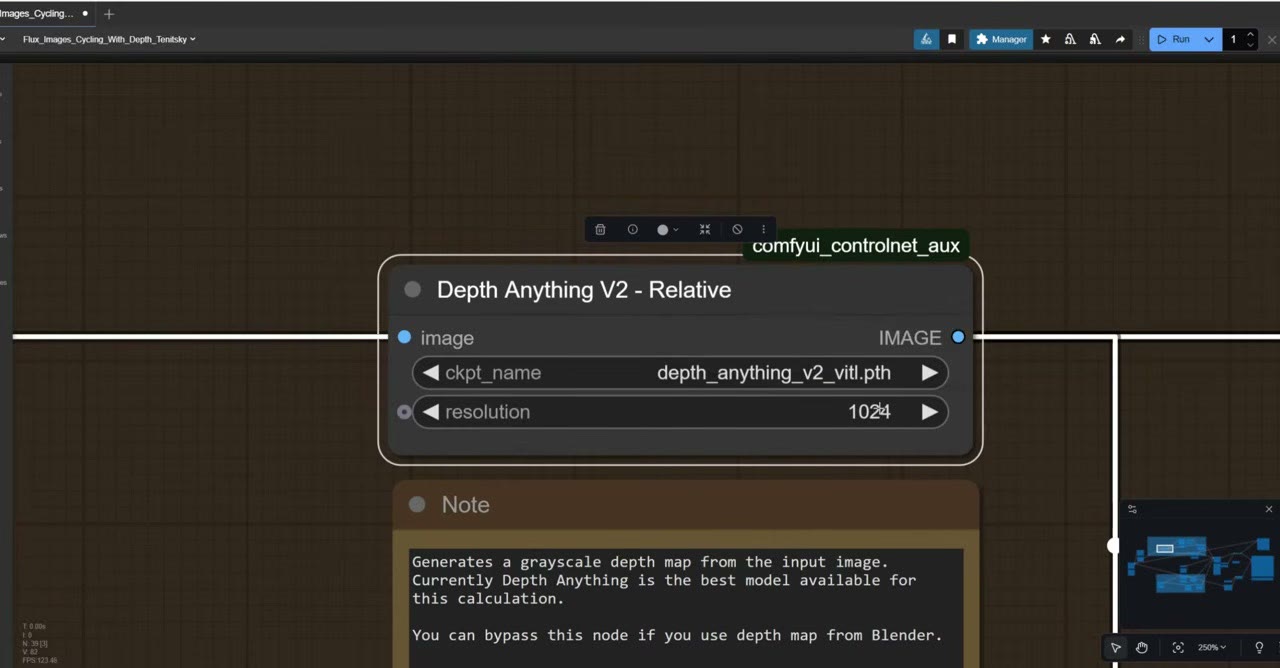
1024のままにしています。生成を速くしたいなら、768に下げてください。モデルには、Depth Anything V2の最大版を使います。最良の深度が得られるはずです。ComfyUIのModel Managerで「Depth Anything V2」を検索してダウンロードし、ブラウザのページを再読み込みしてください。ComfyUIの再起動は不要です。
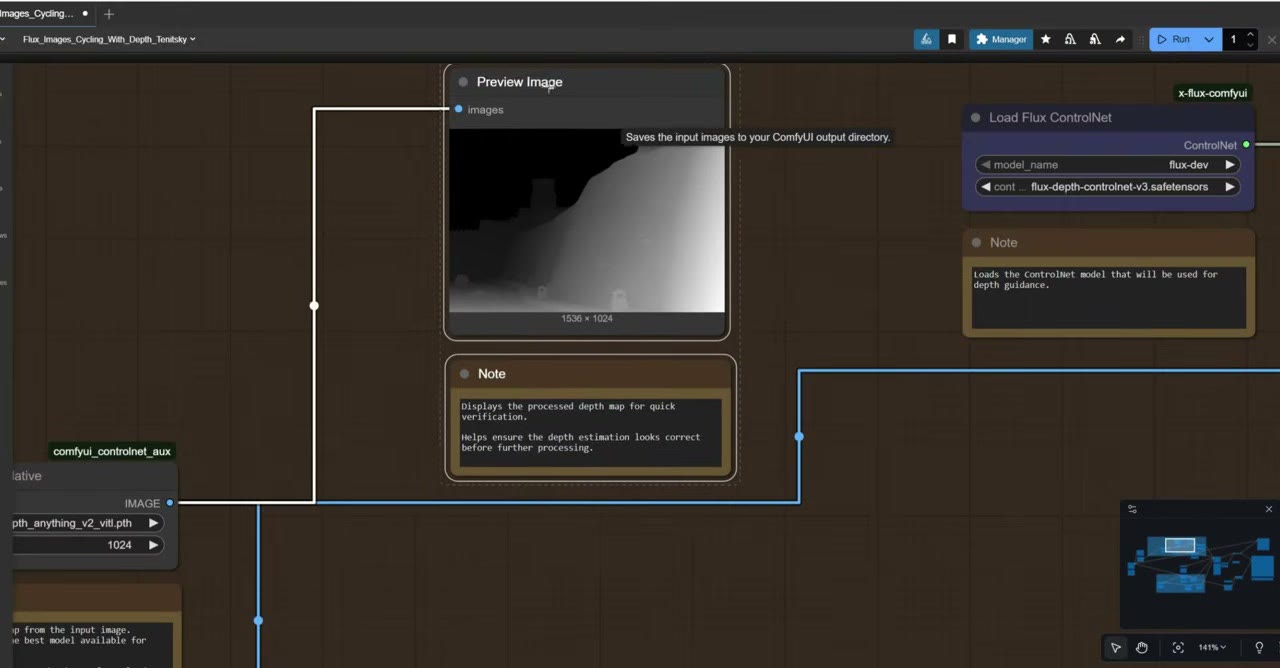
Get Image Sizeノードが新しい解像度をEmpty Latent Imageに渡すので、サイズを手入力する必要はありません。空のlatentは白紙のキャンバスで、モデルの潜在空間のノイズをサンプラーが画像に変えます。
3. Flux depth ControlNetを適用する
深度マップは、XLabsのFlux depth ControlNet v3を読み込んだ(x-flux-comfyuiの)Apply Flux ControlNetに入ります。Model Managerで「Flux depth ControlNet」を検索してダウンロードし、ページを再読み込みします。
重要な設定はstrength(強度)です。
| 強度 | 起きること |
|---|---|
| 0.5未満 | ほぼランダム:結果は写真に緩く基づくだけ |
| 約0.8 | Fluxでの私の最適値:構造が保たれ、プロンプトにも余地が残る |
| 1.0 | 強すぎる:画像が焼け始め、アーティファクトが出る |
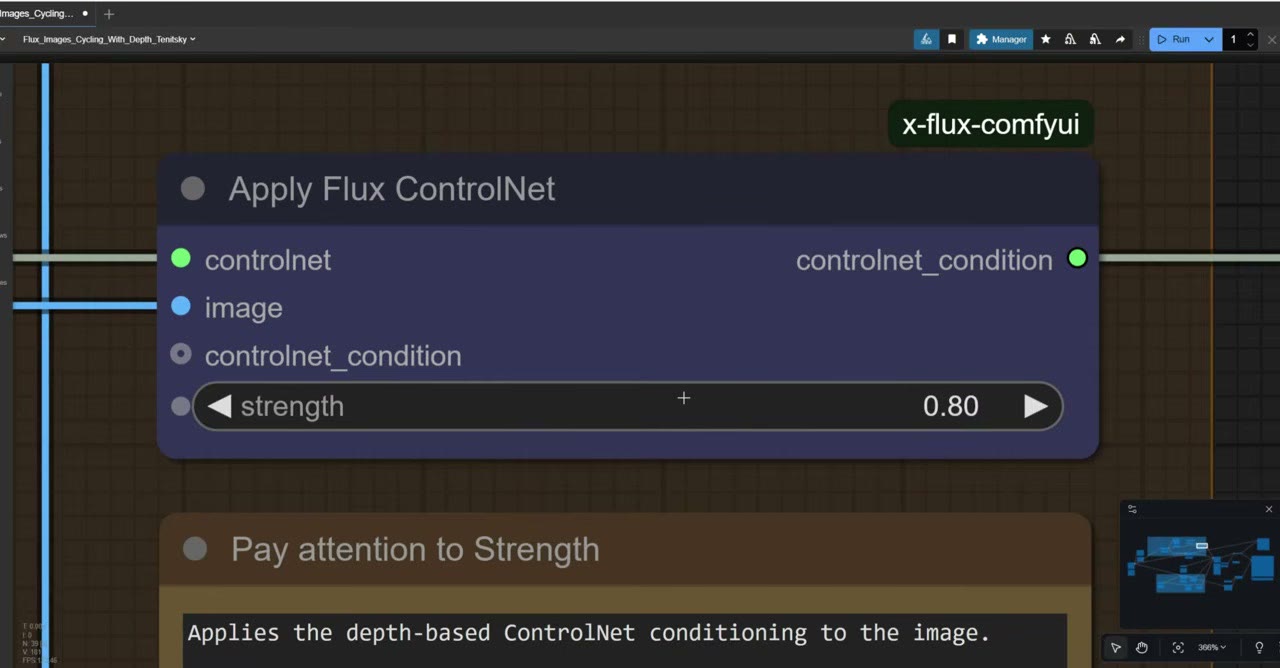
最適値はモデルによって異なります。例えばSDXLでは、約0.6まで下げます。
4. Fluxを読み込み、プロンプトを書く
Load Diffusion Modelが、weight typeをfp8にしてFlux 1 devを読み込みます。Fluxにはfp16とfp8があり、fp8のほうが速く、必要なメモリも少なくて済みます。私はVRAMが24GBありますが、ほかのプログラムがカードを使っていても止まらないように、fp8を使っています。
DualCLIPLoaderが、Fluxの2つのテキストエンコーダー、CLIP-LとT5(こちらもfp8)を読み込みます。言葉とその重みを、画像生成が向かう方向に変換します。どちらもModel Managerにあります。
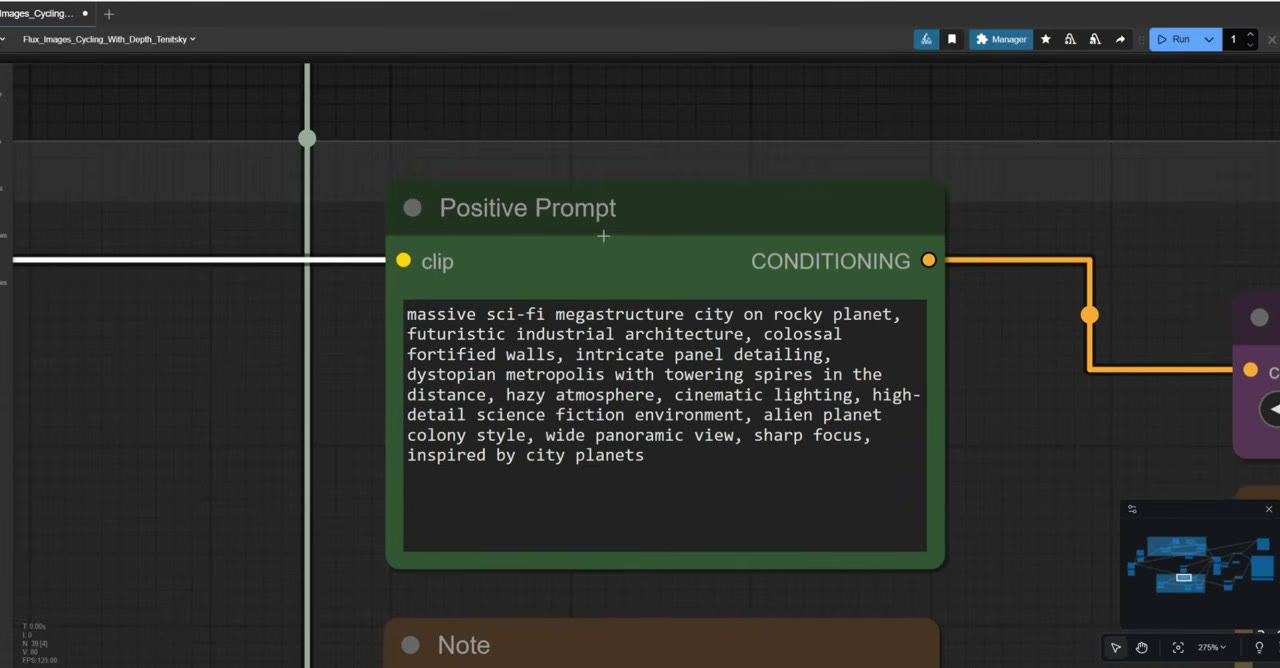
プロンプトはChatGPTに書かせ、不要な部分を編集して取り除きました。同じプロンプトがすべての写真に使われるので、何百もの結果の一貫性を保つのはこれです。
- Flux Guidance: 3。 guidanceを上げると画像が焼けます。
- ネガティブプロンプト: Fluxは使いません。ノードがあるのは、サンプラーが入力の接続を必要とするからで、結果には影響しません。
5. サンプリングとデコード
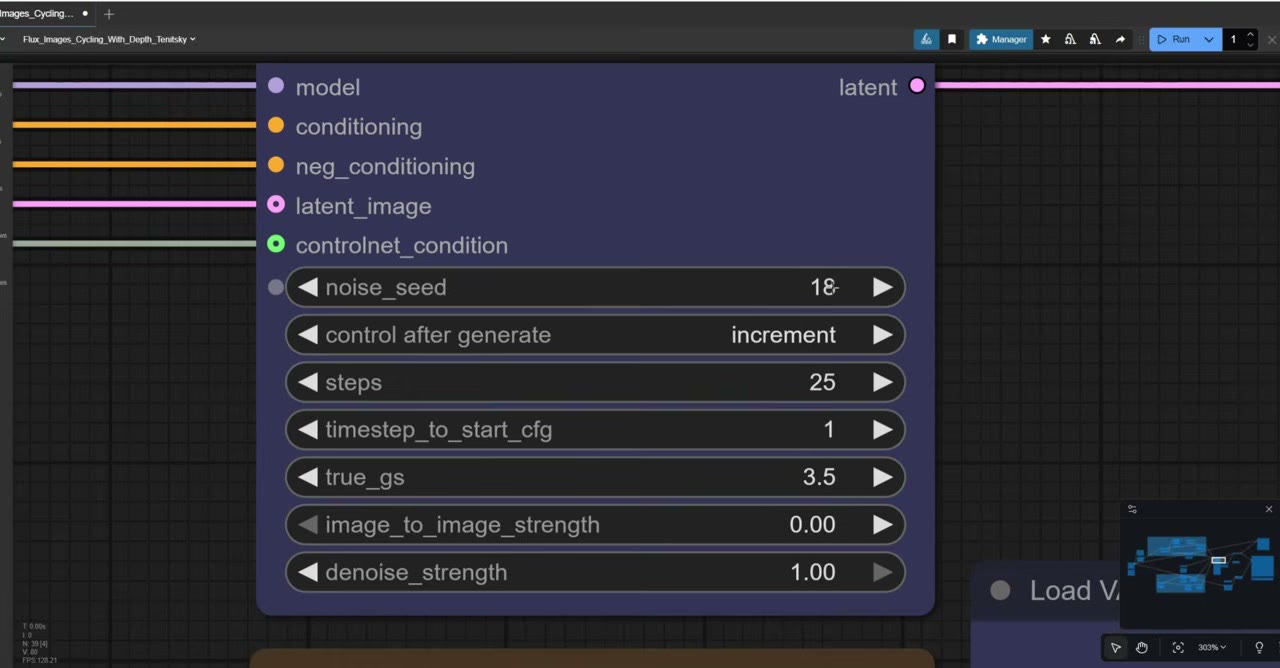
XLabs Samplerがすべて(モデル、プロンプト、latent、ControlNetの条件)を受け取って画像を作ります。ワークフロー内のノートが各パラメータを説明しています。私が設定したのは次のとおりです。
- Seedはincrement。 画像が、ランダムな巨大な数字ではなく19、20、21と番号付けされます。何枚作ったかを把握する簡単な方法です。
- 25ステップ。 50を超えると効果が薄れます。時間がかかるだけで、見た目は変わりません。
VAE Decodeが、Flux VAE(約300MB、これもModel Managerにあります)を使ってlatentの結果をピクセルに変換します。rgthreeのimage comparerを使うと、スライダーをドラッグして写真と結果を見比べられます。
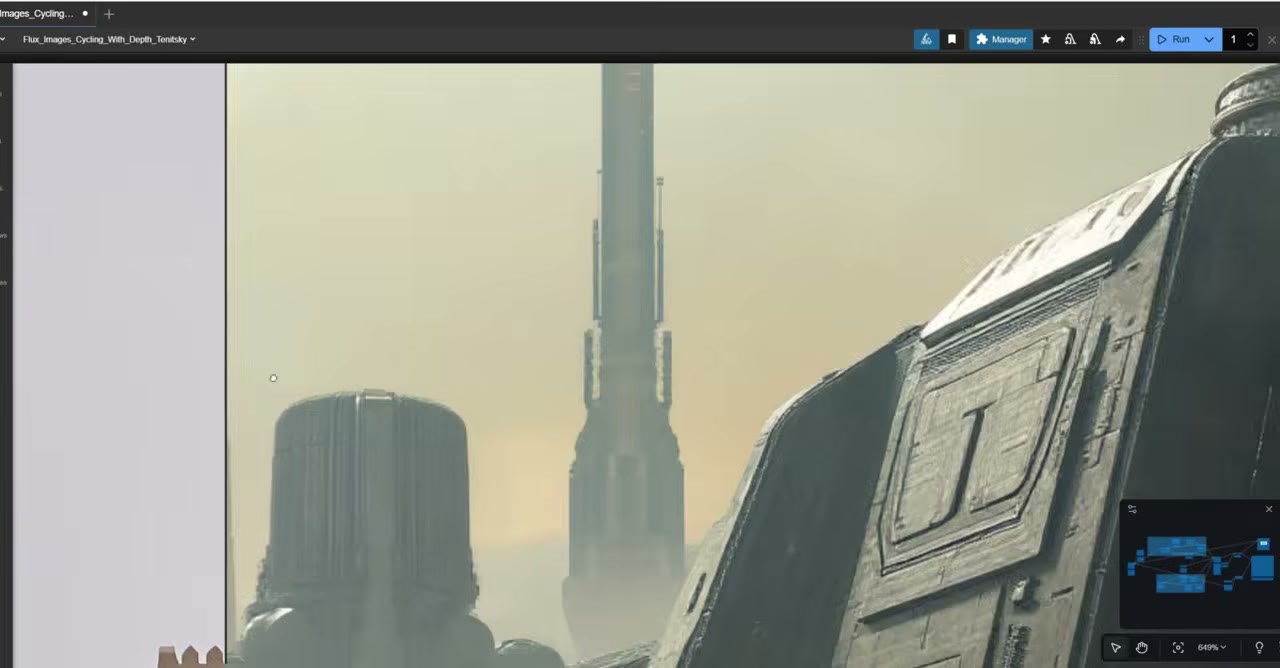
この写真の扱いは気に入っています。プロンプトだけよりも多くの情報(本物の写真の深度)をモデルに与えることで、結果は明らかに良くなります。上の塔は形を保ったままSFの塔になり、モデルがその背後にSFのスカイラインを加えました。
6. すべての結果に写真の名前を付ける
何百枚も生成すると、どの写真から作られたかを知りたくなります。ワークフローは、バッチローダーから写真のファイル名を受け取り、プレフィックス(私はflux-desert-cityを使いました)と連結して、Save Imageノードにファイル名として渡します。
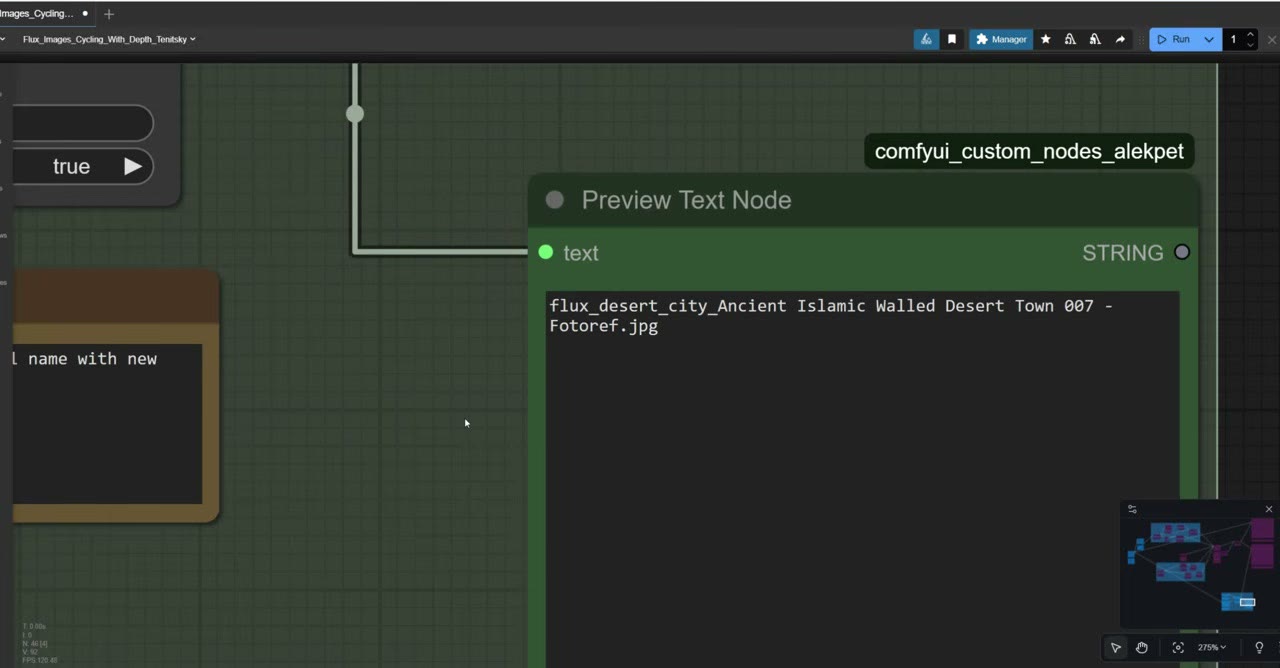
名前は少し不格好ですが、どの結果も元の写真にさかのぼれます。
どこで動かすか
VRAM 8〜24GBのカードなら、ローカルで動きます。それより小さい場合は、借りたGPUのほうが手軽です。RunPod入門でセットアップを説明していて、同じ方法がどのComfyUIワークフローにも使えます。
RunPodを試すなら、私の紹介リンクから、Googleでサインアップした新規アカウントは最初の10ドルの利用後に5〜500ドル分のクレジットを受け取れ、私には少額の紹介報酬が入ります。
動画版を見る (10:18)
上の内容はすべて動画でも説明しています。画面を見ながら進めたい方はこちらをどうぞ。 動画は英語です。
よくある質問
一括コンセプトアートで、Flux 2ではなくFlux 1を使うのはなぜですか?
速度とメモリのためです。Flux 1はVRAM 8〜24GBのカードで動きますが、Flux 2はずっと重く遅く、何百ものアイデアを生成するときには影響が大きくなります。
FluxでControlNetの強度はどのくらいにすべきですか?
Flux depth ControlNet v3では約0.8です。0.5を下回ると、結果は写真に緩く基づくだけになり、1.0では画像が焼け始めます。SDXLでは約0.6を使います。
Fluxには何ステップ必要ですか?
約25です。50ステップを超えても、時間がかかるだけで画像は良くなりません。

Anton Tenitsky は コンピュータグラフィックスで15年以上の経験を持つ3Dアーティストで、Nickelodeon、Gameloft、Marvel Rivalsをはじめ多くのクライアントと仕事をしてきました。 プロフィールを見る