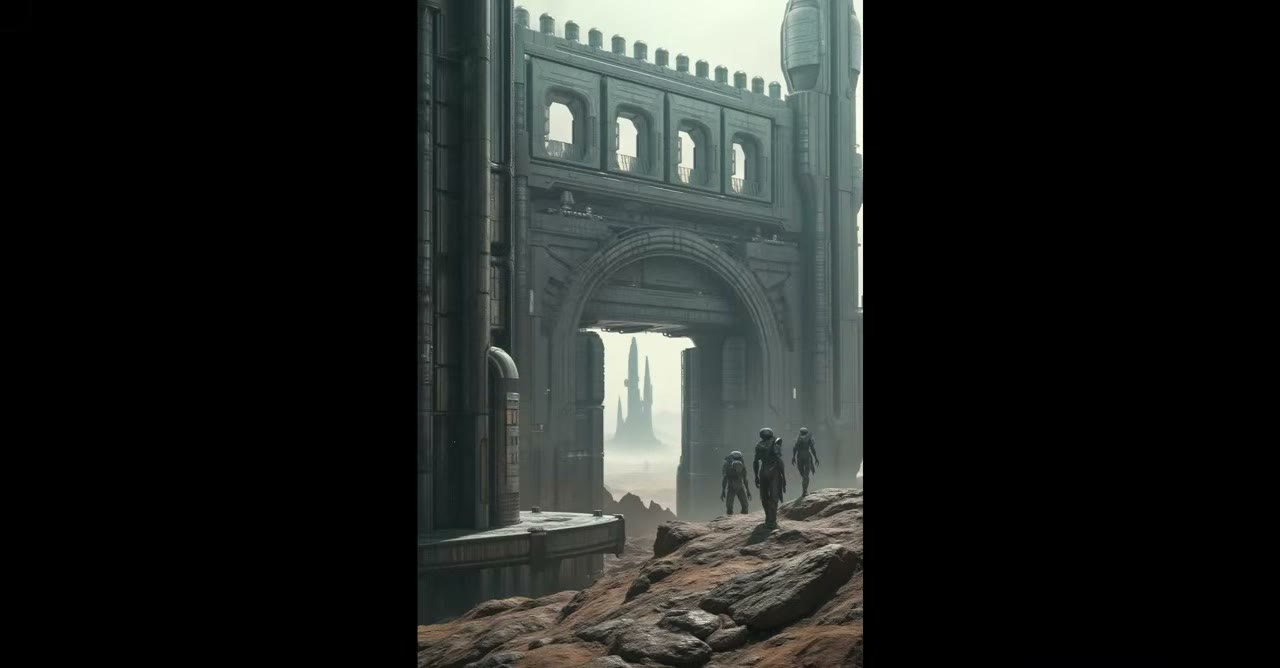
Dê a este fluxo uma pasta de fotos e ele transforma cada uma em uma peça de concept art, mantendo a estrutura e a composição da foto e restilizando todo o resto. Rodei em um pacote de cerca de 700 fotos de uma antiga cidade murada do deserto, que viraram torres, portões e muralhas de ficção científica.
Roda localmente no ComfyUI com o Flux 1 dev. Não uso o Flux 2 de propósito: ele é muito mais pesado e lento, e quando você gera ideias em volume, a velocidade é o que importa. O Flux 1 roda em placas com de 8 a 24 GB de VRAM.
Em resumo
- Entrada: uma pasta de fotos, lidas uma a uma.
- Estrutura: um mapa de profundidade do Depth Anything V2 conduz o ControlNet de profundidade do Flux.
- Ajustes: força do ControlNet cerca de 0,8, Flux guidance 3, 25 steps.
- Saída: cada resultado leva o nome da foto da qual veio.
- O fluxo pronto está no meu Patreon, mas nada nele é segredo: tudo é explicado abaixo.
Custom nodes de que você vai precisar
Todos se instalam pelo ComfyUI Manager:
- ComfyUI Essentials e KJNodes, para utilitários de imagem e redimensionamento.
- comfyui_controlnet_aux, que fornece o nó Depth Anything V2.
- x-flux-comfyui, da XLabs, para o ControlNet e o sampler do Flux.
- rgthree, para a comparação antes/depois.
1. Carregue as fotos como um lote
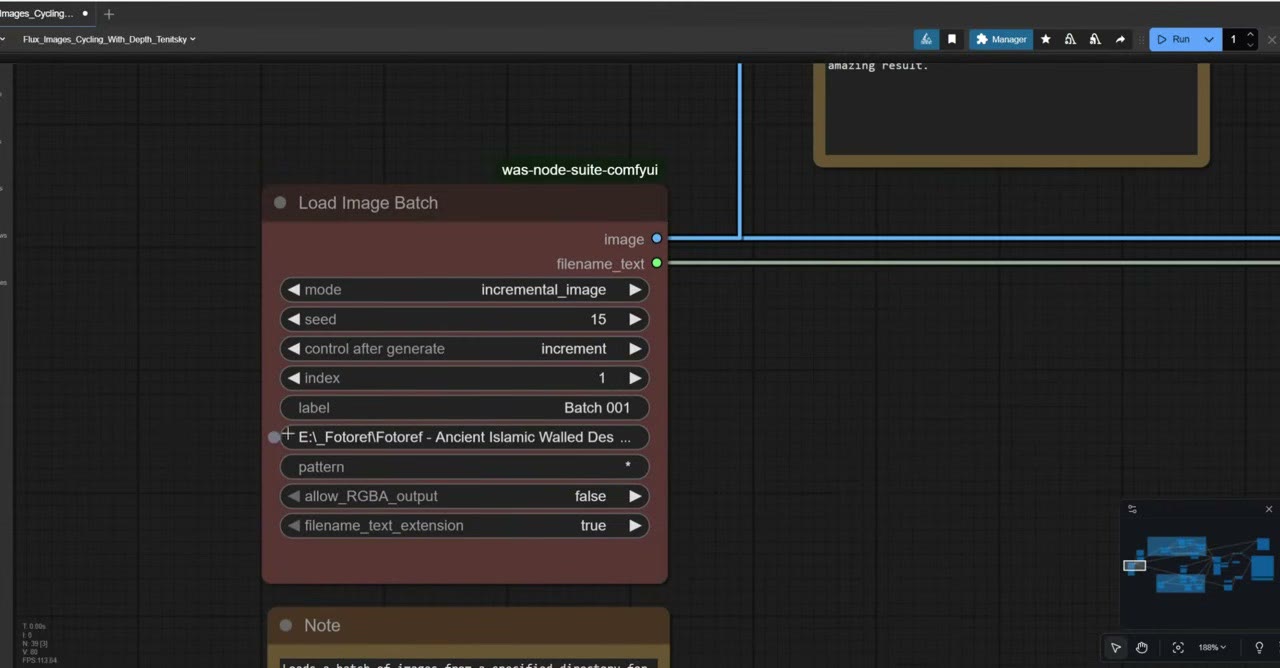
Um nó Load Image Batch aponta para uma pasta e a percorre, uma imagem por execução. Um nó de pré-visualização ao lado serve só para diagnóstico, para confirmar que a imagem certa está entrando.
Minhas fotos eram grandes: a do vídeo tinha 3867 × 2578 pixels, muito mais do que o Flux precisa. O próximo nó as reduz.
2. Gere um mapa de profundidade e redimensione
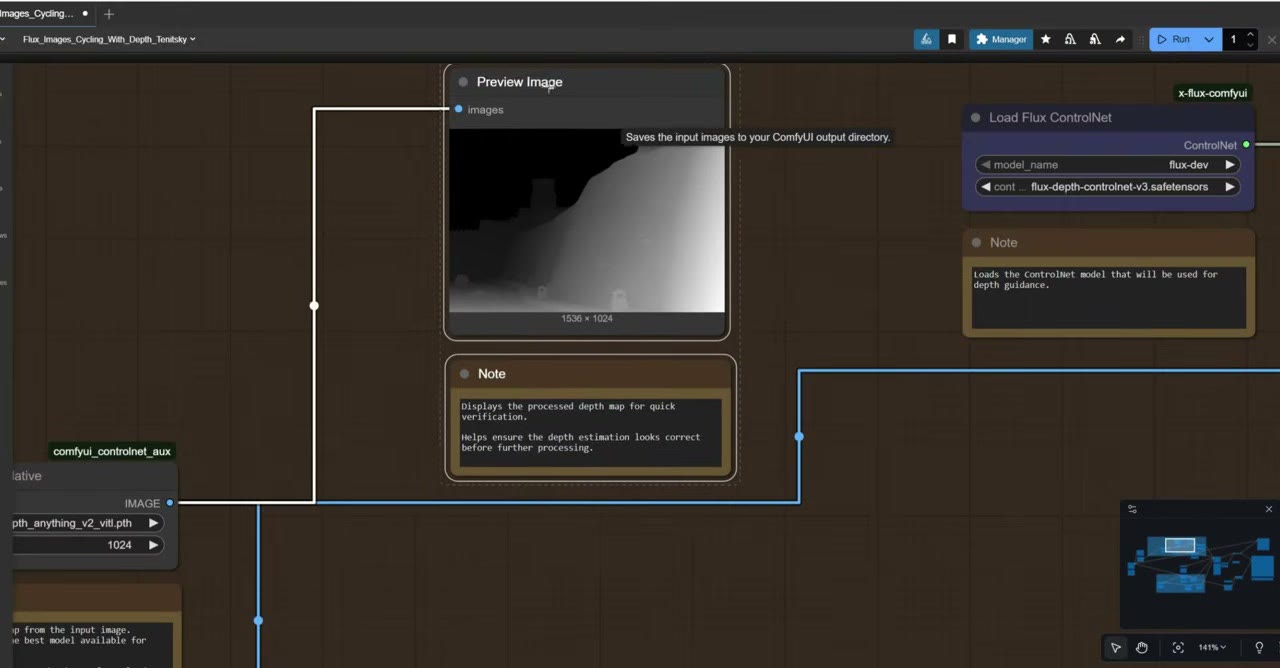
O nó Depth Anything V2 faz duas coisas. Transforma cada foto em um mapa de profundidade em tons de cinza (perto é claro, longe é escuro), e seu ajuste resolution escala a foto de modo que o seu lado curto tenha essa quantidade de pixels, com o lado longo escalado na proporção. Retrato ou paisagem, tudo sai nas proporções certas.
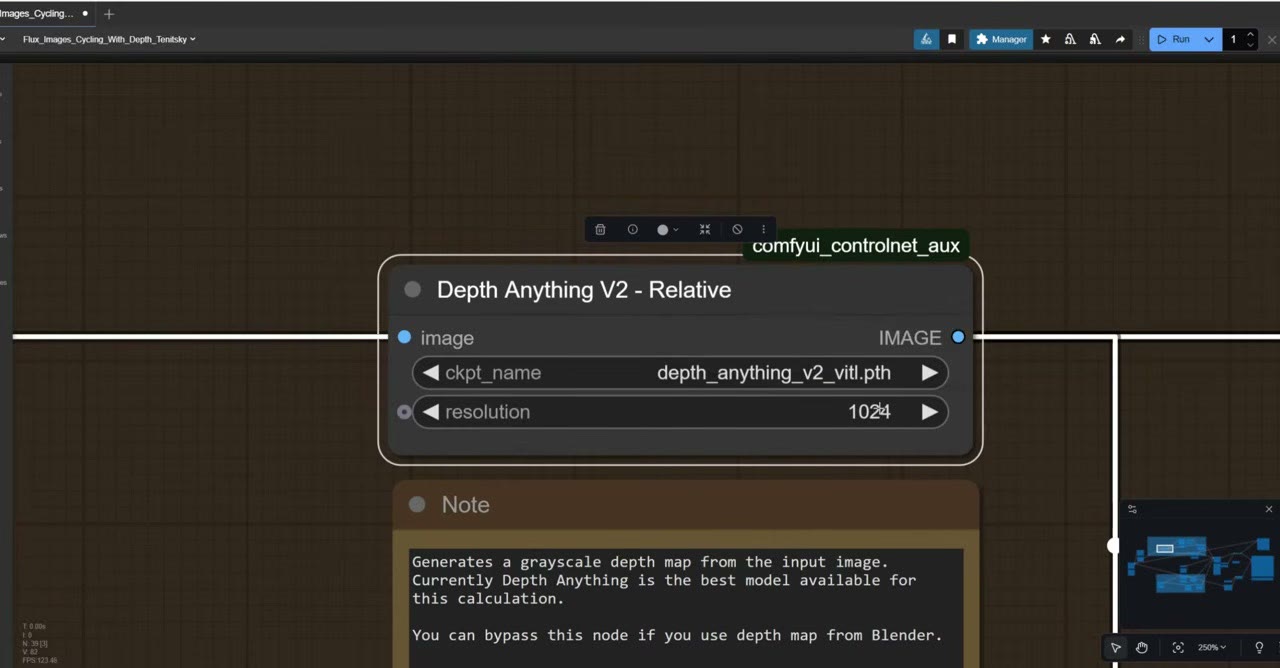
Mantenho em 1024. Baixe para 768 se quiser gerações mais rápidas. Quanto ao modelo, uso a maior versão do Depth Anything V2, que deve dar a melhor profundidade. Baixe-a pelo Model Manager do ComfyUI buscando «Depth Anything V2» e recarregue a página do navegador; não precisa reiniciar o ComfyUI.
Um nó Get Image Size passa a nova resolução ao Empty Latent Image, então você nunca digita tamanhos à mão. O latente vazio é a tela em branco: ruído no espaço latente do modelo que o sampler transforma na imagem.
3. Aplique o ControlNet de profundidade do Flux
O mapa de profundidade entra no Apply Flux ControlNet (do x-flux-comfyui), com o Flux depth ControlNet v3 da XLabs carregado. Encontre-o no Model Manager buscando «Flux depth ControlNet», baixe e recarregue a página.
O ajuste que importa é a strength:
| Strength | O que acontece |
|---|---|
| Abaixo de 0,5 | Quase aleatório: o resultado se baseia só vagamente na foto |
| Cerca de 0,8 | Meu ponto ideal com o Flux: a estrutura se mantém e o prompt ainda tem espaço |
| 1,0 | Demais: a imagem começa a queimar e surgem artefatos |
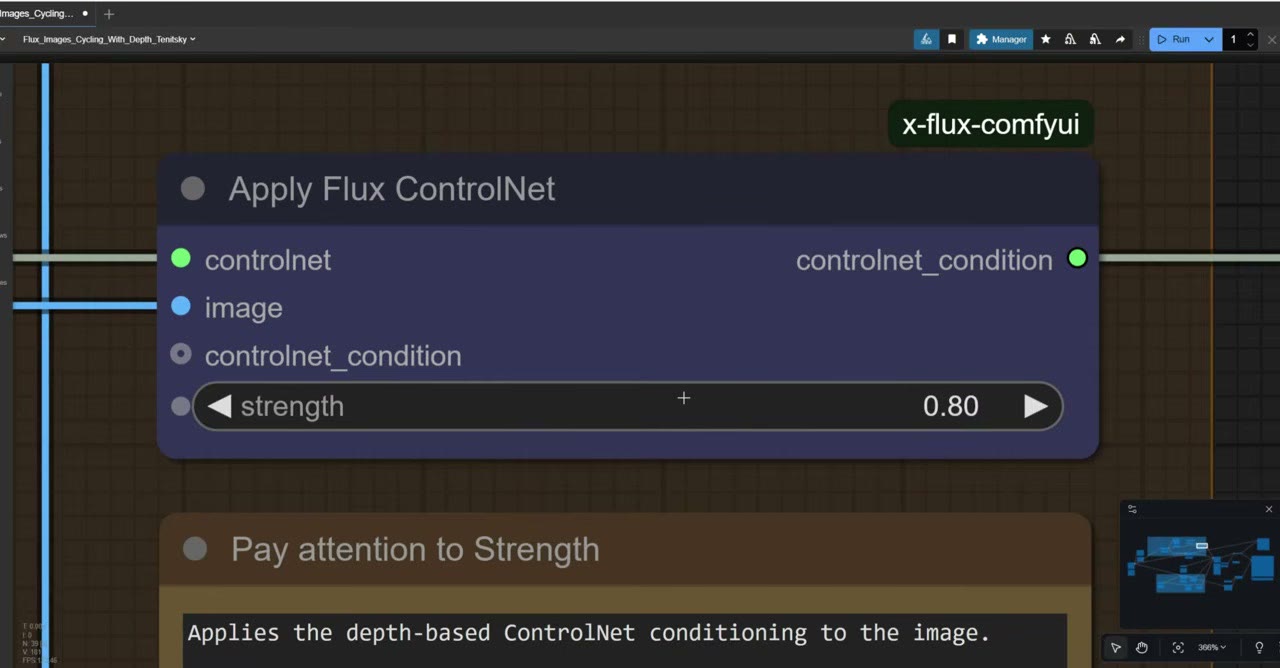
O ponto ideal depende do modelo. Com o SDXL, por exemplo, desço para cerca de 0,6.
4. Carregue o Flux e escreva o prompt
O Load Diffusion Model carrega o Flux 1 dev com o tipo de peso fp8. O Flux vem em fp16 e fp8; o fp8 é mais rápido e usa menos memória. Tenho 24 GB de VRAM e mesmo assim uso fp8, para não travar se outros programas estiverem usando a placa.
O DualCLIPLoader carrega os dois codificadores de texto do Flux, CLIP-L e T5 (também em fp8). Eles traduzem as palavras e seus pesos na direção que a geração da imagem toma. Ambos estão no Model Manager.
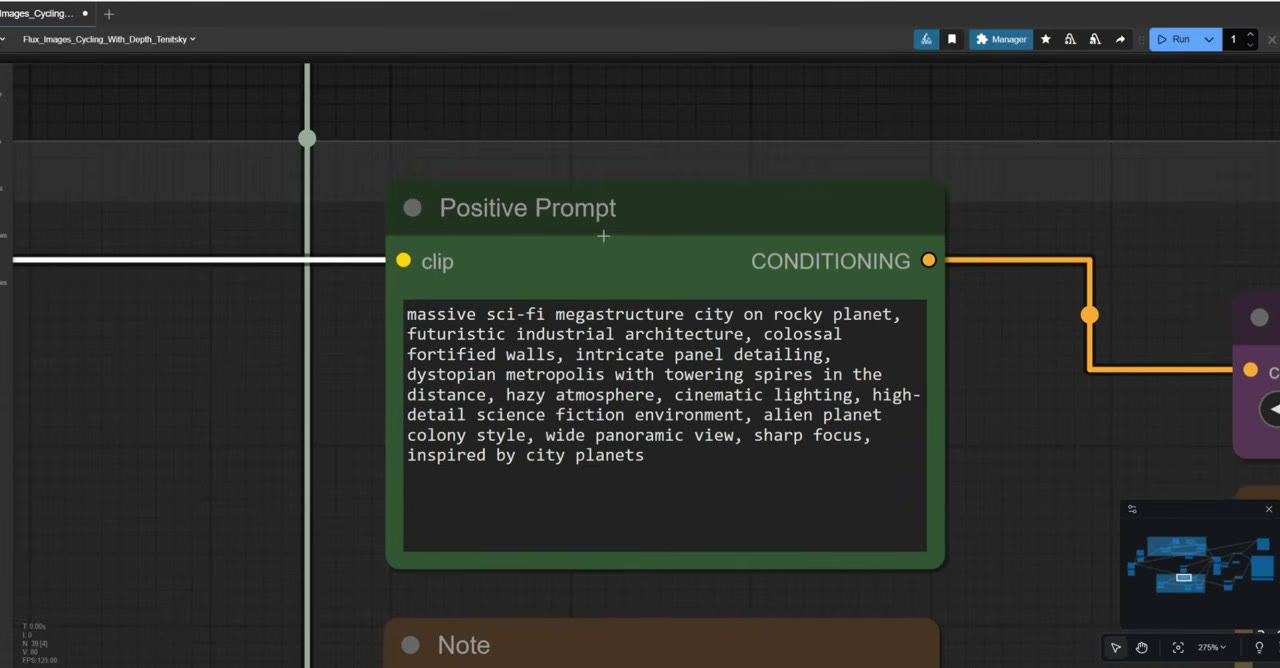
Pedi ao ChatGPT que escrevesse o prompt e depois tirei as partes que não queria. Como o mesmo prompt roda em todas as fotos, é ele que mantém centenas de resultados consistentes.
- Flux Guidance: 3. Um guidance maior queima a imagem.
- Prompt negativo: o Flux não usa um. O nó está lá só porque o sampler precisa da entrada conectada; ele não afeta o resultado.
5. Amostragem e decodificação
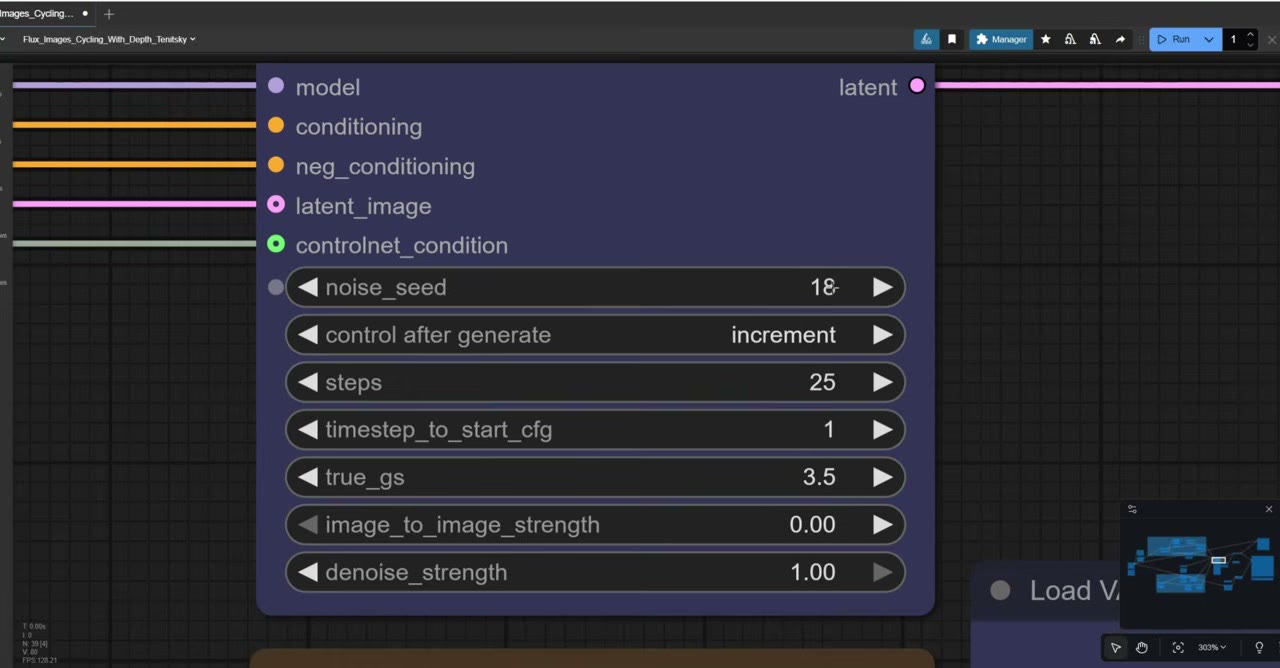
O XLabs Sampler recebe tudo (modelo, prompt, latente e condição do ControlNet) e faz a imagem. As notas dele no fluxo explicam cada parâmetro; os que defini:
- Seed em increment, para as imagens serem numeradas 19, 20, 21 em vez de números enormes aleatórios. É um jeito fácil de acompanhar quantas você já fez.
- 25 steps. Depois de 50 há retornos decrescentes: mais tempo, nenhuma mudança visível.
O VAE Decode converte o resultado latente em pixels, usando o VAE do Flux (cerca de 300 MB, também no Model Manager). Um rgthree image comparer permite arrastar um controle deslizante entre a foto e o resultado.
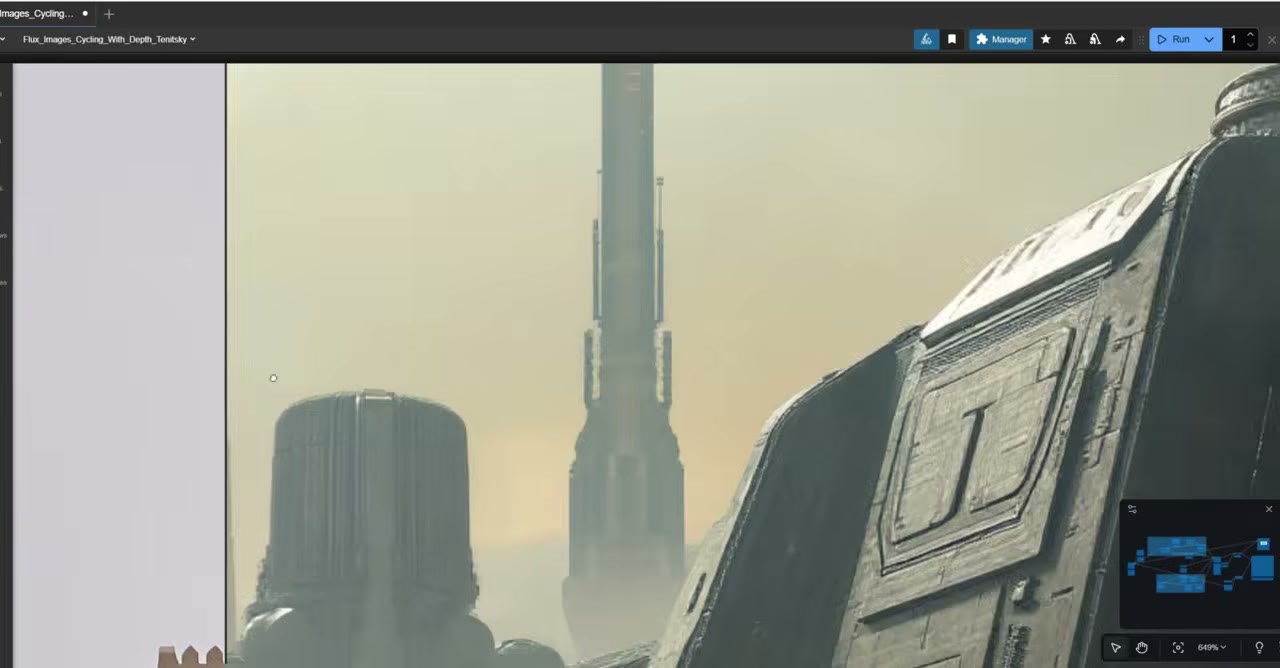
Gosto do que isso faz com as fotos. Dar ao modelo mais informação do que um prompt sozinho (a profundidade de uma foto real) claramente ajuda o resultado: a torre acima manteve sua forma, virou uma torre de ficção científica, e o modelo acrescentou um horizonte futurista atrás dela.
6. Dê a cada resultado o nome da sua foto
Quando você gera centenas de imagens, quer saber de qual foto cada uma veio. O fluxo pega o nome do arquivo da foto no carregador em lote e o concatena com um prefixo (usei flux-desert-city), e depois o passa ao nó Save Image como nome do arquivo.
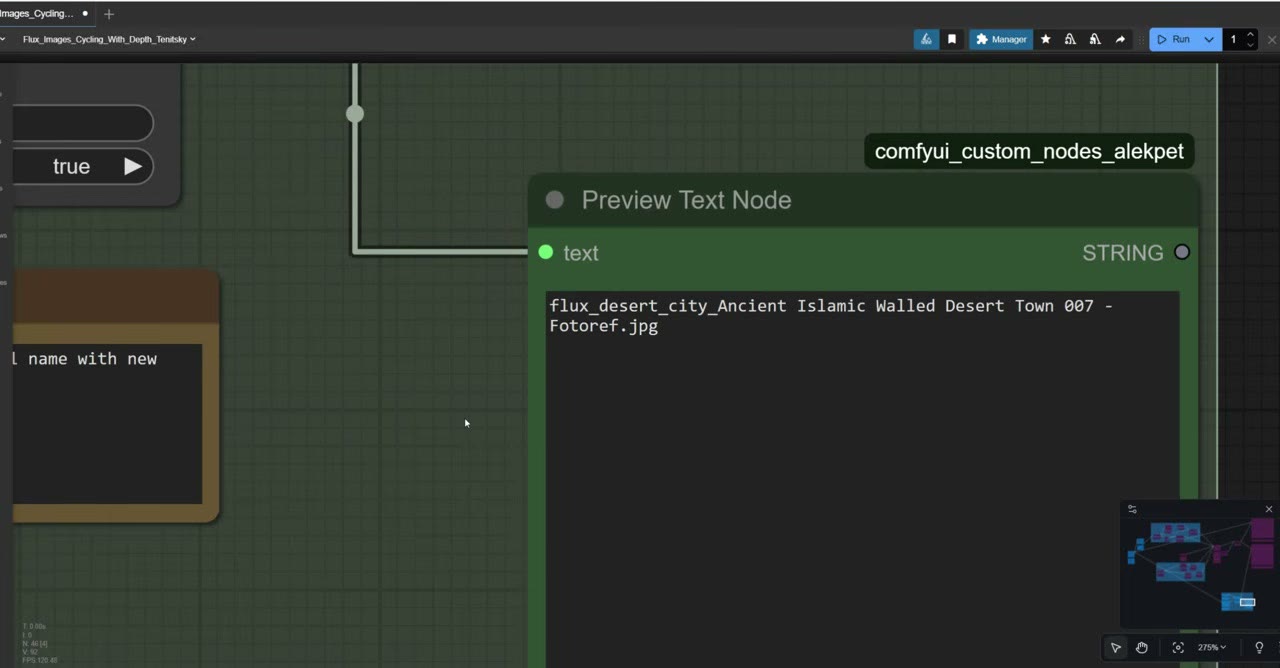
Os nomes ficam um pouco desajeitados, mas todo resultado pode ser rastreado até a foto de origem.
Onde rodar
Roda localmente em placas com 8 a 24 GB de VRAM. Se a sua for menor, uma GPU alugada é o caminho mais fácil. Minha introdução ao RunPod mostra a configuração, e a mesma abordagem serve para qualquer fluxo do ComfyUI.
Se você experimentar o RunPod, meu link de indicação dá a novas contas que se cadastram com o Google de US$ 5 a US$ 500 em crédito após seus primeiros US$ 10, e eu recebo uma pequena comissão.
Assista à versão em vídeo (10:18)
Tudo o que está acima também está no vídeo, se você preferir acompanhar na tela. O vídeo está em inglês.
Perguntas frequentes
Por que usar o Flux 1 em vez do Flux 2 para concept art em lote?
Velocidade e memória. O Flux 1 roda em placas com 8 a 24 GB de VRAM; o Flux 2 é mais pesado e bem mais lento, o que pesa quando você gera centenas de ideias.
Que força de ControlNet devo usar com o Flux?
Cerca de 0,8 para o Flux depth ControlNet v3. Abaixo de 0,5 o resultado se baseia só vagamente na foto; em 1,0 a imagem começa a queimar. Com o SDXL uso cerca de 0,6.
Quantos steps o Flux precisa?
Cerca de 25. Depois de 50 steps você paga em tempo sem ver uma imagem melhor.

Anton Tenitsky é artista 3D com mais de 15 anos em computação gráfica, que trabalhou com Nickelodeon, Gameloft, Marvel Rivals e muitos outros clientes. Mais sobre mim