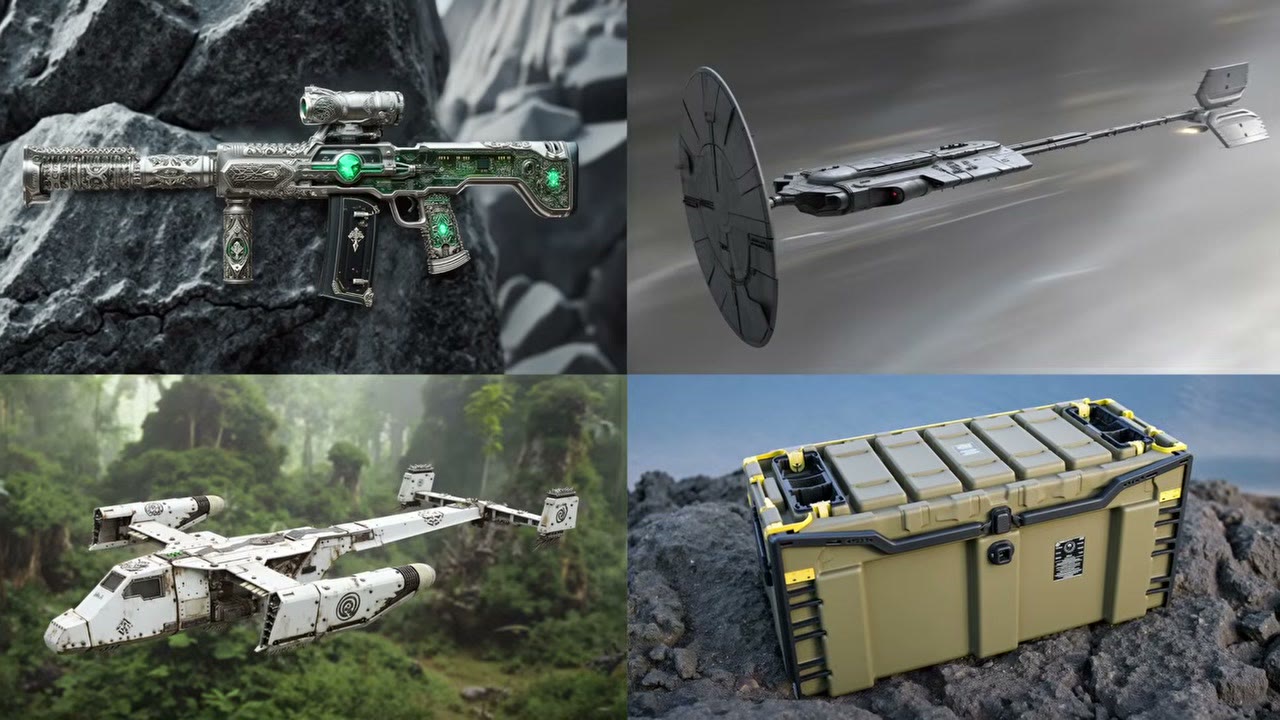
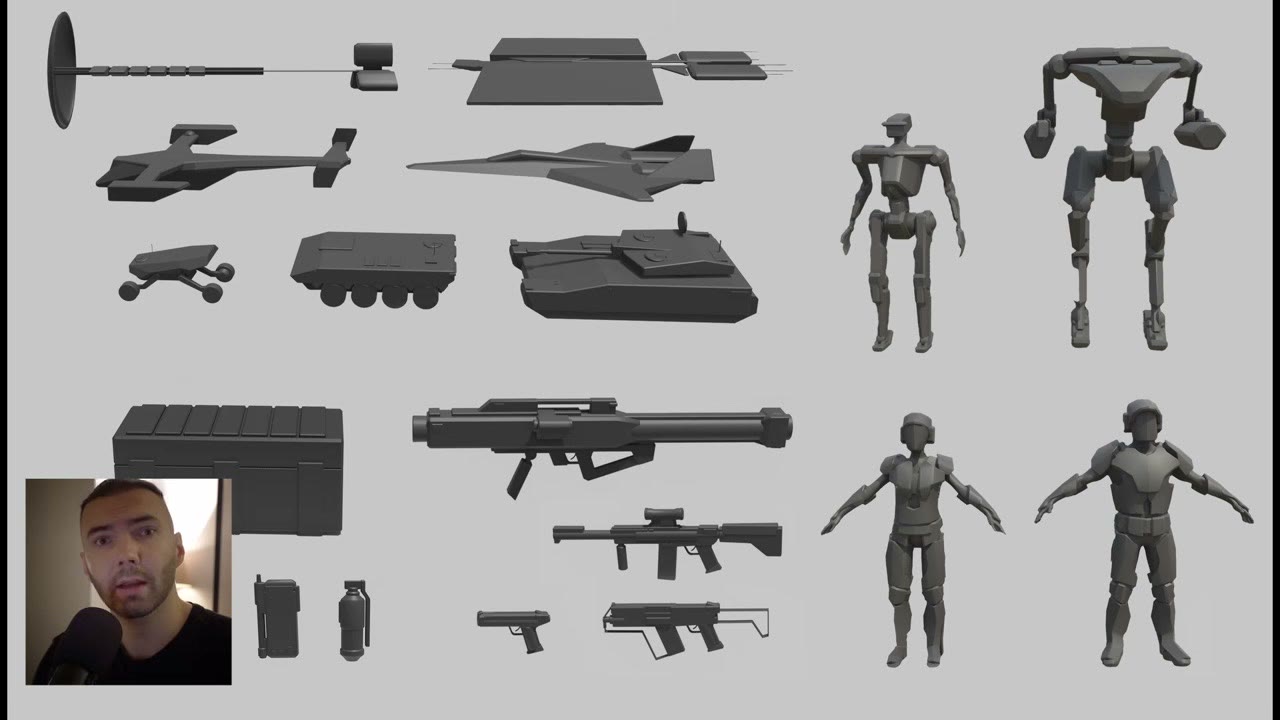
Este é o pipeline que uso para transformar blockouts 3D simples do Blender em concept art: dezenas de adereços e personagens, cada um com sua descrição, em muitos estilos, durante a noite. É também a etapa do meio de um pipeline maior, do blockout à concept art ao modelo 3D.
São muitos nós, então montei por etapas, de um fluxo de profundidade simples à versão totalmente automatizada. Cada etapa é útil por si só, e é a melhor forma de entender o conjunto.
Em resumo
- GPU: 12 GB de VRAM no mínimo para o Flux, ou use uma versão GGUF ou uma GPU na nuvem.
- Profundidade: o Depth Anything gera o mapa de profundidade; Flux depth ControlNet em cerca de 0,7.
- Flux: guidance 3–3,5, 25 steps, prompt negativo vazio.
- Automação: listas de prompts (Inspire Pack), empilhamento de prompts e loop counters que associam cada captura ao seu prompt.
- Ordenação: uma checagem de proporção alterna a tela entre paisagem e retrato automaticamente.
Você pode testar o fluxo pronto sem instalar nada no RunComfy, já configurado, com cerca de 15 minutos grátis: o suficiente para uma ou duas imagens. Todos os fluxos, listas de prompts e modelos 3D estão no meu Patreon, mas nada está escondido: tudo é explicado abaixo.
Etapa 1: da imagem à profundidade e à imagem
O fluxo mais simples. Carregue uma captura, redimensione-a se não bater com o tamanho desejado e passe-a pelo Depth Anything. Defini a resolução dele em 1088, que se aplica ao lado curto da imagem, então uma captura em retrato não precisa de mudança ali.
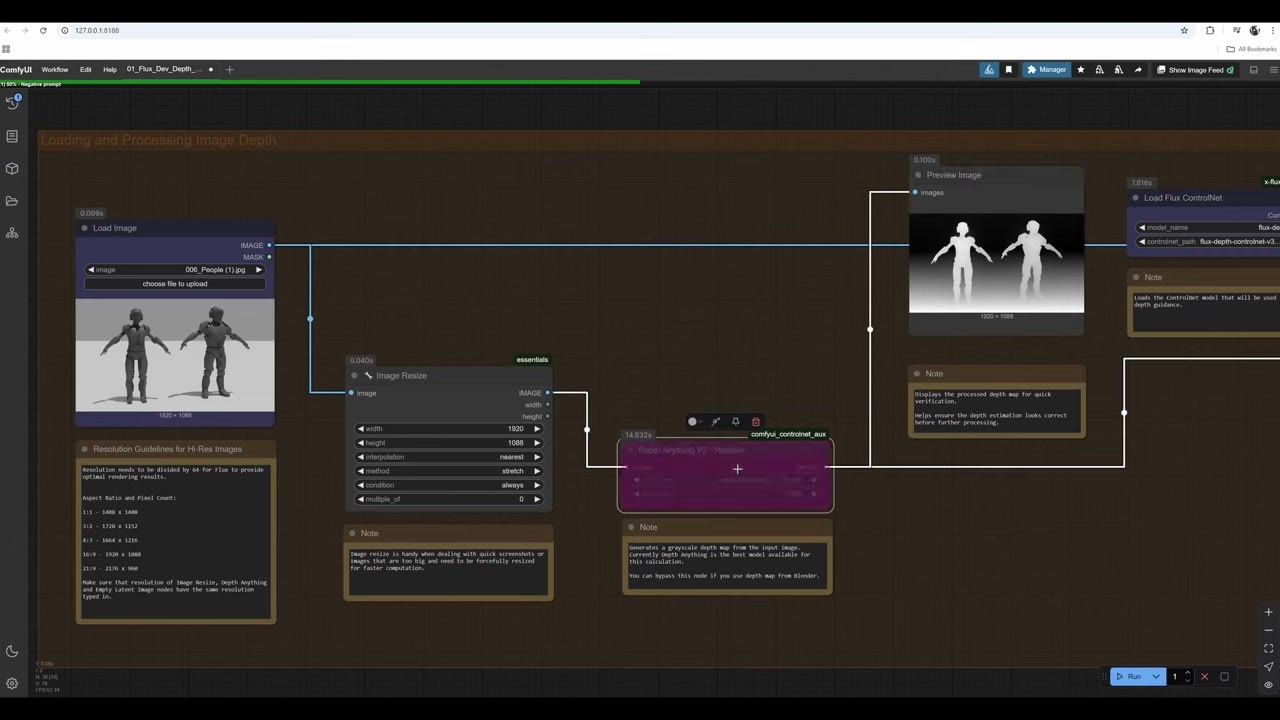
Você pode renderizar um mapa de profundidade no Blender e ignorar o nó Depth Anything (Ctrl+B). Eu não me dou ao trabalho: o Depth Anything é bom o bastante, a precisão não é crítica aqui e economiza tempo.
ControlNet. O mapa de profundidade vai para o Apply Flux ControlNet com um Flux depth ControlNet carregado. A força é o ajuste-chave. Mantenho em 0,7; qualquer valor de 0,6 a 0,8 funciona. Mais baixo deixa o resultado borrado e solto demais; em 1,0 a imagem tem glitches. Com o SDXL desço para cerca de 0,5.
Sampler. Vai para o XLabs Sampler, não para o KSampler padrão, que não tem entrada para o condicionamento do ControlNet.
Modelo. Uso o modelo Flux dev completo. Com pouca VRAM, use uma versão GGUF: a mesma configuração com um Unet Loader (GGUF) e um modelo Flux GGUF Q4. A qualidade não sofre muito, e roda mais rápido.
Prompt. O DualCLIPLoader com os dois codificadores de texto do Flux, depois o prompt. Flux Guidance em 3 a 3,5: mais alto empurra o prompt com mais força e começa a queimar a imagem. O Flux não subtrai um prompt negativo como o SDXL, então costumo deixá-lo vazio.
Ajustes do sampler. Seed em increment (as imagens recebem os números 2265, 2266 e assim por diante, o que facilita acompanhar o que rodou durante a noite), 25 steps. Mais steps tem retornos decrescentes, e passando de 50 você só perde tempo.
Escreva prompts melhores com um chatbot
Meu primeiro prompt de teste era só «sci-fi soldier», e o resultado ficou feio. Duas correções rápidas o melhoraram muito:
- Coloque «cartoony, stylized illustration» no prompt negativo. Tem um efeito pequeno no Flux.
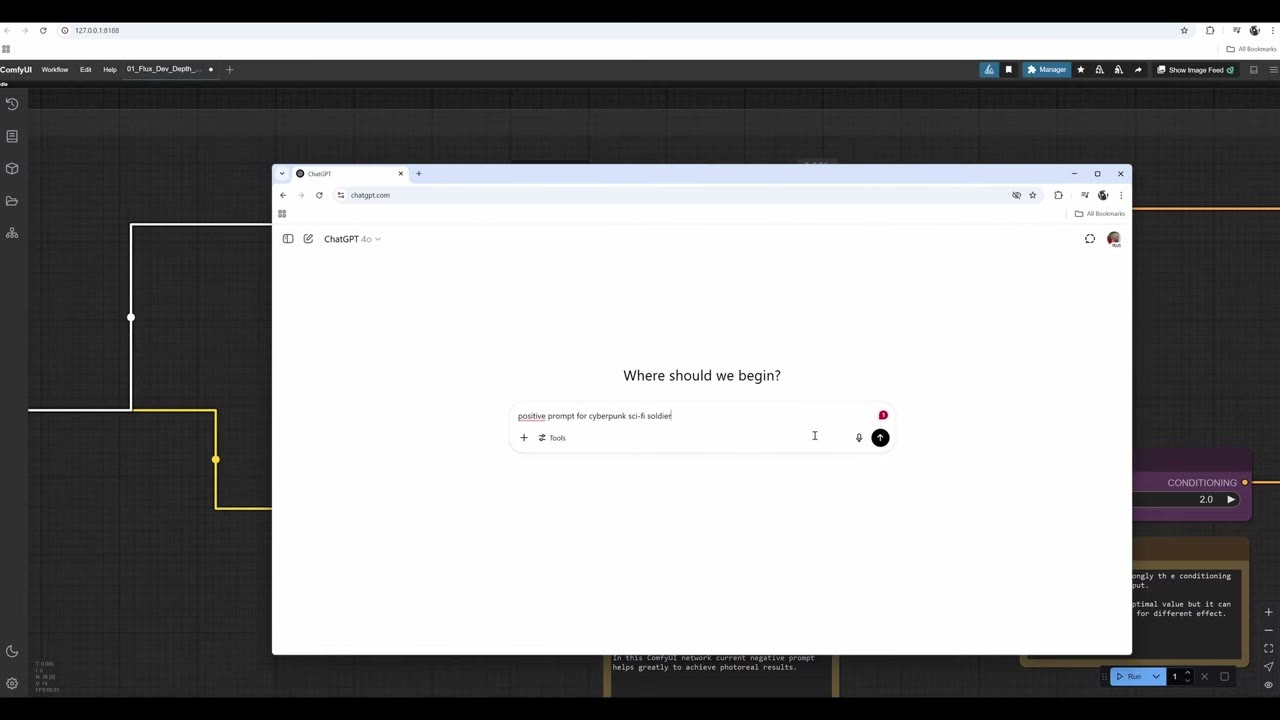
- Peça ao ChatGPT (ou a qualquer chatbot) que expanda o prompt. Pedi um prompt positivo para um soldado cyberpunk de ficção científica e colei. Leia antes e corte o que for estranho.
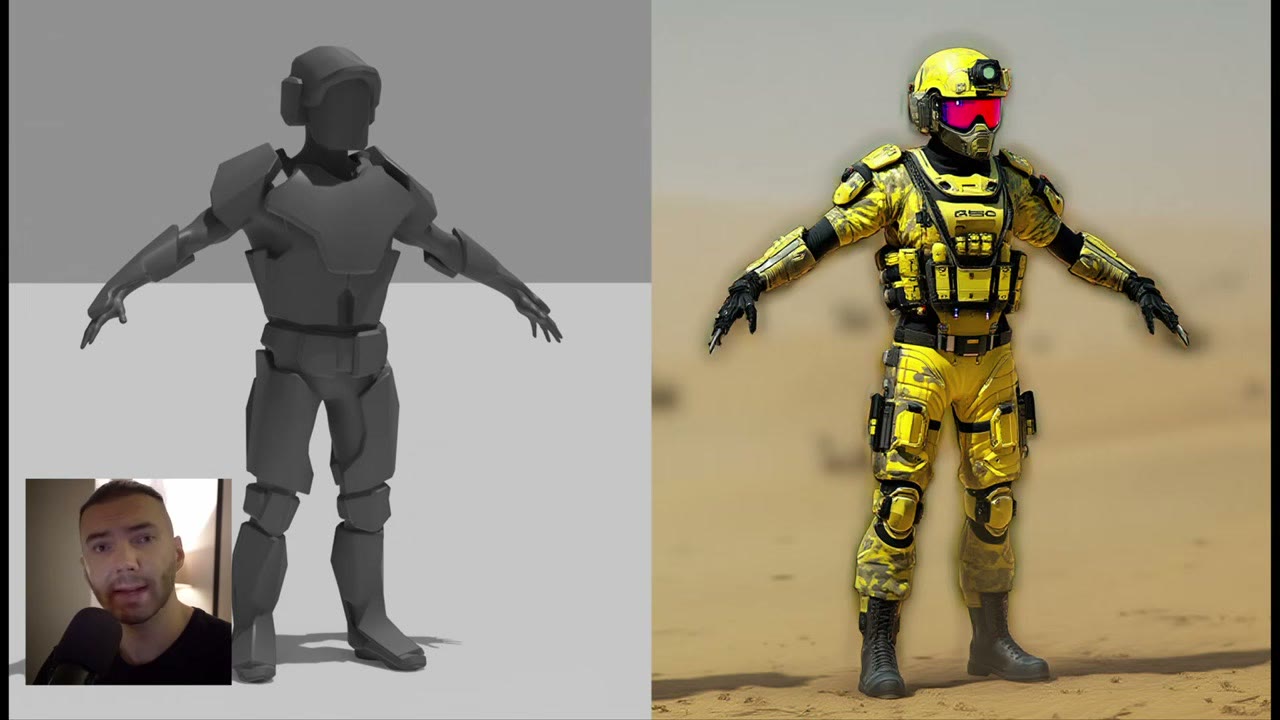
Uma observação sobre aquele texto de «copyright» que o Flux às vezes acrescenta num canto: não é o copyright de ninguém de verdade. O Flux imita imagens que muitas vezes tinham texto ali.
Imagens quadradas dão os melhores resultados. Eu queria paisagem e retrato neste pipeline porque muitos adereços são longos ou altos. Imagens muito largas às vezes dão ao adereço um contorno fino ou moldura. Você verá nos meus resultados; as imagens quadradas têm bem menos disso.
Etapa 2: listas de prompts
A mesma configuração de profundidade, mais um nó Load Single Prompt From File do Inspire Pack, que lê prompts de um arquivo de texto.
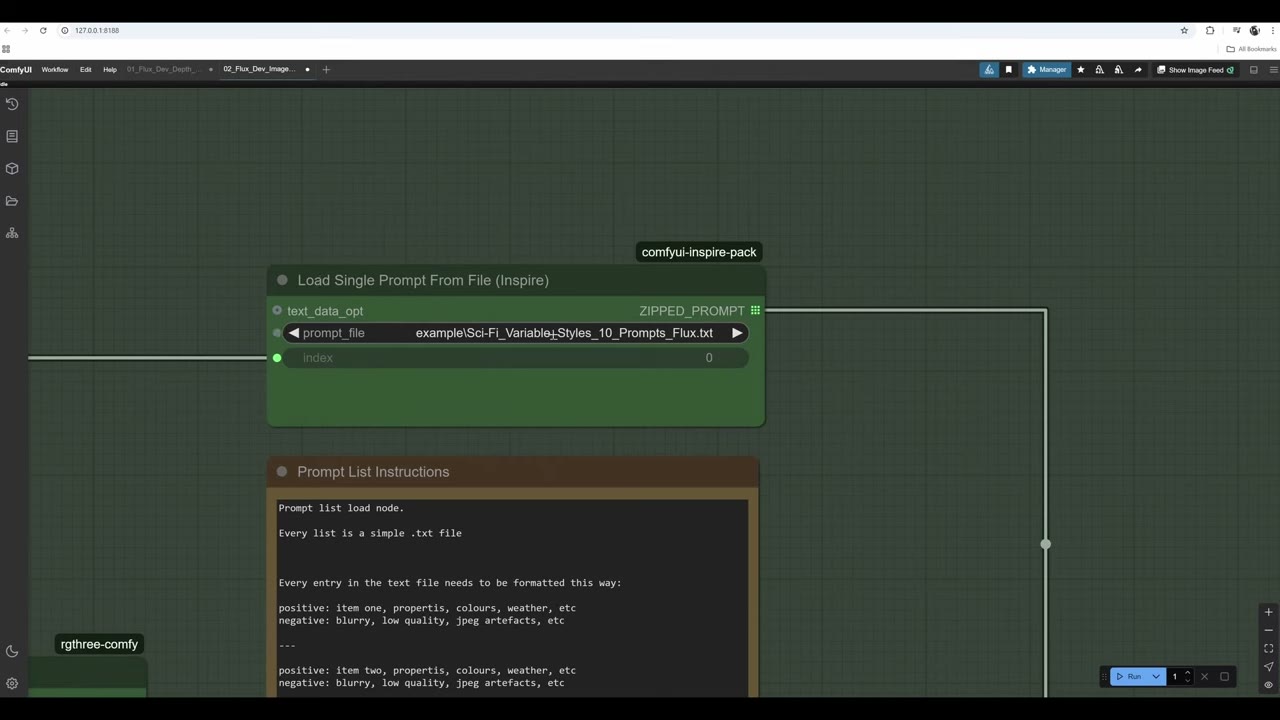
O formato é rígido:
positive: item one, properties, colours, weather, etc
negative: blurry, low quality, jpeg artefacts, etc
---
positive: item two, properties, colours, weather, etc
negative: blurry, low quality, jpeg artefacts, etc- Mantenha
positive:enegative:em minúsculas. Uma letra maiúscula no lugar errado faz o nó não ler nada. Mantenho tudo em minúsculas por segurança. - O arquivo precisa estar em
ComfyUI/custom_nodes/comfyui-inspire-pack/prompts/(uso a subpastaexample). Não dá para apontar para outro lugar. - Conte suas entradas, porque o nó não vai dizer. Peça ao ChatGPT exatamente 10 entradas neste formato e ele dará uma lista assim.
- Depois de editar uma lista, recarregue o ComfyUI (Ctrl+R). Se ainda usar o texto antigo, mude para outra lista, execute uma vez e volte.
Minha primeira lista se chamava variable-styles-10-prompts: só estilos, sem descrever objeto nenhum, então a mesma lista serve para qualquer adereço.
Ligação. O prompt passa por um nó Unzip Prompt (precisa ser desempacotado). Esse nó também precisa de alguma imagem conectada para funcionar, mesmo sem usá-la. Os campos de texto positivo e negativo dele não acrescentam nada, então deixe-os em paz.
Fazendo-a percorrer. Sozinha, a lista só roda o primeiro prompt. Um loop counter do WAS Node Suite alimenta o índice: incremento 1, máximo = o número de prompts. Um nó de exibição mostra o índice, que conta de 0 (prompt 1) a 9 (prompt 10). Para recomeçar, defina reset como true, execute uma vez, volte a false e execute de novo. Um nó de pré-visualização de texto mostra qual prompt está rodando.
Etapa 3: empilhamento de prompts
O empilhamento de prompts monta um prompt longo a partir de várias peças com um nó text concatenate: cada entrada acrescenta à string. No meu teste:
- Text B: o estilo, vindo da lista de prompts (por exemplo, um estilo «ork» de ficção científica).
- Text A: o assunto, uma longa descrição de um robô humanoide militar vinda do ChatGPT.
- Text C: o fundo, uma floresta.
Coloque a parte mais importante primeiro. Os codificadores de texto dão mais peso às palavras iniciais, então o assunto (um robô de combate) vai antes do estilo. Dito isso, o Flux segue bem o prompt como um todo.
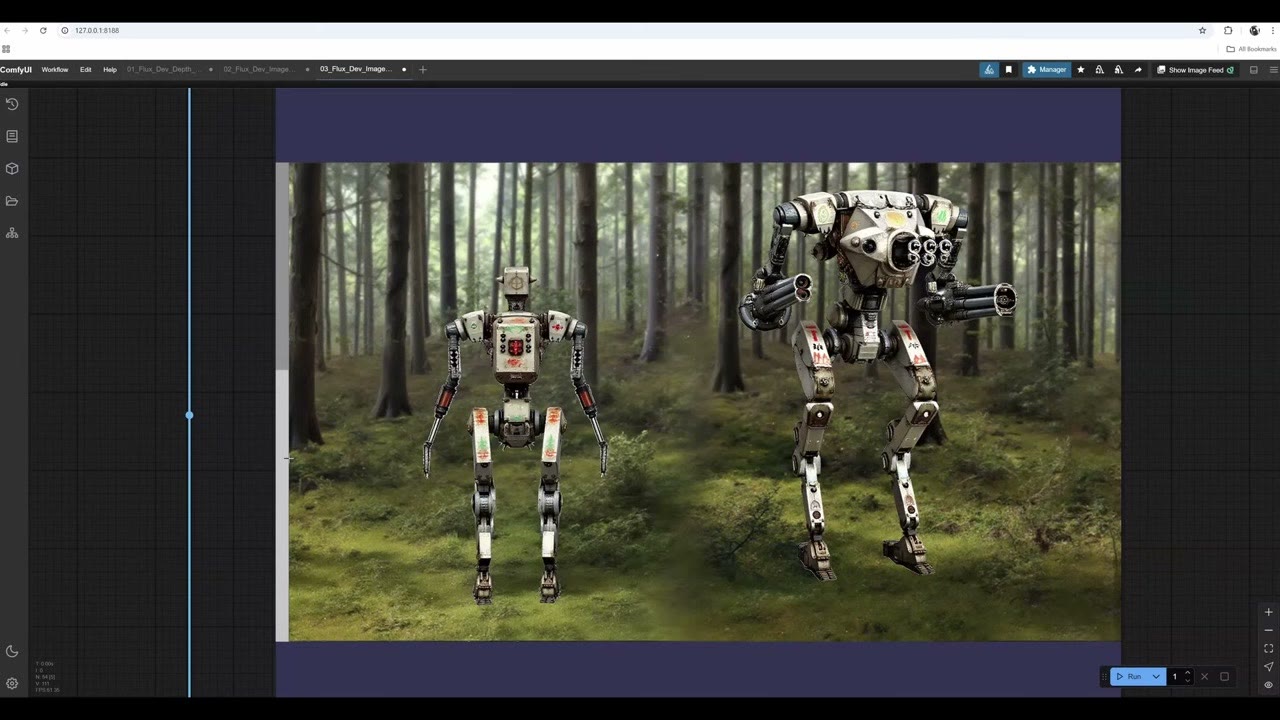
Não é minha melhor geração, mas segue o prompt. Eu rodaria mais cinco ou seis e escolheria a melhor, ou reduziria a força do ControlNet para ter mais liberdade. Quando achar um estilo de que goste, refine o prompt acrescentando e tirando palavras.
Etapa 4: uma pasta de capturas, cada uma com seu próprio prompt
Agora as capturas também vêm de uma pasta, pelo Load Image Batch, e o mesmo loop counter controla tanto o índice da imagem quanto o do prompt. O prompt 3 sempre vai com a captura 3.
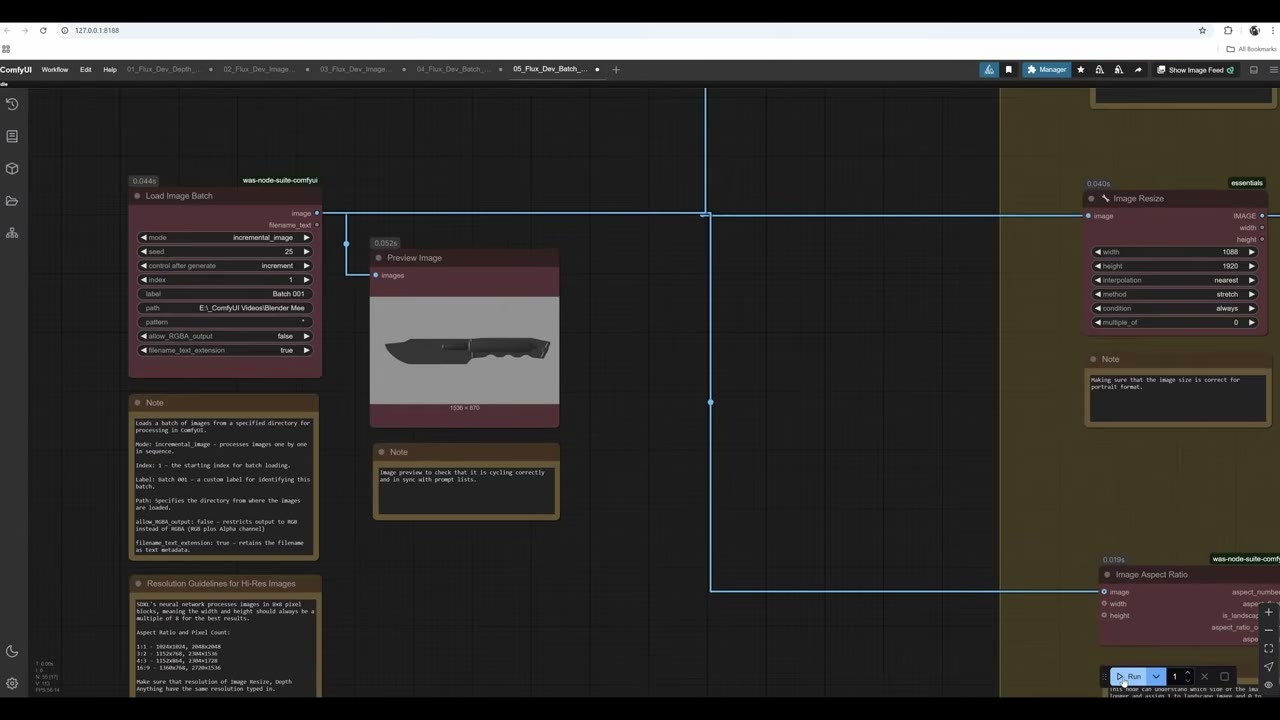
Eu tinha 18 capturas e uma lista de prompts de adereços de ficção científica com 18 descrições correspondentes: o lança-foguetes é a entrada 1, o fuzil automático a entrada 2, e assim por diante. Defina o máximo do contador como o número de capturas (eu o tinha deixado em 10 por engano; deveria ser 18). Use a pré-visualização da imagem e a do texto para conferir se a descrição combina com a captura.
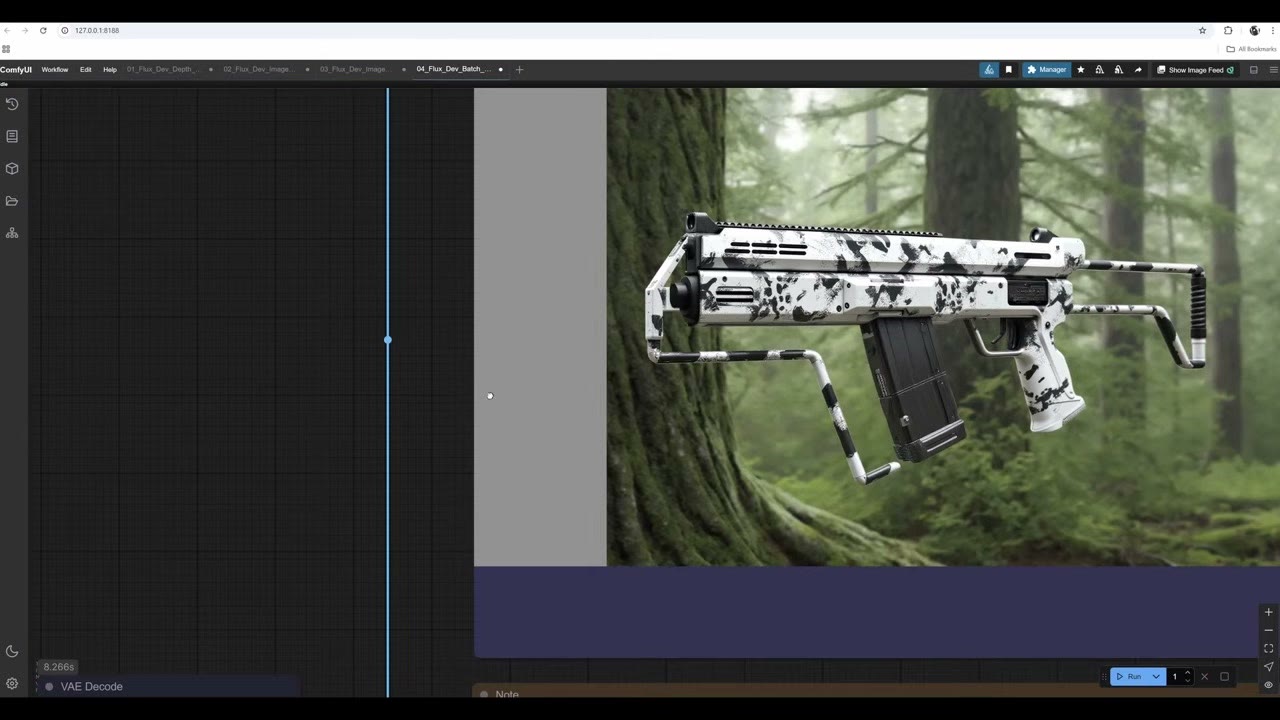
A submetralhadora saiu bem bonita. Não preenche o quadro, mas as empunhaduras e muitas das peças têm alta qualidade. Esta etapa não tem ordenação entre retrato e paisagem, então capturas em retrato ficam esticadas. Se todas as suas imagens forem paisagem, ou todas quadradas, este fluxo mais simples basta. Uso fluxos mais simples para muitos trabalhos.
Etapa 5: ordenando paisagem e retrato automaticamente
Para misturar adereços altos e largos, o fluxo precisa detectar a orientação de cada imagem e dimensionar a tela para combinar. Montei duas versões.
O image switch (mais fácil de ler). Cada imagem é redimensionada nos dois sentidos, para paisagem e para retrato. Um nó image aspect do WAS Node Suite dá 1 para paisagem e 0 para retrato, um nó pequeno converte esse número em verdadeiro/falso, e um image input switch escolhe a imagem redimensionada corretamente. O tamanho então vai para o Empty Latent Image. O lado ruim: você redimensiona cada imagem duas vezes e mantém as duas na memória.
O number switch (o que eu uso). Em vez de alternar imagens, ele alterna os números: dois number input switches, um para a largura e outro para a altura, controlados pelo mesmo valor verdadeiro/falso. Paisagem escolhe 1920 × 1088; retrato escolhe 1088 × 1920. É mais rápido e muito robusto, embora mais difícil de acompanhar. Até eu tenho dificuldade em ler depois de alguns dias longe, o que é em parte o motivo de eu ter gravado este vídeo.
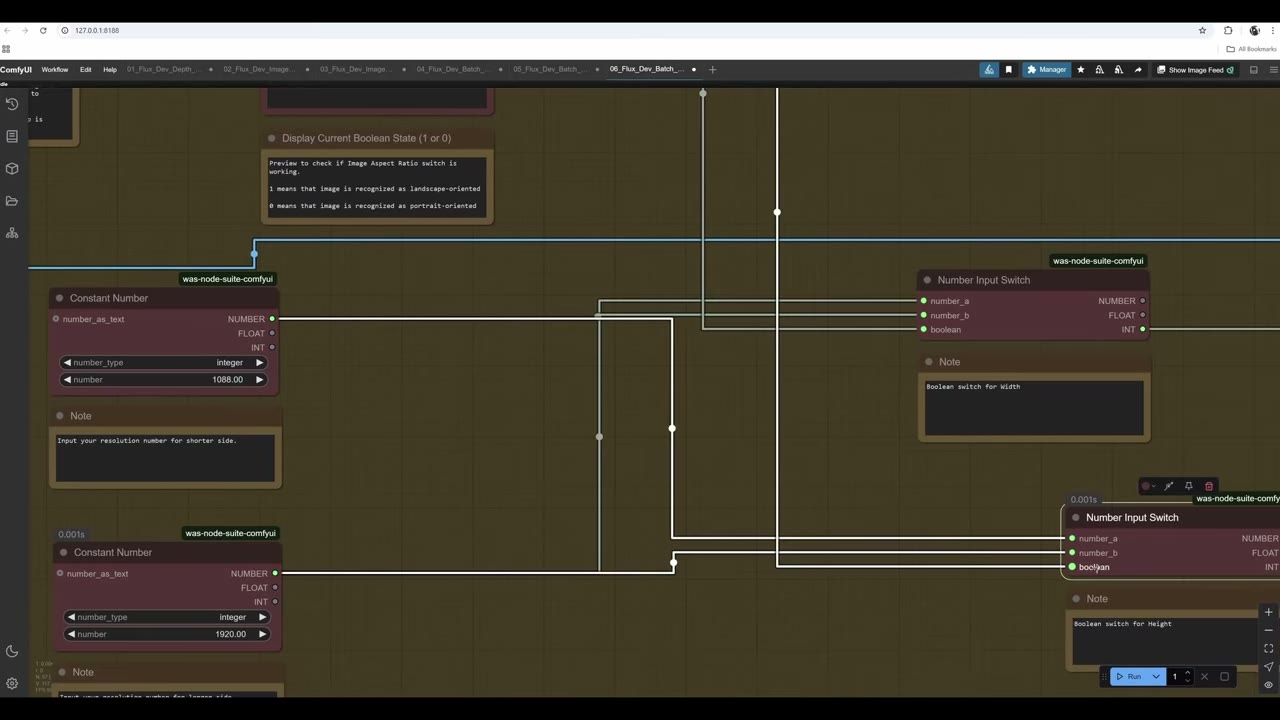
Há um guia à parte que explica esse truque de ordenação isoladamente: ordenar imagens por proporção no ComfyUI.
O pipeline completo
O fluxo completo combina tudo: mapa de profundidade, a ordenação com number switch, a pasta de capturas com sua lista de prompts e uma segunda lista de prompts para estilos. Cada parte é simples; juntas são difíceis de acompanhar, e por isso as montei separadamente.
Com dois loop counters você multiplica as variações. Meu loop de adereços percorria 18 capturas, e uma lista de cores com 54 entradas (18 azuis, 18 verdes, 18 brancas) rodava ao lado, então cada adereço foi renderizado em todas as cores. Outros materiais funcionam também: aço inox, fibra de carbono, «3D printed» (que saiu parecendo plástico). Para mudar uma lista, cole-a no ChatGPT e peça, por exemplo, para trocar branco por preto. Ele mantém o formato.
Por cima disso vêm um campo de estilo livre (camuflagem, padrões xadrez, qualquer coisa) e um campo de fundo.
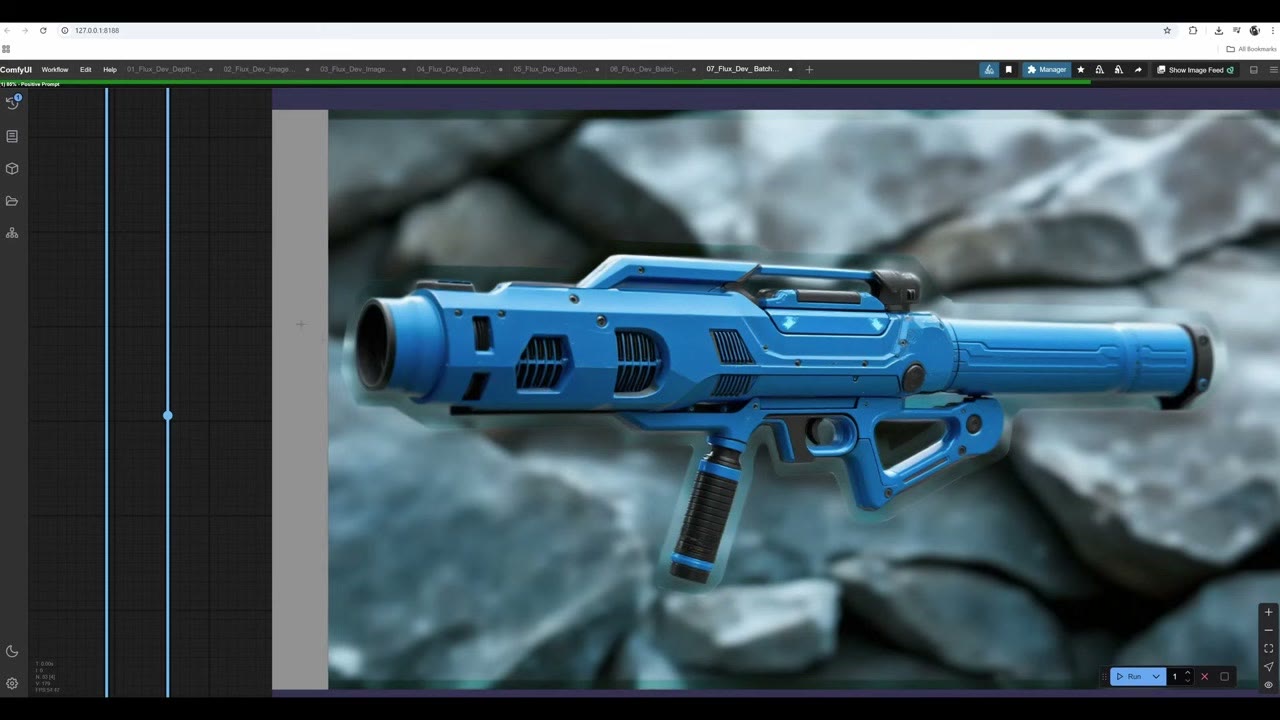
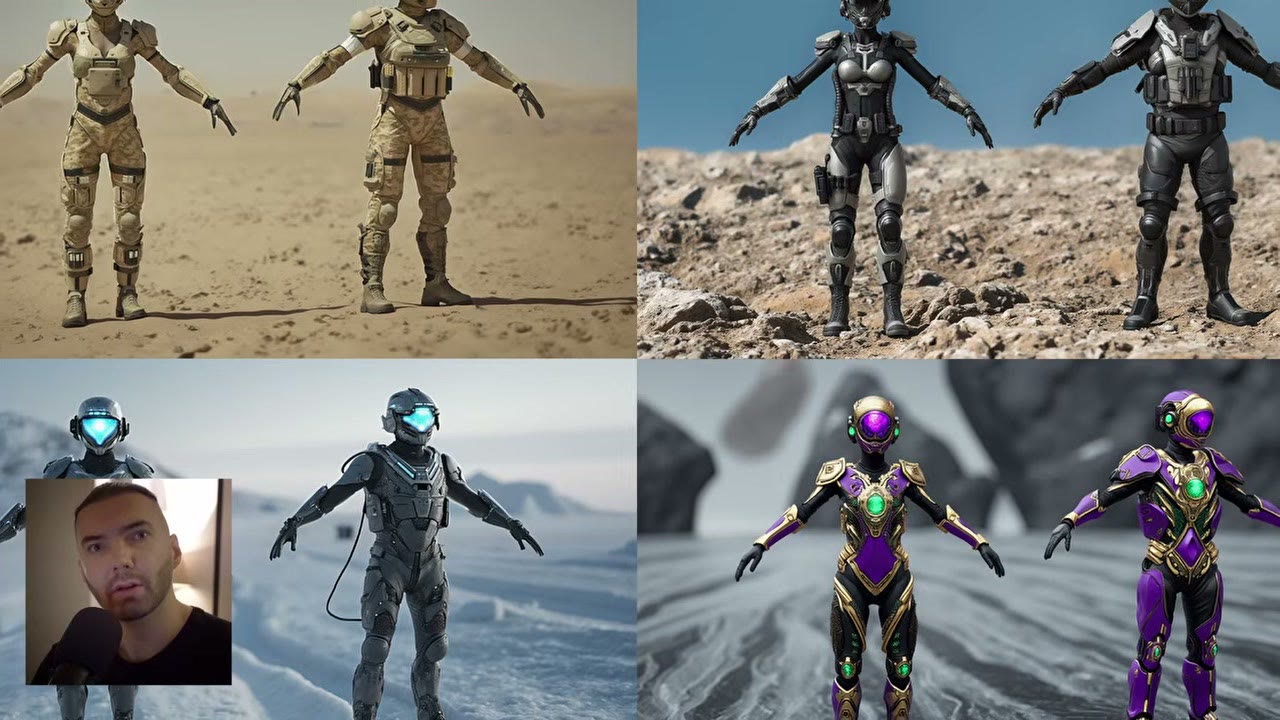
Usando no dia a dia:
- Mude o caminho da pasta para as suas capturas e a lista de prompts para combinar.
- Defina os contadores: com 10 capturas e 3 cores, o contador de estilo vai a 30. Rode durante a noite com dez cores e materiais e você terá 100 ideias de manhã.
- Defina os valores de largura e altura, inclusive no nó de profundidade, para imagens quadradas ou menores. O fluxo tem notas listando bons tamanhos.
- Para reiniciar tudo, defina o reset dos dois loop counters como true, execute, depois defina os dois como false e execute de novo. Pular para um prompt específico no meio da lista é complicado; para trabalhar num adereço só, uso um fluxo mais simples com apenas essa imagem e a lista de prompts.
Velocidade: na minha RTX A5000 com 24 GB de VRAM, uma imagem leva cerca de 160 segundos (300 quando outros modelos precisavam carregar antes). É bastante tempo, e por isso eu estava pensando em fazer upgrade.
Onde rodar
Você precisa de pelo menos 12 GB de VRAM para o Flux. Numa placa menor, use o modelo GGUF ou rode numa GPU alugada; depois passei esse tipo de trabalho para o RunPod, como descrito na minha introdução ao RunPod.
O link do RunComfy acima é um link de indicação, assim como meu link de indicação do RunPod: novas contas do RunPod que se cadastram com o Google ganham de US$ 5 a US$ 500 em crédito após seus primeiros US$ 10, e eu recebo uma pequena comissão.
Assista à versão em vídeo (29:54)
Tudo o que está acima também está no vídeo, se você preferir acompanhar na tela. O vídeo está em inglês.
Perguntas frequentes
De que GPU preciso para este pipeline?
Pelo menos 12 GB de VRAM para o Flux. Com menos VRAM, use a versão GGUF do Flux com um carregador GGUF: a qualidade não sofre muito. Na minha RTX A5000 de 24 GB, uma imagem levou cerca de 160 segundos.
Que força de ControlNet devo usar para blockouts 3D?
Cerca de 0,7 com o Flux; entre 0,6 e 0,8 funciona. Em 1,0 a imagem tem glitches. Com o SDXL desço mais, para cerca de 0,5.
Por que minha lista de prompts roda só o primeiro prompt, ou não se atualiza?
Uma lista de prompts precisa de um índice vindo de um loop counter para percorrer. Se você editar o arquivo de texto, recarregue o ComfyUI; se ainda usar o texto antigo, mude para outra lista, execute e volte.
Por que minhas imagens largas têm um contorno fino ou moldura em volta do adereço?
Vem do formato muito largo e não quadrado. Imagens quadradas dão os resultados mais previsíveis, mas adereços longos como lança-foguetes pedem imagens largas. Para concept art raramente importa.

Anton Tenitsky é artista 3D com mais de 15 anos em computação gráfica, que trabalhou com Nickelodeon, Gameloft, Marvel Rivals e muitos outros clientes. Mais sobre mim