Ein Text-Prompt beschreibt, was gemacht werden soll. Ein Referenzbild kann beschreiben, wie es aussehen soll. IPAdapter speist ein Bild zusammen mit dem Prompt in das Modell ein, sodass eine neue Generierung seinen Stil, seine Materialien oder seine Pose übernimmt. Hier nehme ich eine meiner alten 3D-Skulpturen und übertrage ihren Look auf einen Hund, dann kombiniere ich zwei und drei Bilder zu einem Ergebnis.
IPAdapter stammt aus dem Aufsatz IP-Adapter: Text Compatible Image Prompt Adapter for Text-to-Image Diffusion Models (Ye et al., 2023). In ComfyUI wird er vom Node-Paket IPAdapter Plus von Matteo (cubiq) umgesetzt.
Kurz gefasst
- Installation: IPAdapter Plus, ComfyUI Essentials, ein CLIP-Vision-Modell und das IPAdapter-Modell für SD 1.5, alles über den ComfyUI Manager.
- Ein Bild: IPAdapter Advanced zwischen Checkpoint und KSampler, mit einem Unified Loader, CLIP Vision und dem auf 512 × 512 skalierten Bild.
- Gewicht: 1,0 kopiert die Referenz; etwa 0,55 lässt den Prompt herein. Weak input verhindert, dass die Referenz das Motiv übertönt.
- Mehrere Bilder: ein IPAdapter Encoder pro Bild in Combine Embeds, Methode add, dann mit den Encoder-Gewichten ausgleichen. Bis zu drei Bilder bleiben steuerbar.
Wenn du neu bei ComfyUI bist, beginne mit ComfyUI-Node-Grundlagen und Text-zu-Bild. Der fertige Workflow ist ein kostenloser Download auf meinem Patreon; lade ihn und installiere fehlende Nodes über den Manager.
Die Nodes und Modelle installieren
- Manager → Custom Nodes Manager, suche nach IPAdapter und installiere ComfyUI IPAdapter plus (von Matteo, Version 2). Wähle die neueste Version und starte neu.
- Manager → Model Manager, suche nach CLIP Vision und installiere das Modell CLIP-ViT-H-14. Manche empfehlen auch ein zweites CLIP-Vision-Modell, das darunter aufgeführt ist; bei mir hat es nie funktioniert.
- Installiere im Custom Nodes Manager ComfyUI Essentials. Es fügt Nodes hinzu, die im normalen ComfyUI fehlen, darunter Image Resize.
- Suche im Model Manager nach IPAdapter und installiere das Modell IPAdapter for Stable Diffusion 1.5. Es gibt auch SDXL-Versionen, aber sie sind schwerer und langsamer. Solange du lernst und testest, ist SD 1.5 viel schneller, und die Ergebnisse sind ziemlich gut.
- Klicke auf Update All und aktualisiere ComfyUI, dann starte neu, damit alles auf dem neuesten Stand ist.
Die Modelldateien von IPAdapter liegen auch auf Hugging Face, falls du sie lieber von Hand herunterladen möchtest.
Das einfache Setup mit einem Bild
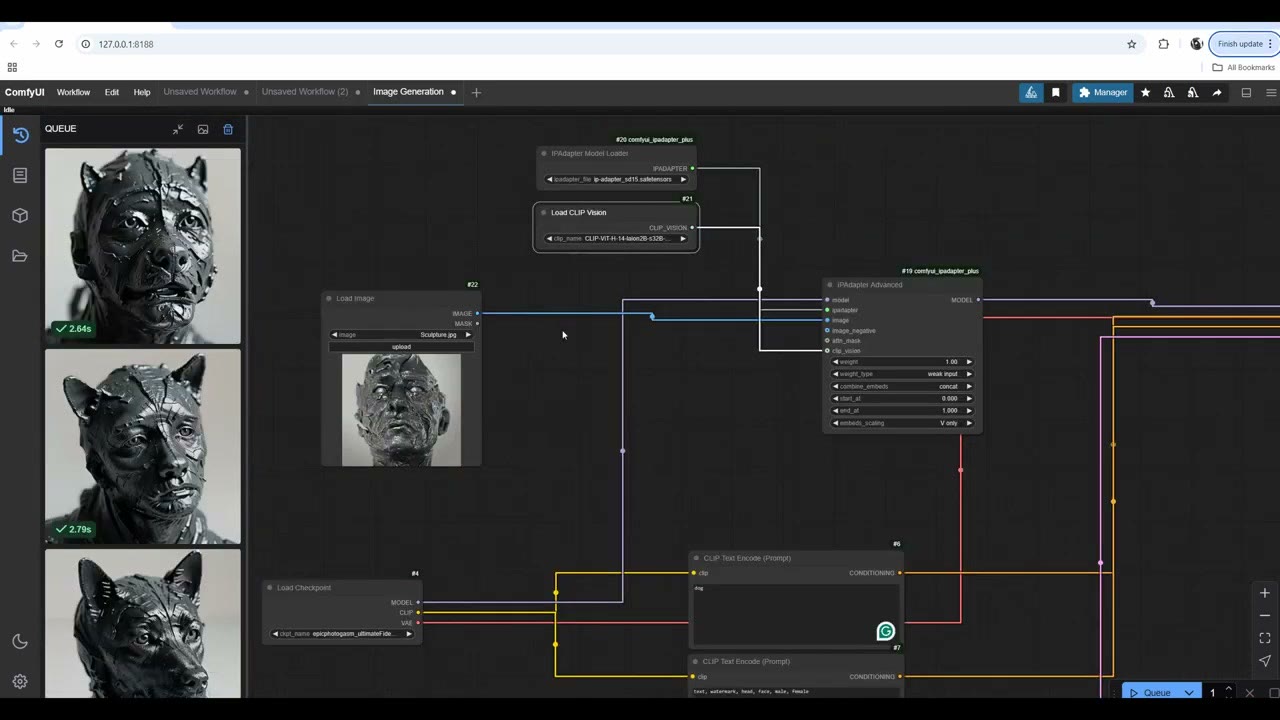
Beginne mit dem einfachen Template zur Bilderzeugung. Ich nutze epiCPhotoGasm, einen SD-1.5-Checkpoint.
- Füge IPAdapter Advanced hinzu. Das ist der Hauptnode. Sein Eingang model nimmt das Modell des Checkpoints auf, und sein Ausgang MODEL geht an den KSampler.
- Füge von seinem Eingang ipadapter aus einen IPAdapter Model Loader hinzu und setze ihn auf das SD-1.5-Modell (nicht das Gesichtsmodell).
- Füge von seinem Eingang clip_vision aus Load CLIP Vision mit dem installierten Modell hinzu. Das ist etwas verwirrend, da die Prompts bereits durch einen CLIP-Encoder laufen. Aber IPAdapter braucht diesen zusätzlichen Schritt, um das Bild in eine Form zu bringen, die er nutzen kann; ohne ihn funktioniert es nicht.
- Füge von seinem Eingang image aus Load Image hinzu. Ich habe eine Skulptur genutzt, die ich vor einigen Jahren gemacht habe.
Drücke Strg+Enter zum Ausführen und Q, um das Warteschlangen-Panel mit deinen Ergebnissen links zu öffnen.
Den Prompt durchbringen
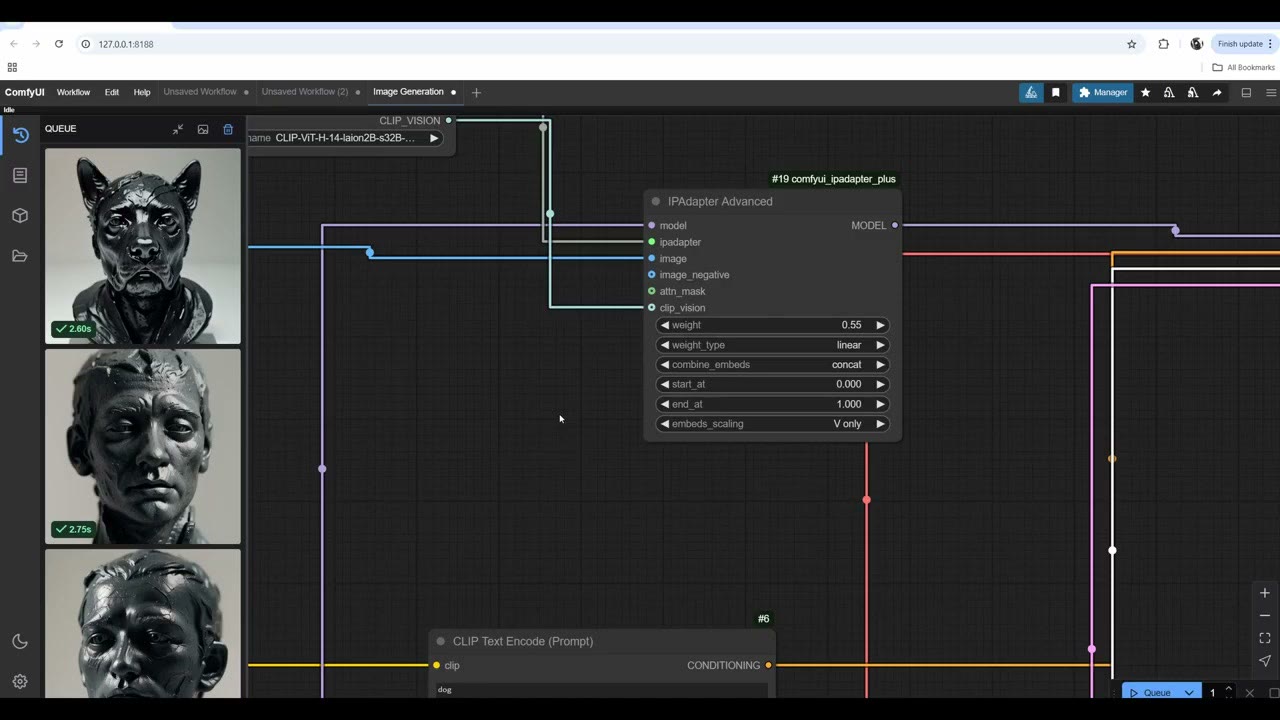
Mit dem Prompt „dog“ und dem Gewicht auf 1,0 passierte nichts: Das Ergebnis war nur die Skulptur. Das Gewicht muss ziemlich weit herunter. Unter 0,5 macht es nur einen Hund; irgendwo um 0,55 bekommst du die Übertragung. Selbst dann brauchte es ein paar Durchläufe. head, face, male, female in den negativen Prompt zu setzen, half ein wenig.
Gewichtstyp
- Linear wendet die Referenz gleichmäßig an.
- Ease in neigt zum Referenzbild: überwiegend das skulptierte Gesicht.
- Ease out neigt zum Prompt: nur ein Hund, ohne etwas aus der Referenz.
- Weak input / weak output sind recht selbsterklärend. Ich wollte weak input, damit das Gesicht den Hund nicht übertönt, aber Look und Stil trotzdem übertragen werden.
Unterstützende Nodes
Drei Ergänzungen machen das Setup klarer und liefern bessere Ergebnisse:
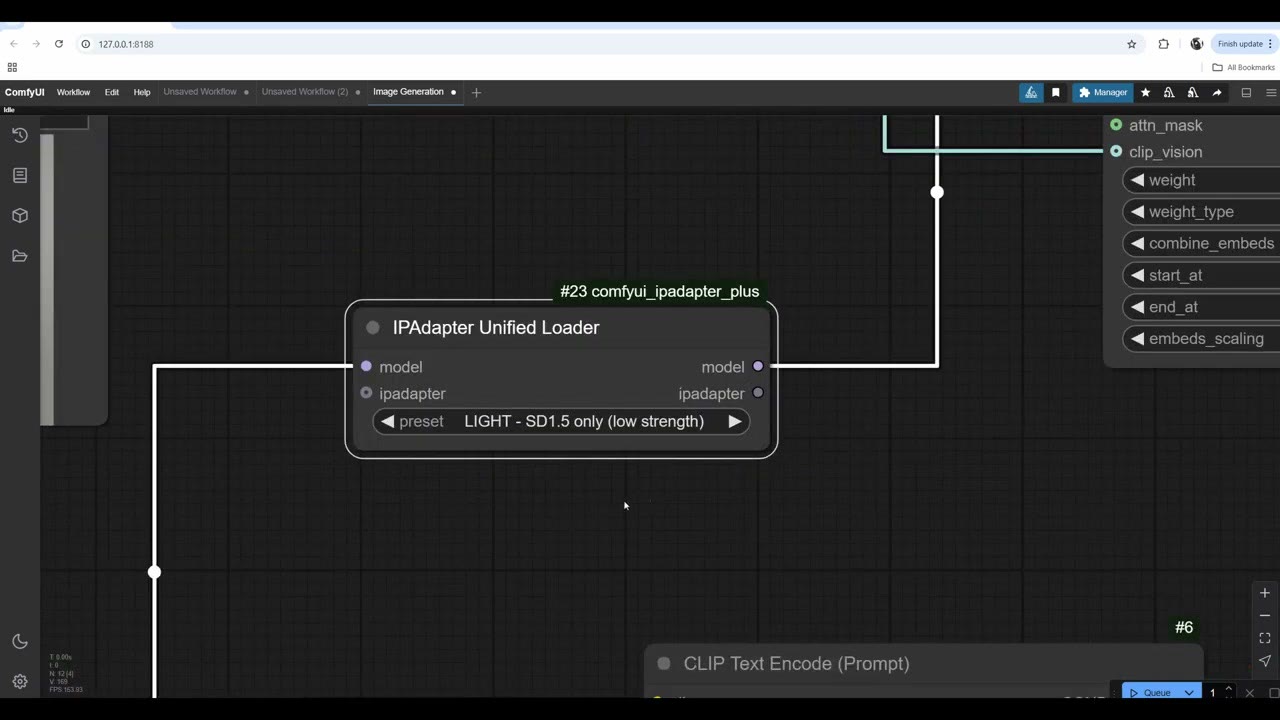
- IPAdapter Unified Loader: Verbinde das Modell des Checkpoints damit und seine Ausgänge mit den Eingängen model und ipadapter von IPAdapter Advanced. Seine Preset-Liste (zum Beispiel „LIGHT – SD1.5 only (low strength)“) ist leichter zu verstehen als die Auswahl von Modelldateien. Die Presets liefern unterschiedliche Ergebnisse; ich kann nicht sagen, welches besser ist, und ich nutze tendenziell niedrige Stärken und erledige das meiste Abstimmen im Advanced-Node.
- Image Resize (aus Essentials): SD 1.5 funktioniert am besten mit 512 × 512.
- Prep Image for ClipVision: zwischen der Skalierung und dem Bildeingang von IPAdapter. Er bereitet das Bild in einer Form vor, die IPAdapter besser versteht.
Für stilisiertere Ergebnisse nutzte ich ein Bild, das ich vor etwa zehn Jahren gemacht habe, mit „biker“ als Prompt. Mit weak input bei Gewicht 0,55 bekam ich einen coolen Schwarz-Weiß-3D-Skulptur-Look. Bei Gewicht 1, linear, wurden die Ergebnisse richtig stilisiert. Hier lässt sich viel ändern; probiere es immer wieder, und du entwickelst ein Gespür dafür, wie sich IPAdapter verhält.
Zwei Bilder kombinieren
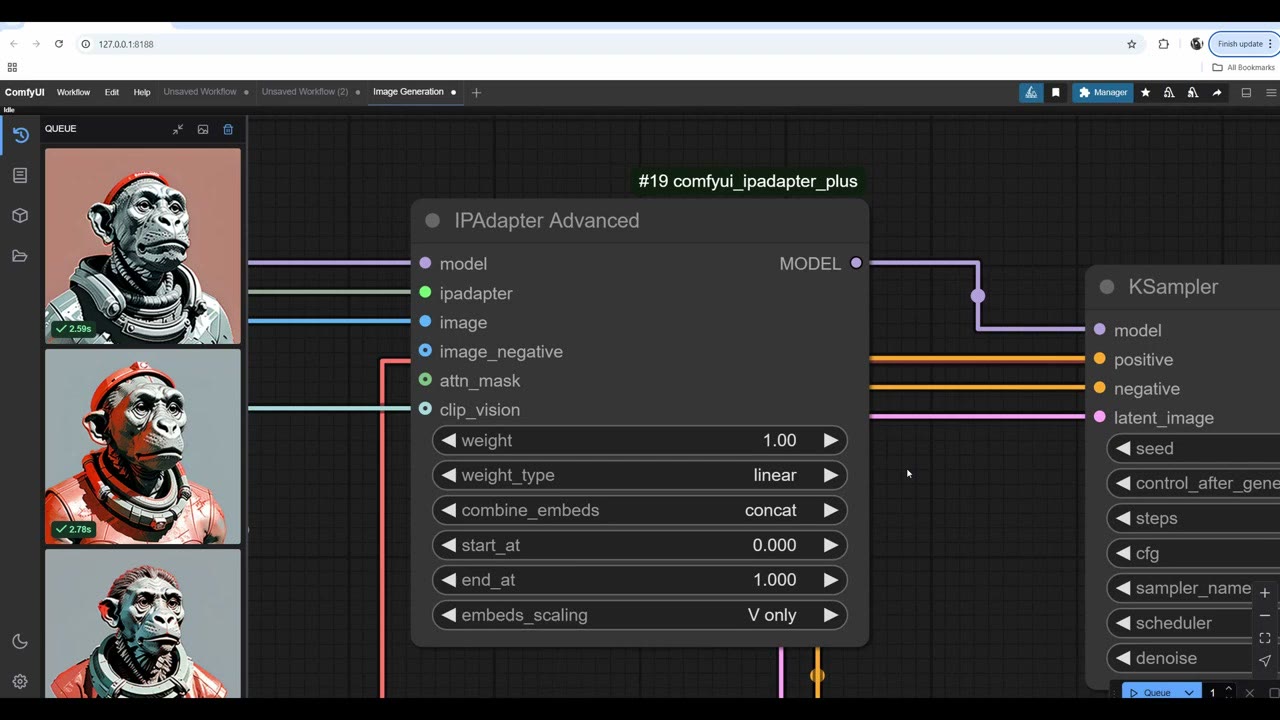
Das ist meine liebste Art, IPAdapter zu nutzen. Kopiere den Bildzweig (Strg+C, dann Strg+Umschalt+V zum Einfügen mit Verbindungen) und lade ein zweites Bild; ich habe ein Selfie genutzt. Dann:
- Ersetze IPAdapter Advanced durch IPAdapter Embeds und verbinde Modell und Ausgang neu.
- Füge für jedes Bild einen IPAdapter Encoder hinzu. Verbinde die Eingänge ipadapter und clip_vision jedes Encoders; man vergisst sie leicht.
- Füge IPAdapter Combine Embeds hinzu. Das pos_embed jedes Encoders geht in embed1, embed2 und so weiter, und die kombinierten EMBEDS gehen in den positiven Eingang des Embeds-Nodes.
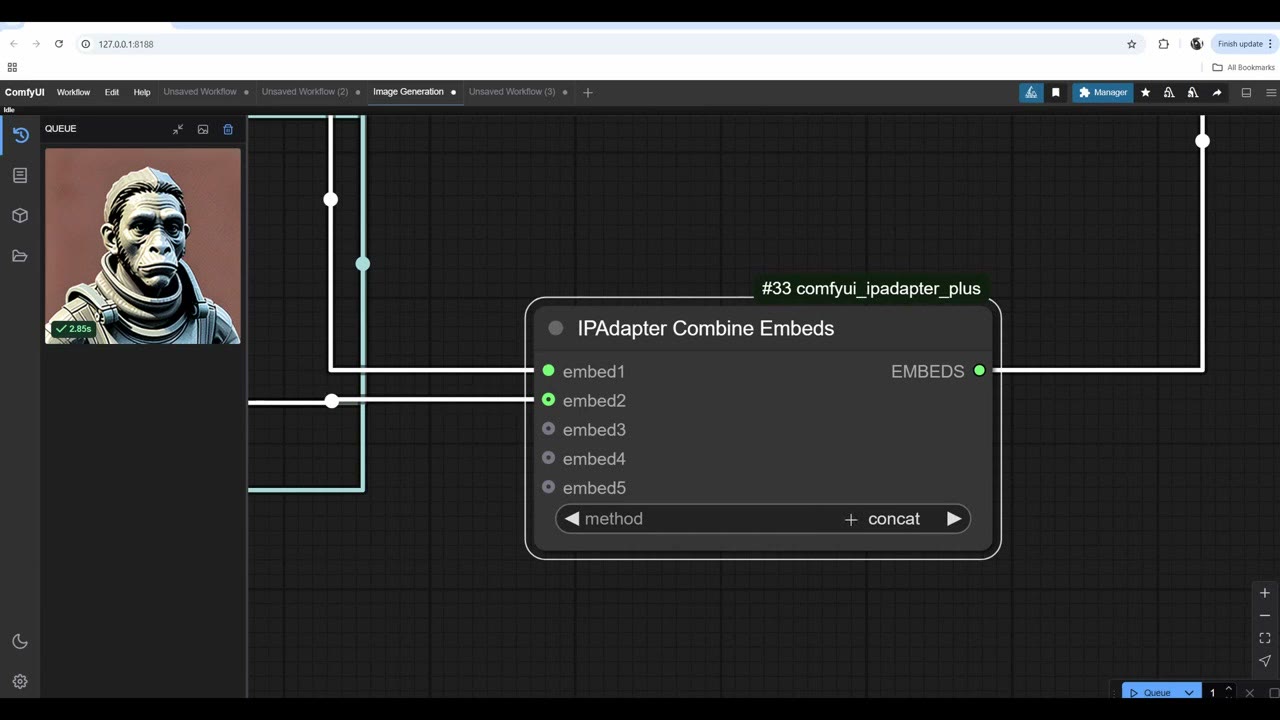
Die Methode zählt. Mit concat, das ein Bild nach dem anderen setzt, bekam ich überwiegend Affe und wenig von mir. Add bildet den Durchschnitt (average tut etwas Ähnliches), und der Affe bekam mehr menschliche Züge. Mit add übernahm es auch meine Pose: Ich blickte nach vorn und der Affe schaute zur Seite, und das Ergebnis kopierte meine Pose, während es den Stil und die Haare des Affen anwandte.
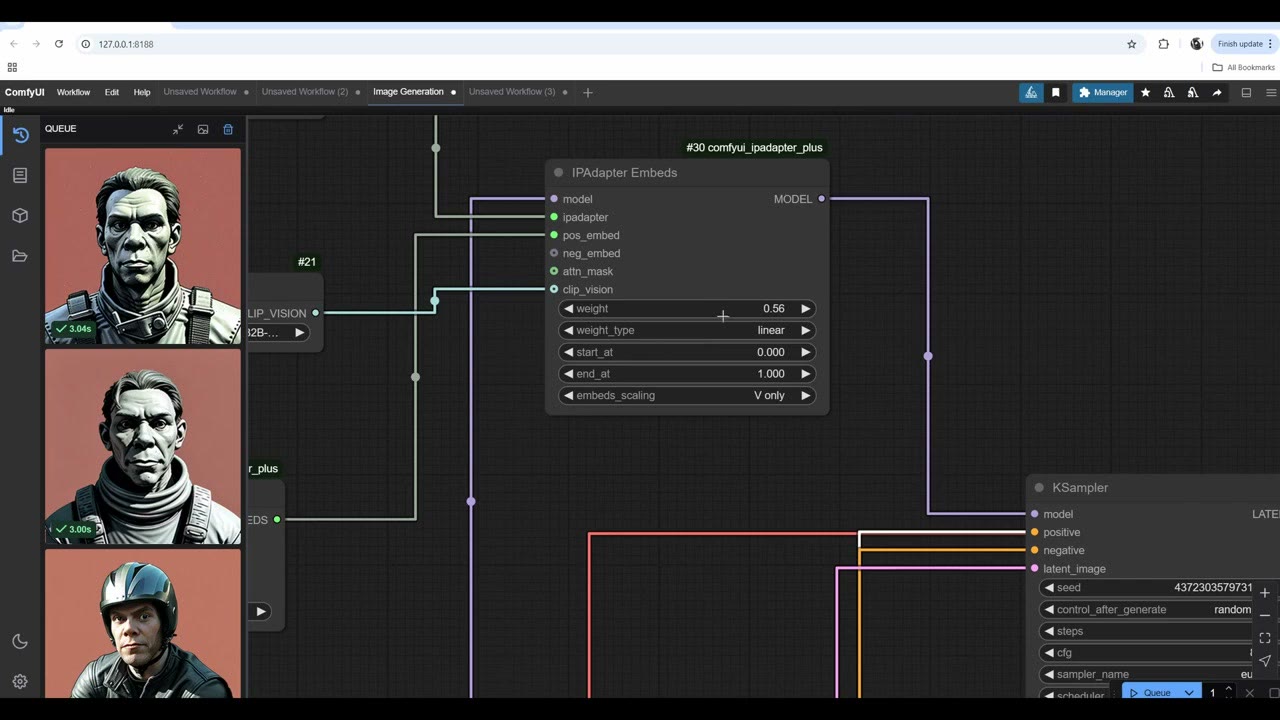
Gleiche mit den Encoder-Gewichten aus. Setze den Encoder meines Gesichts auf 2, und er übernimmt. Setze den des Affen auf 3, und der Affe wird stärker und übernimmt auch die Pose, indem er sich in eine Dreiviertelansicht dreht.
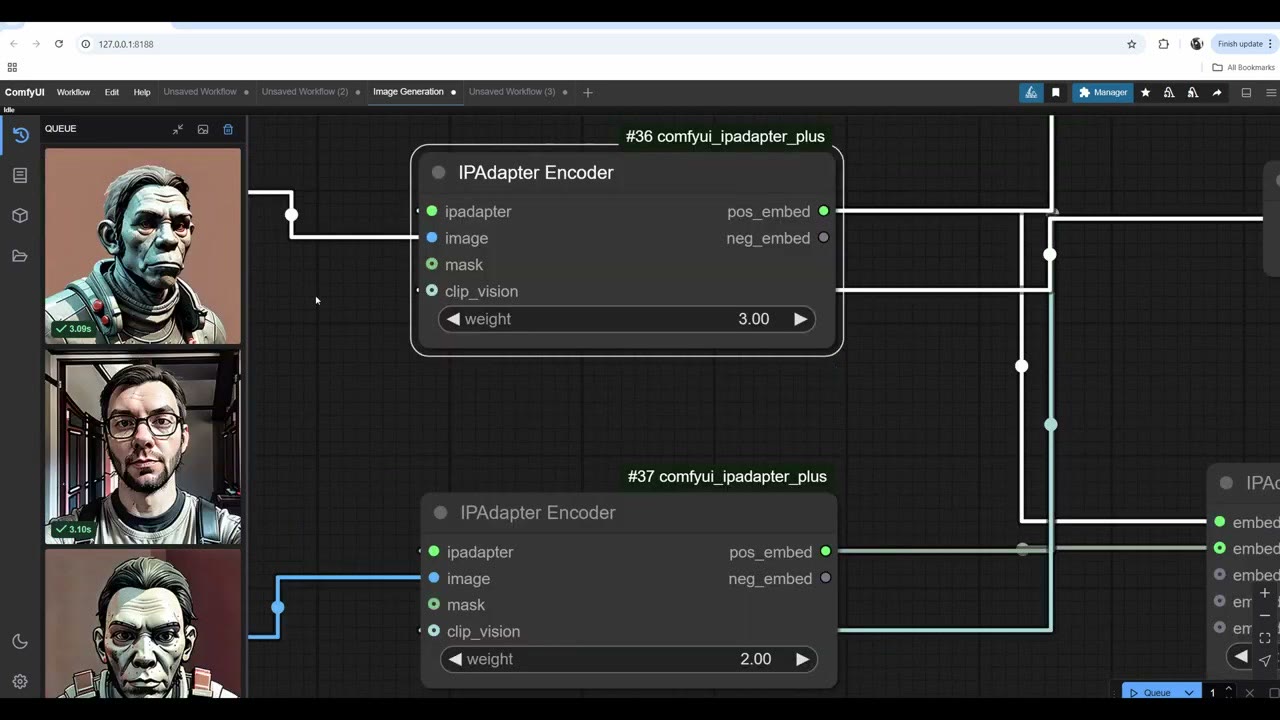
In dieser Phase wurde der Prompt („biker“) völlig ignoriert; nur die eingebetteten Bilder zählten. Das Gewicht von IPAdapter zu senken, brachte einen Biker mit rotem Hintergrund und etwas Biker-Kleidung zurück, aber nichts, was mit einem der Bilder zu tun hatte. Das wird unvorhersehbar und schwer zu steuern. Ich würde lieber gar keinen Prompt nutzen und die Bilder die Leitplanken sein lassen; die Ergebnisse sind vorhersehbarer.
Drei Bilder kombinieren
Drei Bilder lassen sich immer noch kombinieren und steuern; über drei wird es knifflig. Mein drittes Bild war ein Ausschnitt aus dem Fotopaket white marine cliffs and sand bei Fotoref, wo ich Mitgründer bin.
- Schneide die Referenz zu einem Quadrat von 512 × 512 zu. Ein rechteckiges Bild wird durch die Skalierung gestaucht, was einen hässlichen Effekt ins Ergebnis trägt.
- Verbinde das positive Embed, das ipadapter und das clip_vision seines Encoders.
- Ich nutzte Encoder-Gewichte von 1, 1,5 und 2.
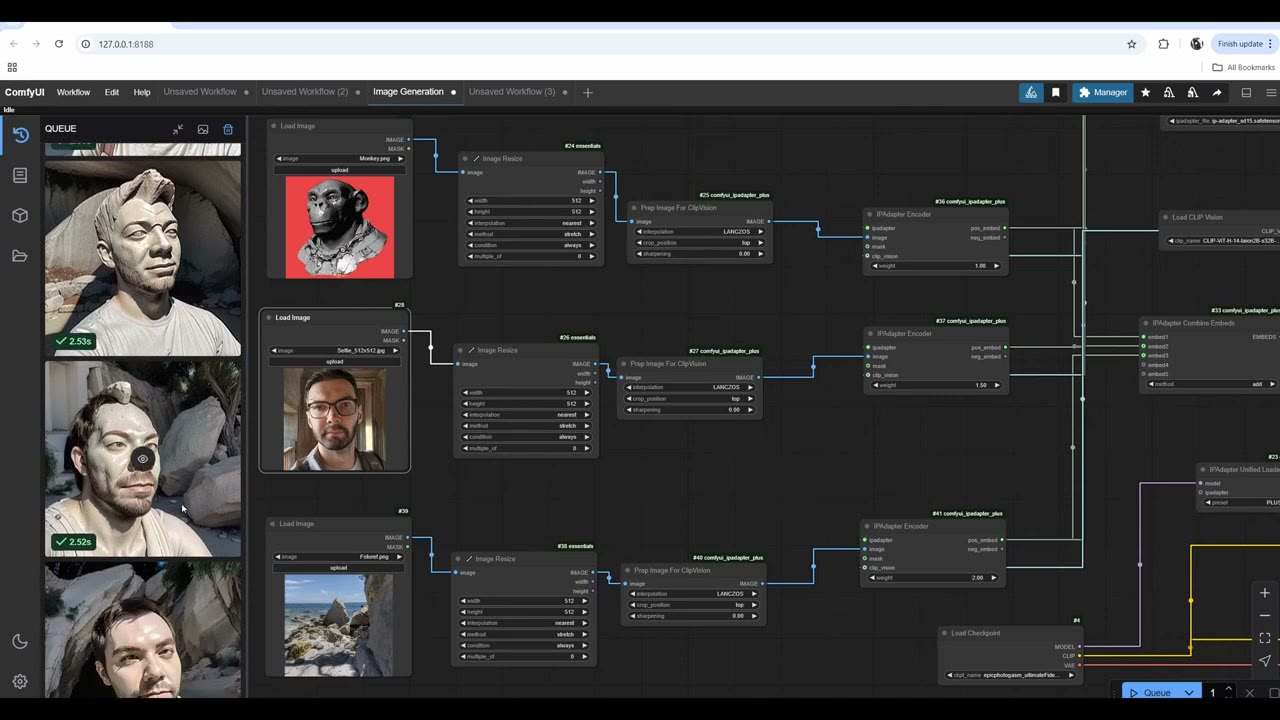
Nicht jeder Durchlauf war gut, aber mir gefiel, was durchkam: Felsen aus der Landschaft, meine Brille (jetzt eine Sonnenbrille), die Dreiviertel-Gesichtsposition des Affen und ein kahler Kopf. Manche Durchläufe bekamen einen Ton-Look, der meiner Meinung nach eher von den Klippen als vom Affen kommt.
Ich habe auch das Modell DreamShaper probiert, das einen etwas stilisierteren Look lieferte. So oder so musst du Variationen ausführen, bis du etwas bekommst, das dir gefällt.
Nächste Schritte
Um IPAdapter auf einen Teil des Bildes zu konzentrieren, kombiniere ihn mit einer Maske; siehe alles maskieren mit Florence 2. Um Ergebnisse wie diese zu schärfen, siehe kostenloses KI-Upscaling mit SD 1.5. Für einen Stil, den das Modell dauerhaft lernt, trainiere ein LoRA.
Die Videoversion ansehen (9:32)
Alles oben steht auch im Video, falls du lieber am Bildschirm mitmachst. Das Video ist auf Englisch.
Häufige Fragen
Warum ignoriert IPAdapter meinen Prompt?
Bei Gewicht 1,0 dominiert das Referenzbild. Senke das Gewicht: In diesem Test begann der Prompt erst bei etwa 0,55 sichtbar zu werden, und unter 0,5 war die Referenz größtenteils verschwunden. Wenn du mehrere Bilder mit Combine Embeds kombinierst, wird der Prompt weitgehend ignoriert.
Welche Kombinationsmethode sollte ich für zwei Bilder nutzen?
Concat stellt die Bilder hintereinander, und eines neigt dazu zu dominieren. Add (oder average) mischt sie; in meinem Test übernahm es auch die Pose aus dem zweiten Bild. Gleiche sie dann mit den Encoder-Gewichten aus.
Wie viele Bilder kann IPAdapter kombinieren?
Drei sind noch steuerbar. Über drei wird es knifflig.
Sollte ich die IPAdapter-Modelle für SD 1.5 oder SDXL verwenden?
Es gibt SDXL-Modelle, aber sie sind schwerer und langsamer. Zum Lernen und Testen von Workflows ist SD 1.5 viel schneller, und die Ergebnisse sind gut.

Anton Tenitsky ist 3D-Artist mit mehr als 15 Jahren Erfahrung in der Computergrafik, tätig für Nickelodeon, Gameloft, Marvel Rivals und viele weitere Kunden. Mehr über mich