Un prompt de texto describe qué hacer. Una imagen de referencia puede describir cómo debe verse. IPAdapter introduce una imagen en el modelo junto con el prompt, de modo que una nueva generación recoge su estilo, sus materiales o su pose. Aquí tomo una de mis viejas esculturas 3D y transfiero su aspecto a un perro; luego combino dos y tres imágenes en un solo resultado.
IPAdapter viene del artículo IP-Adapter: Text Compatible Image Prompt Adapter for Text-to-Image Diffusion Models (Ye et al., 2023). En ComfyUI lo implementa el paquete de nodos IPAdapter Plus de Matteo (cubiq).
En resumen
- Instala: IPAdapter Plus, ComfyUI Essentials, un modelo CLIP Vision y el modelo IPAdapter de SD 1.5, todo desde el ComfyUI Manager.
- Una imagen: IPAdapter Advanced entre el checkpoint y el KSampler, con un Unified Loader, CLIP Vision y la imagen redimensionada a 512 × 512.
- Peso: 1,0 copia la referencia; unos 0,55 dejan entrar al prompt. Weak input evita que la referencia domine al sujeto.
- Varias imágenes: un IPAdapter Encoder por imagen hacia Combine Embeds, método add, y luego equilibra con los pesos de los encoders. Hasta tres imágenes siguen siendo controlables.
Si eres nuevo en ComfyUI, empieza por fundamentos de nodos de ComfyUI y texto a imagen. El flujo terminado se puede descargar gratis en mi Patreon; cárgalo e instala los nodos que falten desde el Manager.
Instala los nodos y los modelos
- Manager → Custom Nodes Manager, busca IPAdapter e instala ComfyUI IPAdapter plus (el de Matteo, versión 2). Elige la última versión y reinicia.
- Manager → Model Manager, busca CLIP Vision e instala el modelo CLIP-ViT-H-14. Algunas personas recomiendan también un segundo modelo CLIP Vision que aparece debajo; a mí nunca me funcionó.
- En el Custom Nodes Manager, instala ComfyUI Essentials. Añade nodos que le faltan al ComfyUI estándar, incluido Image Resize.
- En el Model Manager, busca IPAdapter e instala el IPAdapter para Stable Diffusion 1.5. También existen versiones de SDXL, pero son más pesadas y lentas. Mientras estás aprendiendo y probando, SD 1.5 es mucho más rápido y los resultados son bastante buenos.
- Haz clic en Update All y actualiza ComfyUI, y luego reinicia, para que todo esté al día.
Los archivos del modelo IPAdapter también están en Hugging Face, si prefieres descargarlos a mano.
La configuración básica de una imagen
Empieza desde la plantilla básica de generación de imágenes. Uso epiCPhotoGasm, un checkpoint SD 1.5.
- Añade IPAdapter Advanced. Es el nodo principal. Su entrada model toma el modelo del checkpoint, y su salida MODEL va al KSampler.
- Desde su entrada ipadapter, añade un IPAdapter Model Loader y fíjalo en el modelo SD 1.5 (no en el modelo de rostros).
- Desde su entrada clip_vision, añade Load CLIP Vision con el modelo que instalaste. Esto resulta algo confuso, porque los prompts ya pasan por un codificador CLIP. Pero IPAdapter necesita este paso adicional para convertir la imagen en una forma que pueda usar; sin él, no funciona.
- Desde su entrada image, añade Load Image. Yo usé una escultura que hice hace unos años.
Pulsa Ctrl+Enter para ejecutar, y Q para abrir el panel de cola con tus resultados a la izquierda.
Hacer que pase el prompt
Con el prompt «dog» y el peso en 1,0, no pasó nada: el resultado era solo la escultura. El peso tiene que bajar bastante. Por debajo de 0,5 solo hace un perro; alrededor de 0,55 obtienes la transferencia. Incluso así llevó unas cuantas ejecuciones. Poner head, face, male, female en el prompt negativo ayudó un poco.
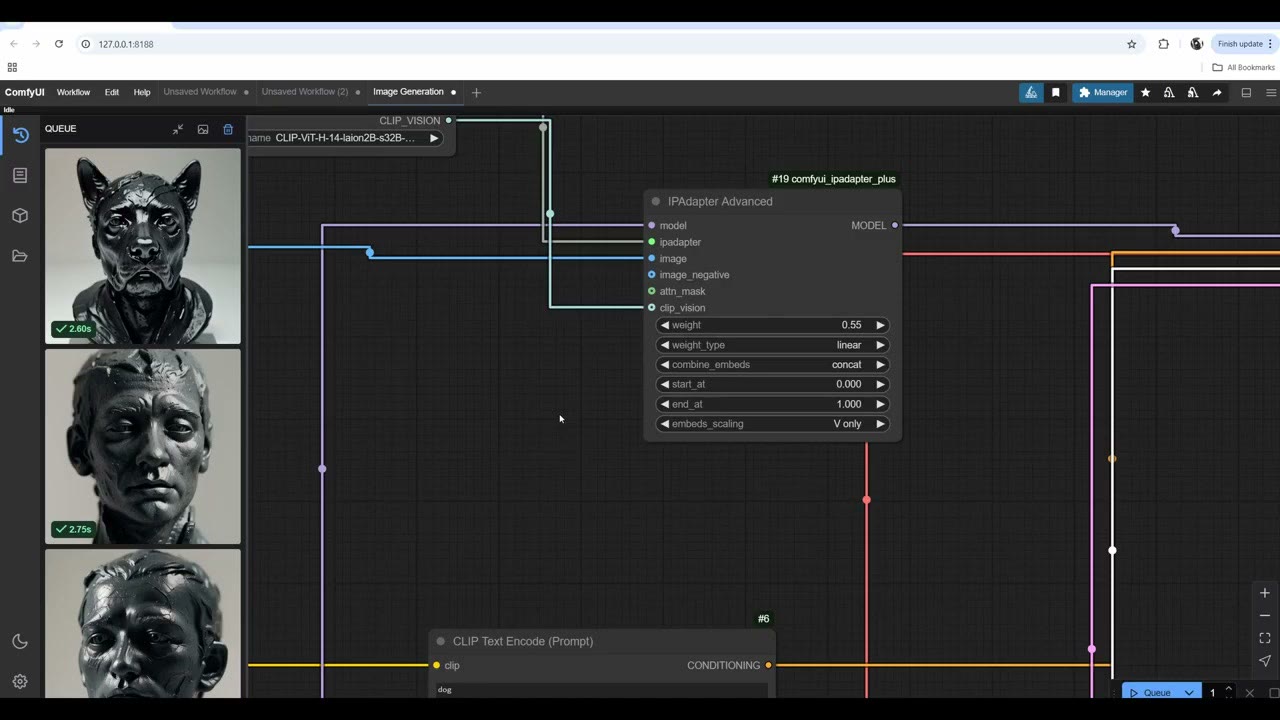
Tipo de peso
- Linear aplica la referencia de forma uniforme.
- Ease in se inclina hacia la imagen de referencia: casi solo el rostro esculpido.
- Ease out se inclina hacia el prompt: solo un perro, sin nada de la referencia.
- Weak input / weak output se explican bastante por sí solos. Yo quería weak input, para que el rostro no domine al perro pero el aspecto y el estilo sigan transfiriéndose.
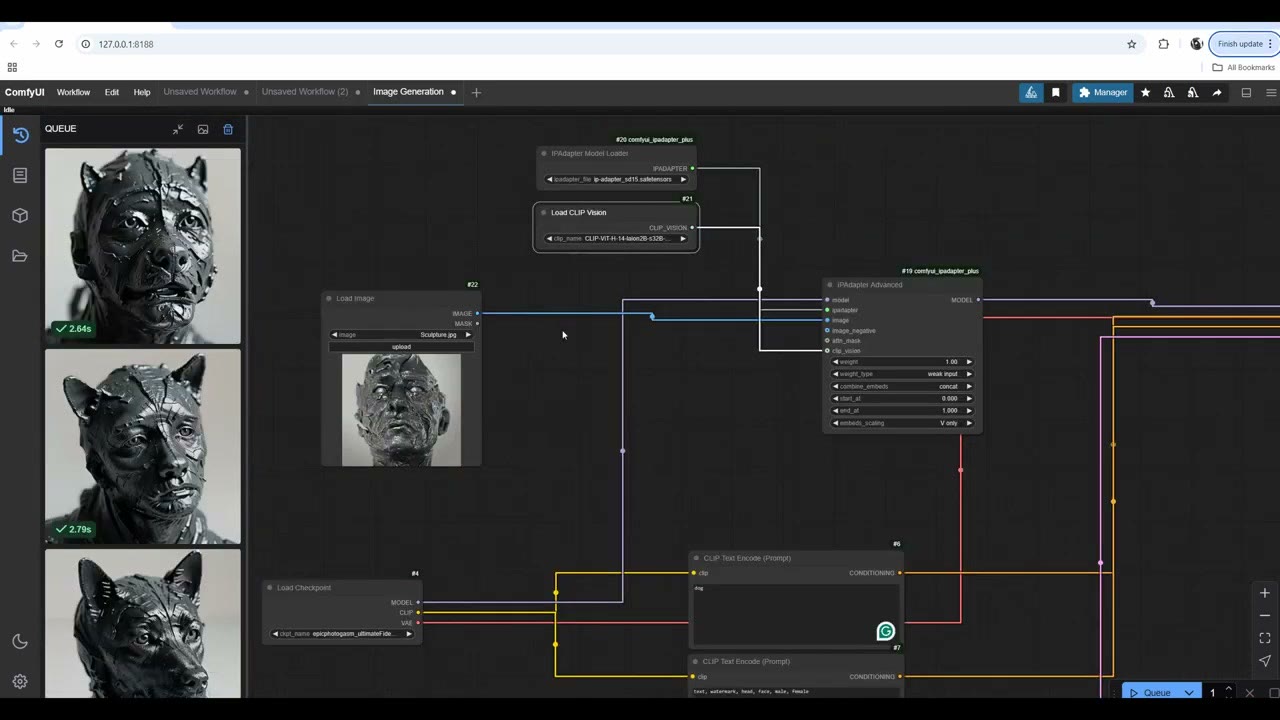
Nodos de apoyo
Tres añadidos hacen la configuración más clara y dan mejores resultados:
- IPAdapter Unified Loader: conecta el modelo del checkpoint a él, y sus salidas a las entradas model e ipadapter de IPAdapter Advanced. Su lista de preset (por ejemplo, «LIGHT – SD1.5 only (low strength)») es más fácil de entender que elegir archivos de modelo. Los presets producen resultados distintos; no sé decir cuál es mejor, y suelo usar fuerzas bajas y hacer la mayor parte del ajuste en el nodo Advanced.
- Image Resize (de Essentials): SD 1.5 funciona mejor a 512 × 512.
- Prep Image for ClipVision: entre el cambio de tamaño y la entrada de imagen de IPAdapter. Prepara la imagen de una forma que IPAdapter entiende mejor.
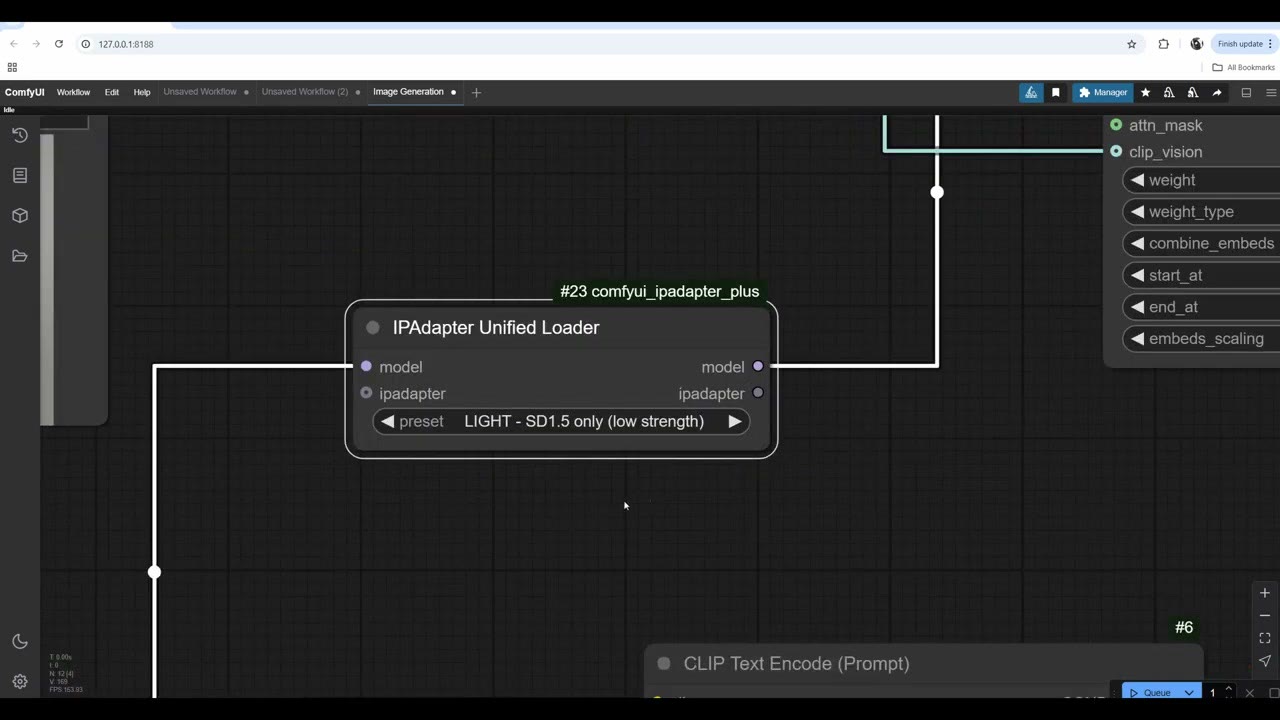
Para obtener resultados más estilizados usé una imagen que hice hace unos diez años, con «biker» como prompt. Con weak input a peso 0,55 obtuve un aspecto genial de escultura 3D en blanco y negro. Con peso 1, linear, los resultados se volvieron muy estilizados. Hay mucho que cambiar aquí; pruébalo, una y otra vez, y desarrollarás un instinto de cómo se comporta IPAdapter.
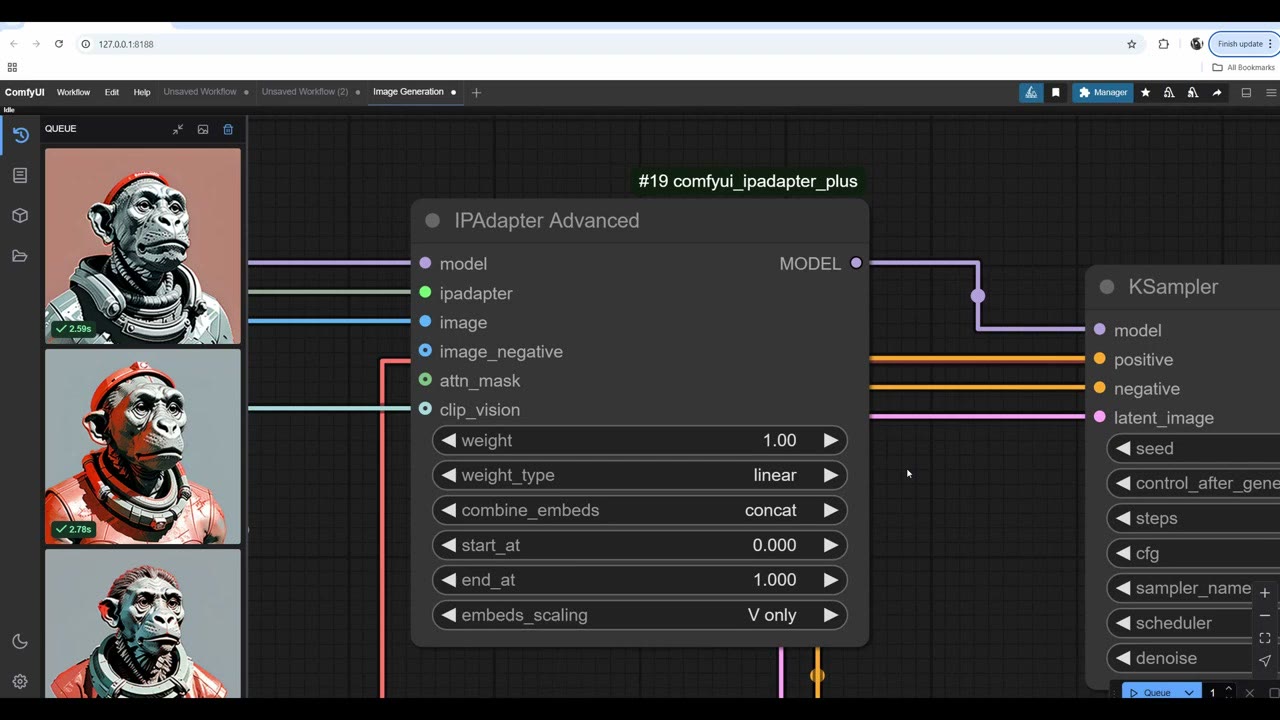
Combinar dos imágenes
Esta es mi forma favorita de usar IPAdapter. Copia la rama de la imagen (Ctrl+C, y luego Ctrl+Shift+V para pegarla con las conexiones) y carga una segunda imagen; yo usé un selfie. Luego:
- Sustituye IPAdapter Advanced por IPAdapter Embeds, y vuelve a conectar el modelo y su salida.
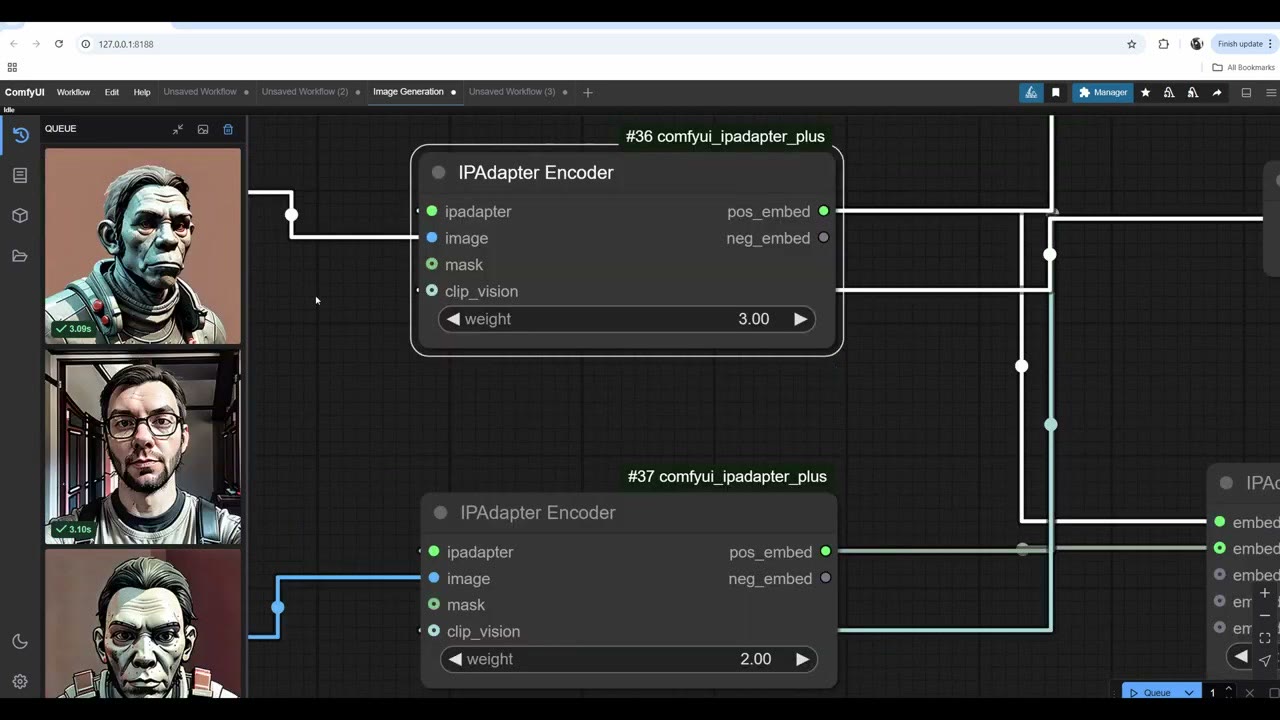
- Añade un IPAdapter Encoder por cada imagen. Conecta las entradas ipadapter y clip_vision de cada encoder; es fácil olvidarlo.
- Añade IPAdapter Combine Embeds. El pos_embed de cada encoder va a embed1, embed2 y así, y los EMBEDS combinados van a la entrada positive del nodo Embeds.
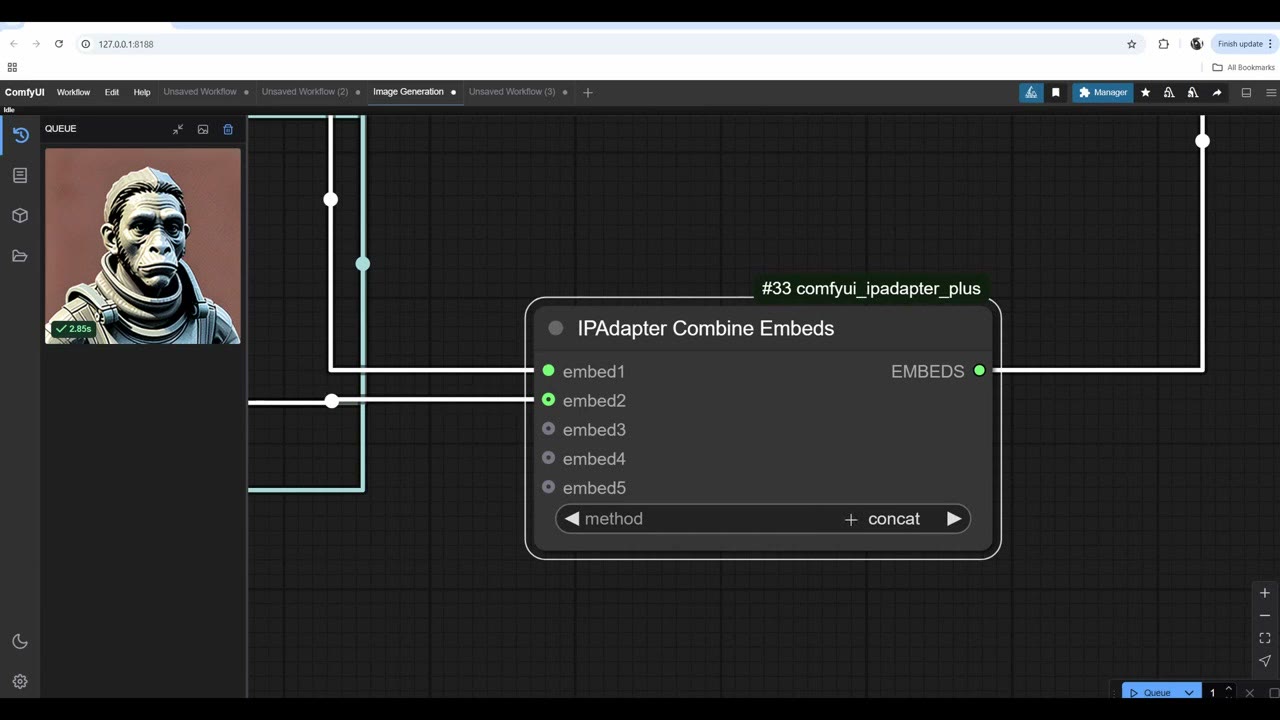
El método importa. Con concat, que pone una imagen tras la otra, obtuve sobre todo mono y poco de mí. Add las promedia (average hace algo parecido), y el mono adquirió más rasgos humanos. Con add también tomó mi pose: yo miraba de frente y el mono miraba hacia un lado, y el resultado copió mi pose aplicando el estilo y el pelo del mono.
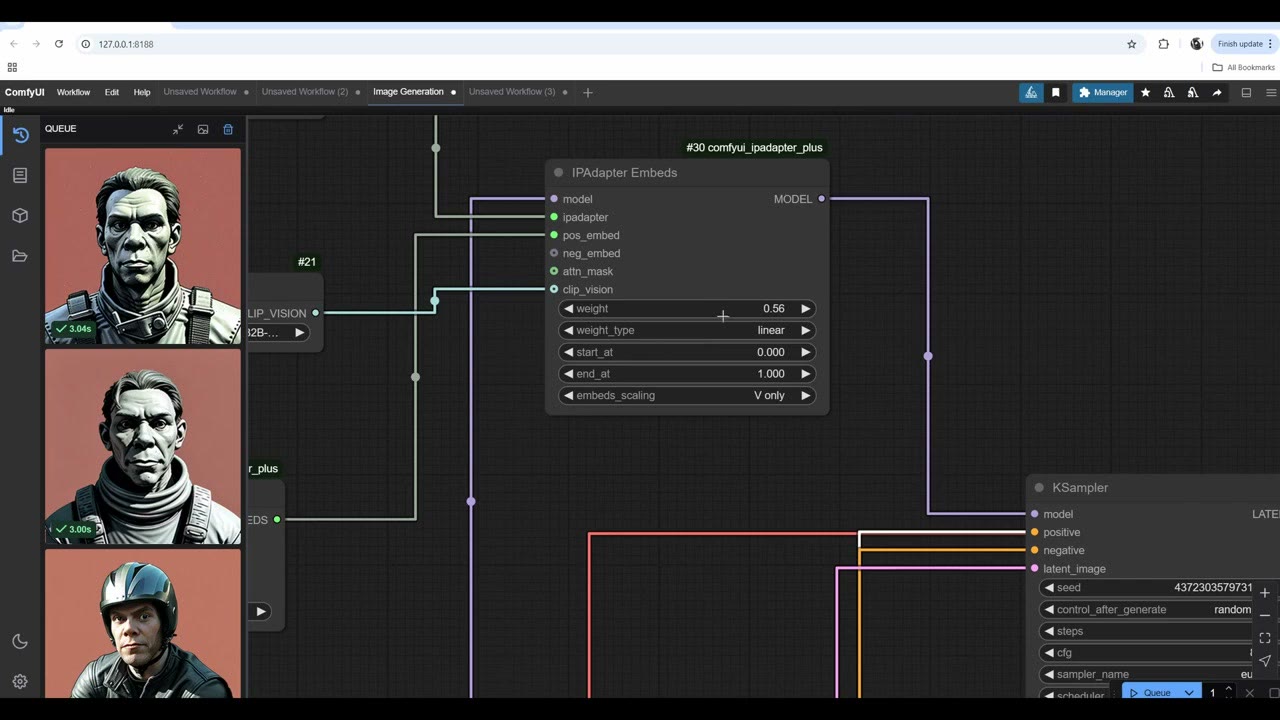
Equilibra con los pesos de los encoders. Pon el encoder de mi rostro en 2 y toma el control. Pon el del mono en 3 y el mono se hace más fuerte y también toma la pose, girándose a una vista de tres cuartos.
En esta fase el prompt («biker») se ignoró por completo; solo contaron las imágenes incrustadas. Bajar el peso de IPAdapter devolvió un motero con un fondo rojo y algo de ropa de motero, pero sin relación con ninguna de las dos imágenes. Eso se vuelve impredecible y difícil de controlar. Prefiero no usar ningún prompt y dejar que las imágenes sean los raíles guía; los resultados son más predecibles.
Combinar tres imágenes
Con tres imágenes todavía se puede combinar y controlar; por encima de tres se complica. Mi tercera imagen fue un recorte del pack de fotos white marine cliffs and sand de Fotoref, donde soy cofundador.
- Recorta la referencia a un cuadrado, 512 × 512. Una imagen rectangular se aplasta al redimensionarla, lo que arrastra un efecto feo hasta el resultado.
- Conecta el positive embed, el ipadapter y el clip_vision de su encoder.
- Usé pesos de encoder de 1, 1,5 y 2.
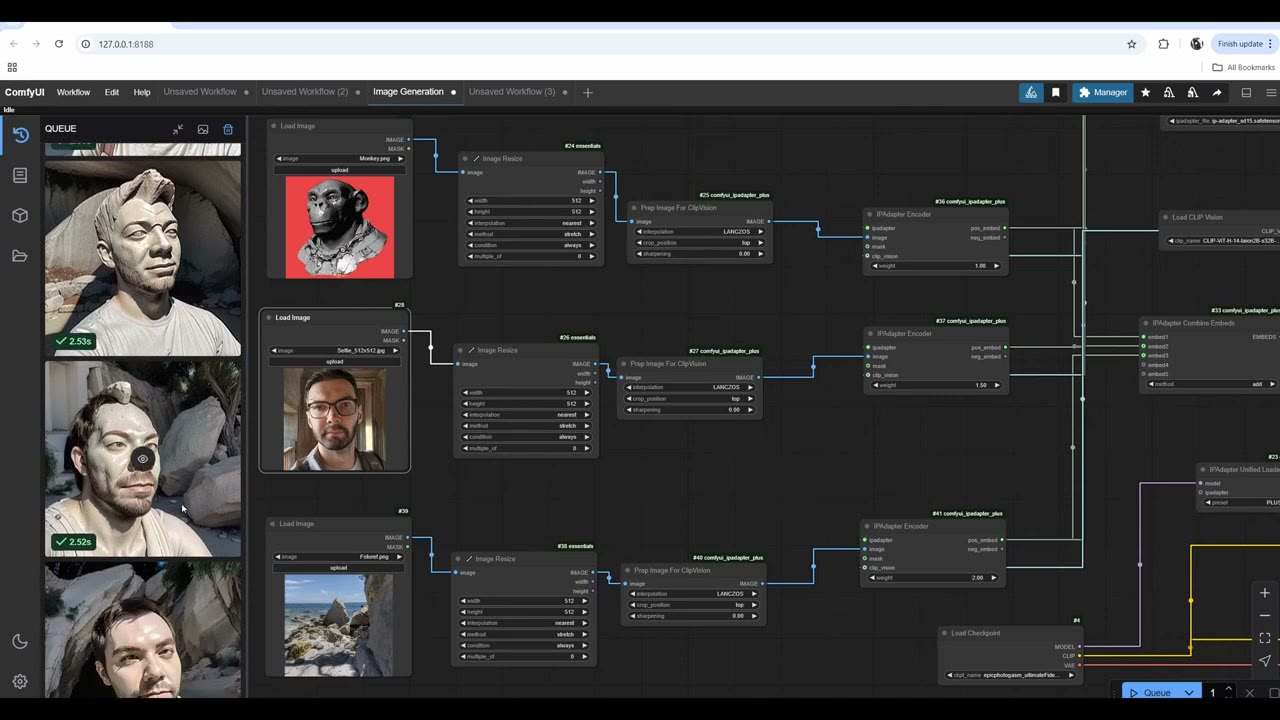
No todas las ejecuciones fueron buenas, pero me gustó lo que salió: las rocas del paisaje, mis gafas (ahora gafas de sol), la posición de tres cuartos del rostro del mono y una cabeza calva. Algunas ejecuciones adquirieron un aspecto de arcilla, que creo que viene más de los acantilados que del mono.
También probé el modelo DreamShaper, que dio un aspecto algo más estilizado. De todos modos, hay que ejecutar variaciones hasta obtener algo que te guste.
Siguientes pasos
Para centrar IPAdapter en una parte de la imagen, combínalo con una máscara; mira enmascarar cualquier cosa con Florence 2. Para refinar resultados como estos, mira el escalado gratuito con IA con SD 1.5. Para un estilo que el modelo aprenda de forma permanente, entrena un LoRA.
Ver la versión en vídeo (9:32)
Todo lo anterior también está en el vídeo, si prefieres seguirlo en pantalla. El vídeo está en inglés.
Preguntas frecuentes
¿Por qué IPAdapter ignora mi prompt?
Con peso 1,0 domina la imagen de referencia. Baja el peso: en esta prueba el prompt solo empezó a notarse con unos 0,55, y por debajo de 0,5 la referencia casi desaparecía. Cuando combinas varias imágenes con Combine Embeds, el prompt se ignora en gran medida.
¿Qué método de combinación debo usar para dos imágenes?
Concat pone las imágenes una tras otra y una suele dominar. Add (o average) las mezcla; en mi prueba también tomó la pose de la segunda imagen. Después equilíbralas con los pesos de los encoders.
¿Cuántas imágenes puede combinar IPAdapter?
Con tres sigue siendo controlable. Por encima de tres se complica.
¿Debo usar los modelos IPAdapter de SD 1.5 o de SDXL?
Existen modelos de SDXL, pero son más pesados y lentos. Para aprender y probar flujos, SD 1.5 es mucho más rápido y los resultados son buenos.

Anton Tenitsky es artista 3D con más de 15 años en gráficos por ordenador, que ha trabajado con Nickelodeon, Gameloft, Marvel Rivals y muchos otros clientes. Más sobre mí