Um prompt de texto descreve o que fazer. Uma imagem de referência pode descrever como deve ser o visual. O IPAdapter alimenta o modelo com uma imagem junto ao prompt, de modo que uma nova geração absorva o estilo, os materiais ou a pose dela. Aqui pego uma das minhas esculturas 3D antigas e transfiro o visual dela para um cachorro, depois combino duas e três imagens num só resultado.
O IPAdapter vem do artigo IP-Adapter: Text Compatible Image Prompt Adapter for Text-to-Image Diffusion Models (Ye et al., 2023). No ComfyUI ele é implementado pelo pacote de nós IPAdapter Plus, do Matteo (cubiq).
Em resumo
- Instalação: IPAdapter Plus, ComfyUI Essentials, um modelo CLIP Vision e o modelo de IPAdapter do SD 1.5, tudo pelo ComfyUI Manager.
- Uma imagem: IPAdapter Advanced entre o checkpoint e o KSampler, com um Unified Loader, CLIP Vision e a imagem redimensionada para 512 × 512.
- Weight: 1,0 copia a referência; cerca de 0,55 deixa o prompt entrar. Weak input impede que a referência sobrepuje o assunto.
- Várias imagens: um IPAdapter Encoder por imagem no Combine Embeds, método add, depois equilibre com os pesos dos encoders. Até três imagens continuam controláveis.
Se você é novo no ComfyUI, comece por noções básicas do ComfyUI e texto para imagem. O fluxo pronto é um download gratuito no meu Patreon; carregue-o e instale os nós que faltarem pelo Manager.
Instale os nós e os modelos
- Manager → Custom Nodes Manager, busque IPAdapter e instale o ComfyUI IPAdapter plus (do Matteo, versão 2). Escolha a versão mais recente e reinicie.
- Manager → Model Manager, busque CLIP Vision e instale o modelo CLIP-ViT-H-14. Algumas pessoas também recomendam um segundo modelo CLIP Vision listado logo abaixo; nunca funcionou para mim.
- No Custom Nodes Manager, instale o ComfyUI Essentials. Ele acrescenta nós que faltam no ComfyUI padrão, incluindo o Image Resize.
- No Model Manager, busque IPAdapter e instale o modelo IPAdapter for Stable Diffusion 1.5. Existem versões para o SDXL também, mas são mais pesadas e lentas. Enquanto você aprende e testa, o SD 1.5 é bem mais rápido e os resultados são bastante bons.
- Clique em Update All e atualize o ComfyUI, depois reinicie, para tudo ficar em dia.
Os arquivos de modelo do IPAdapter também estão no Hugging Face, se você preferir baixá-los à mão.
A configuração básica com uma imagem
Comece pelo template básico de geração de imagens. Uso o epiCPhotoGasm, um checkpoint SD 1.5.
- Adicione o IPAdapter Advanced. Este é o nó principal. A entrada model dele recebe o modelo do checkpoint, e a saída MODEL vai para o KSampler.
- A partir da entrada ipadapter dele, adicione um IPAdapter Model Loader e defina o modelo do SD 1.5 (não o modelo de rosto).
- A partir da entrada clip_vision dele, adicione o Load CLIP Vision com o modelo que você instalou. Isso é um pouco confuso, já que os prompts já passam por um codificador CLIP. Mas o IPAdapter precisa desse passo extra para converter a imagem numa forma que consiga usar; sem ele, não funciona.
- A partir da entrada image dele, adicione o Load Image. Usei uma escultura que fiz alguns anos atrás.
Aperte Ctrl+Enter para executar e Q para abrir o painel da fila com os resultados à esquerda.
Fazendo o prompt passar
Com o prompt «dog» e o weight em 1,0, nada aconteceu: o resultado foi só a escultura. O weight precisa baixar bastante. Abaixo de 0,5 ele só faz um cachorro; em torno de 0,55 você obtém a transferência. Mesmo assim levou algumas execuções. Pôr head, face, male, female no prompt negativo ajudou um pouco.
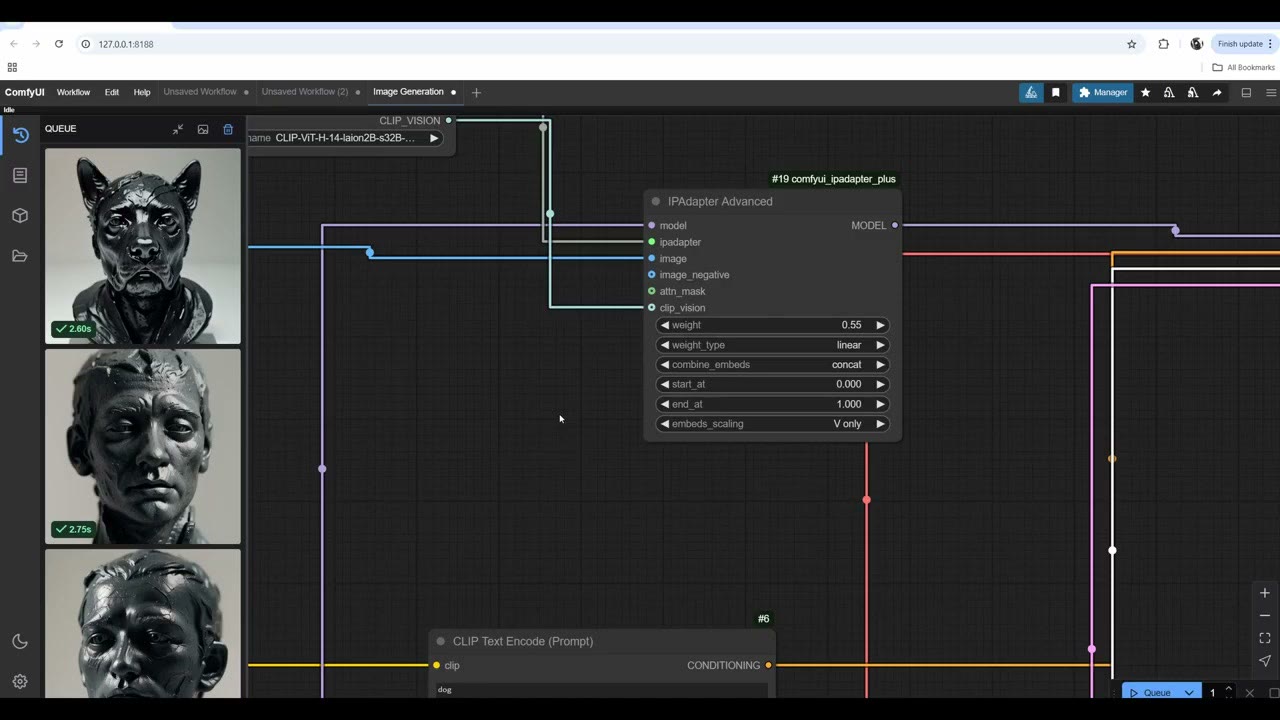
Weight type
- Linear aplica a referência de forma uniforme.
- Ease in pende para a imagem de referência: sobretudo o rosto esculpido.
- Ease out pende para o prompt: só um cachorro, sem nada da referência.
- Weak input / weak output são bastante autoexplicativos. Eu queria o weak input, para o rosto não sobrepujar o cachorro mas o visual e o estilo ainda se transferirem.
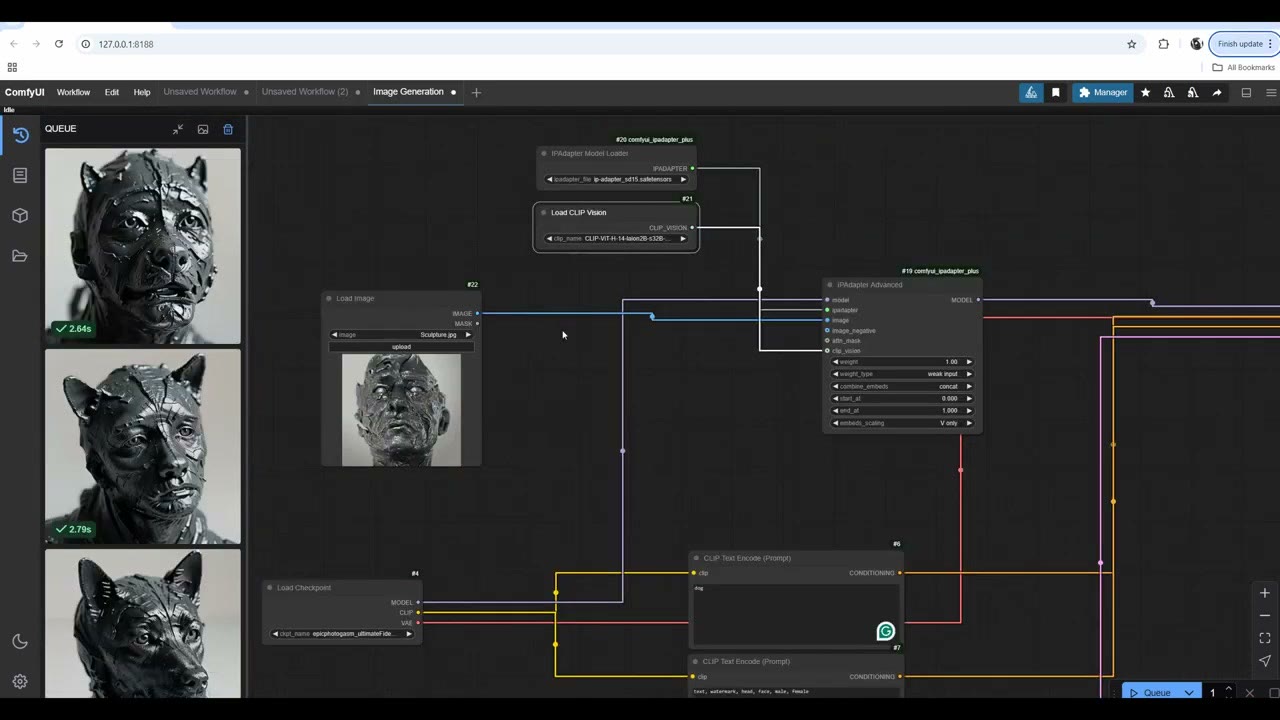
Nós de apoio
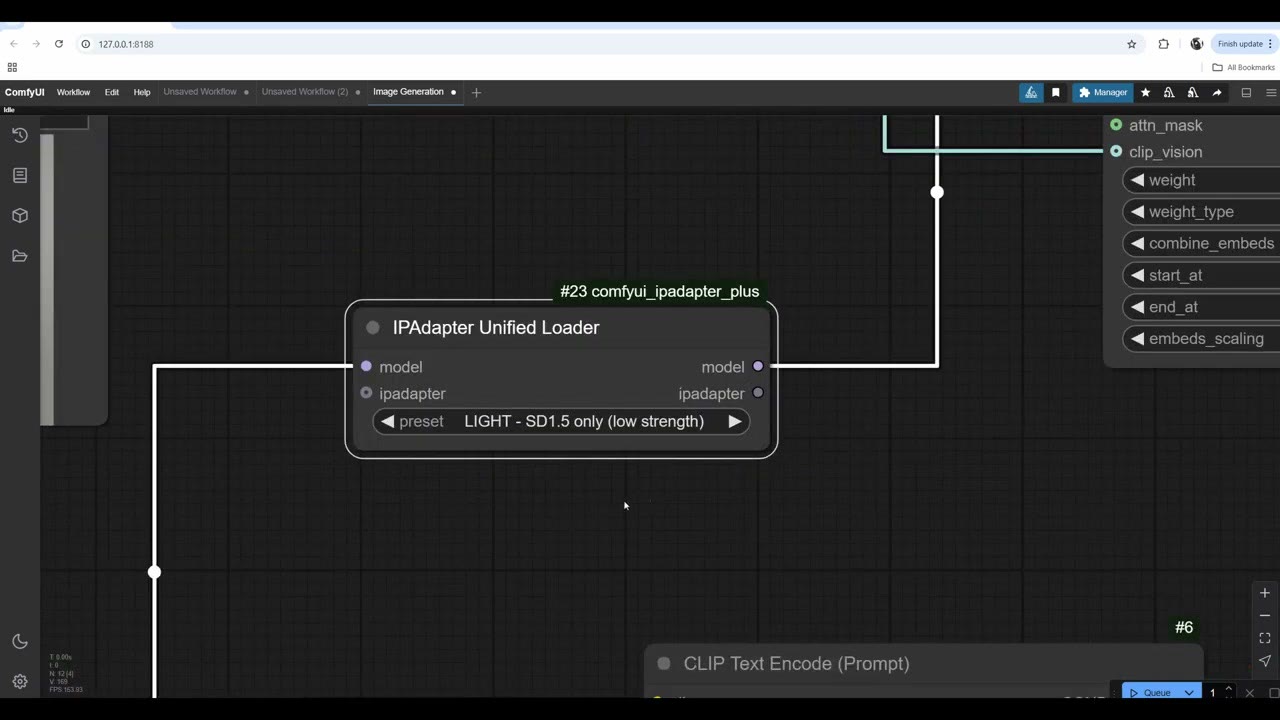
Três acréscimos deixam a configuração mais clara e dão melhores resultados:
- IPAdapter Unified Loader: ligue o modelo do checkpoint a ele, e as saídas dele às entradas model e ipadapter do IPAdapter Advanced. A lista de preset dele (por exemplo «LIGHT – SD1.5 only (low strength)») é mais fácil de entender do que escolher arquivos de modelo. Os presets produzem resultados diferentes; não sei dizer qual é melhor, e costumo usar forças baixas e fazer a maior parte do ajuste no nó Advanced.
- Image Resize (do Essentials): o SD 1.5 funciona melhor em 512 × 512.
- Prep Image for ClipVision: entre o redimensionamento e a entrada de imagem do IPAdapter. Prepara a imagem numa forma que o IPAdapter entende melhor.
Para resultados mais estilizados usei uma imagem que fiz há uns dez anos, com «biker» como prompt. Com weak input em weight 0,55 obtive um visual legal de escultura 3D em preto e branco. Em weight 1, linear, os resultados ficaram realmente estilizados. Há muito para mudar aqui; teste, de novo e de novo, e você vai construir uma intuição de como o IPAdapter se comporta.
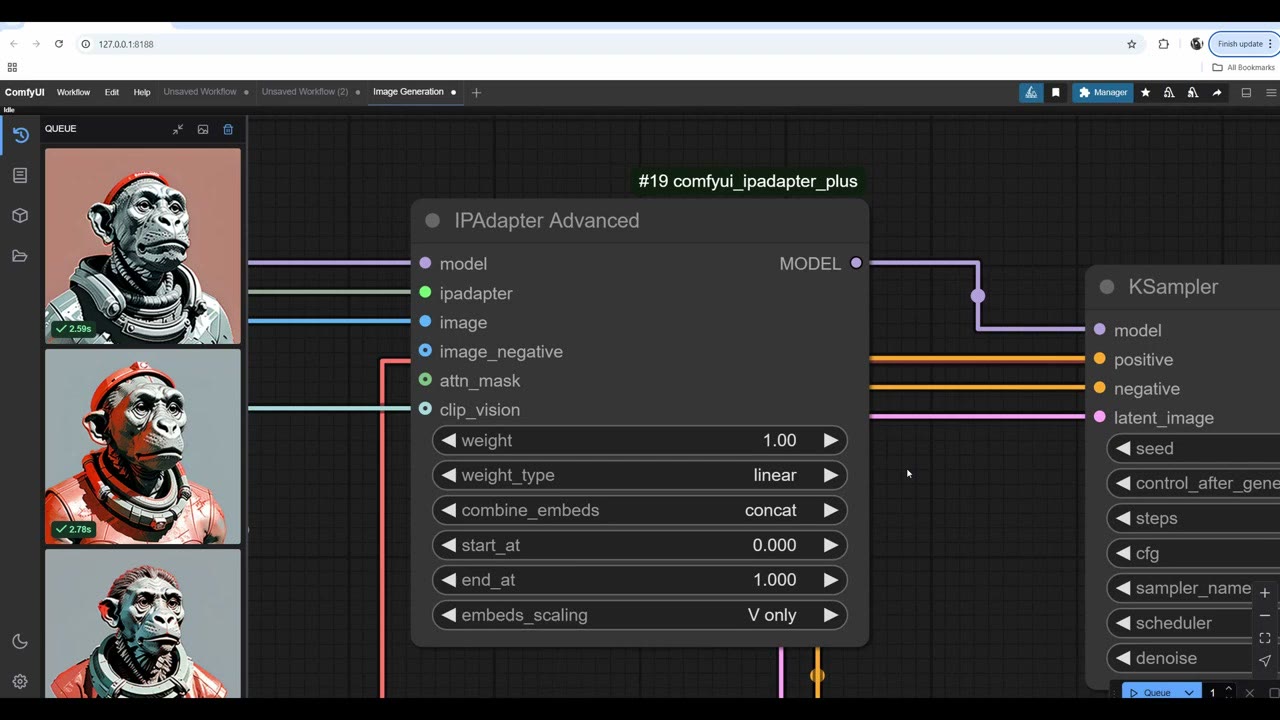
Combinando duas imagens
Esta é a minha forma favorita de usar o IPAdapter. Copie o ramo da imagem (Ctrl+C, depois Ctrl+Shift+V para colar com as conexões) e carregue uma segunda imagem; usei uma selfie. Depois:
- Troque o IPAdapter Advanced por IPAdapter Embeds, e reconecte o modelo e a saída dele.
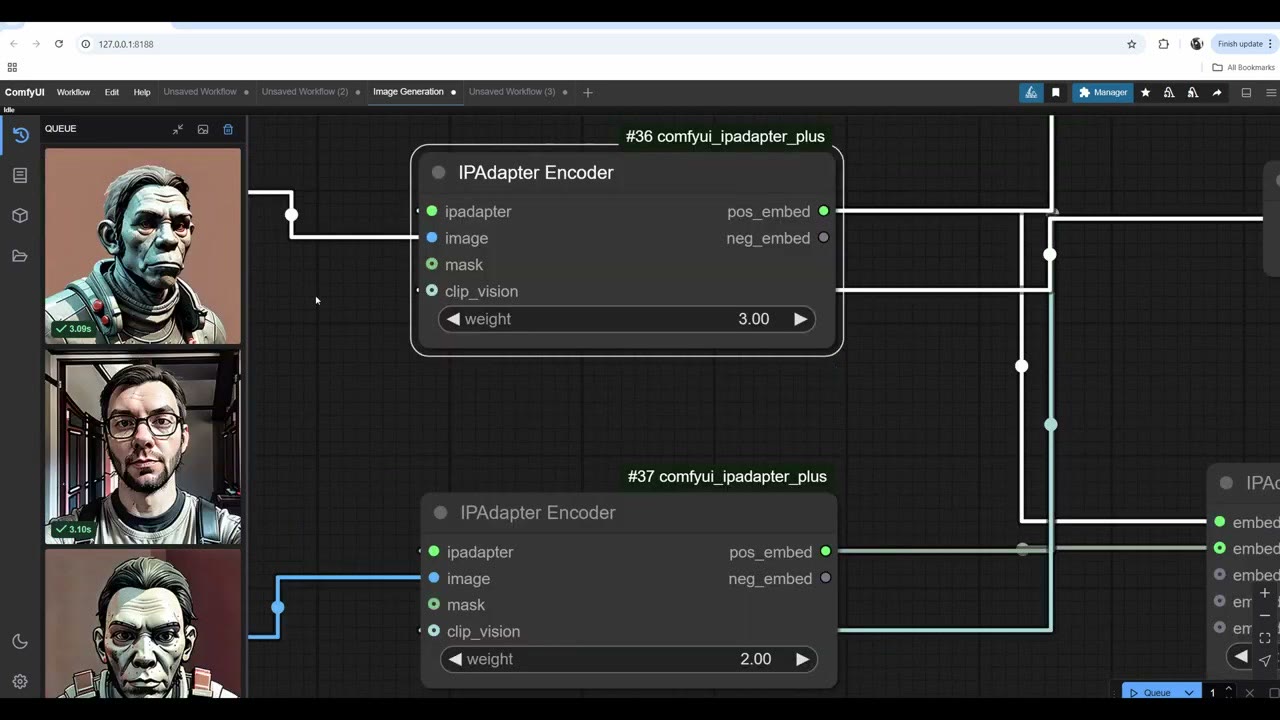
- Adicione um IPAdapter Encoder para cada imagem. Conecte as entradas ipadapter e clip_vision de cada encoder; é fácil esquecê-las.
- Adicione o IPAdapter Combine Embeds. O pos_embed de cada encoder vai para embed1, embed2 e assim por diante, e os EMBEDS combinados vão para a entrada positive do nó Embeds.
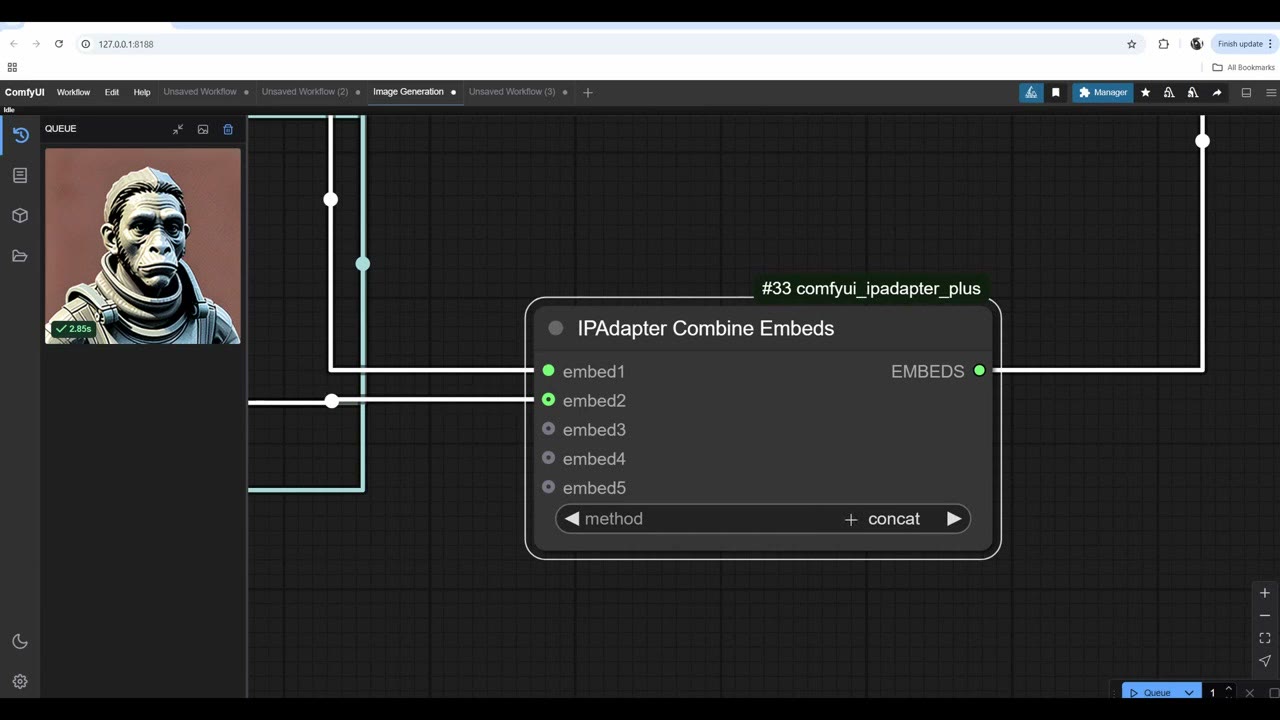
O método importa. Com o concat, que põe uma imagem depois da outra, obtive sobretudo macaco e pouco de mim. O add faz a média (o average faz algo parecido), e o macaco ganhou mais traços humanos. Com o add ele também pegou a minha pose: eu estava de frente e o macaco olhava de lado, e o resultado copiou a minha pose aplicando o estilo e o cabelo do macaco.
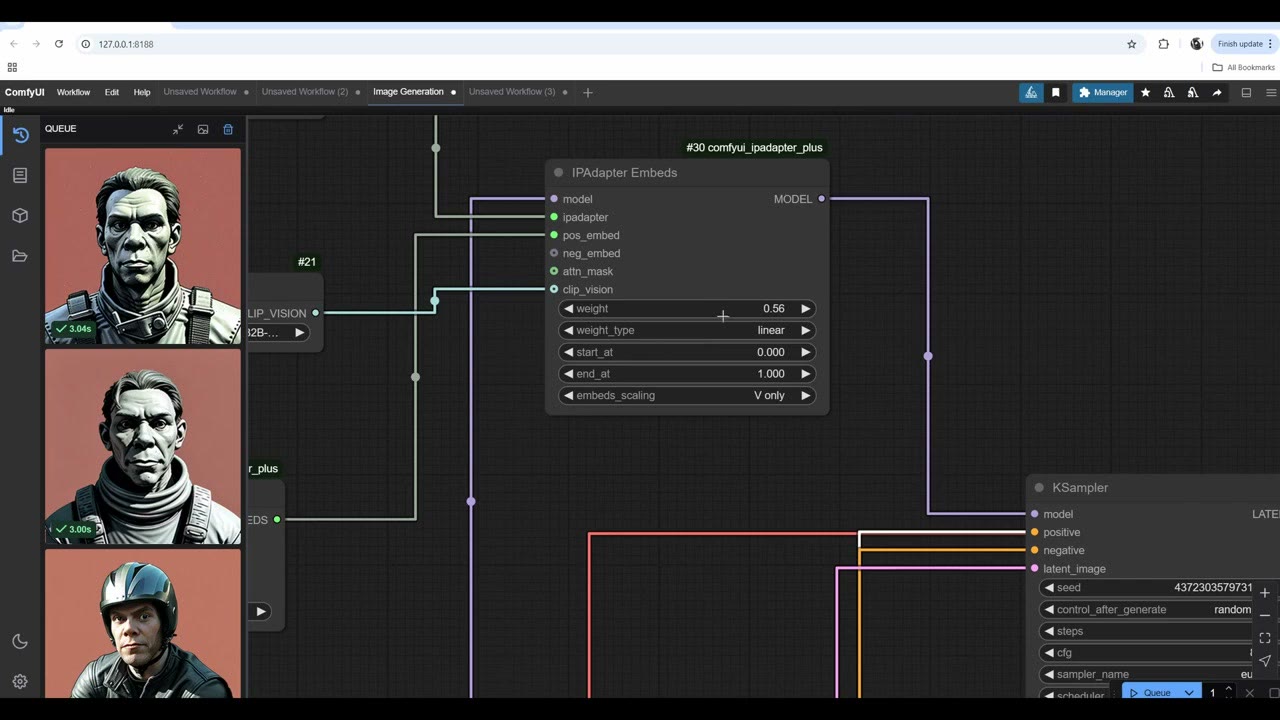
Equilibre com os pesos dos encoders. Defina o encoder do meu rosto em 2 e ele assume. Defina o do macaco em 3 e o macaco fica mais forte e também assume a pose, virando para uma vista de três quartos.
Nessa etapa o prompt («biker») foi completamente ignorado; só contaram as imagens embutidas. Reduzir o weight do IPAdapter trouxe de volta um motoqueiro com fundo vermelho e alguma roupa de motoqueiro, mas nada a ver com nenhuma das imagens. Isso fica imprevisível e difícil de controlar. Prefiro não usar prompt nenhum e deixar as imagens serem os trilhos de orientação; os resultados são mais previsíveis.
Combinando três imagens
Três imagens ainda podem ser combinadas e controladas; acima de três fica complicado. Minha terceira imagem foi um recorte do pacote de fotos white marine cliffs and sand da Fotoref, da qual sou cofundador.
- Recorte a referência num quadrado, 512 × 512. Uma imagem retangular é esmagada pelo redimensionamento, o que leva um efeito feio ao resultado.
- Conecte o positive embed, o ipadapter e o clip_vision do encoder dela.
- Usei pesos de encoder de 1, 1,5 e 2.
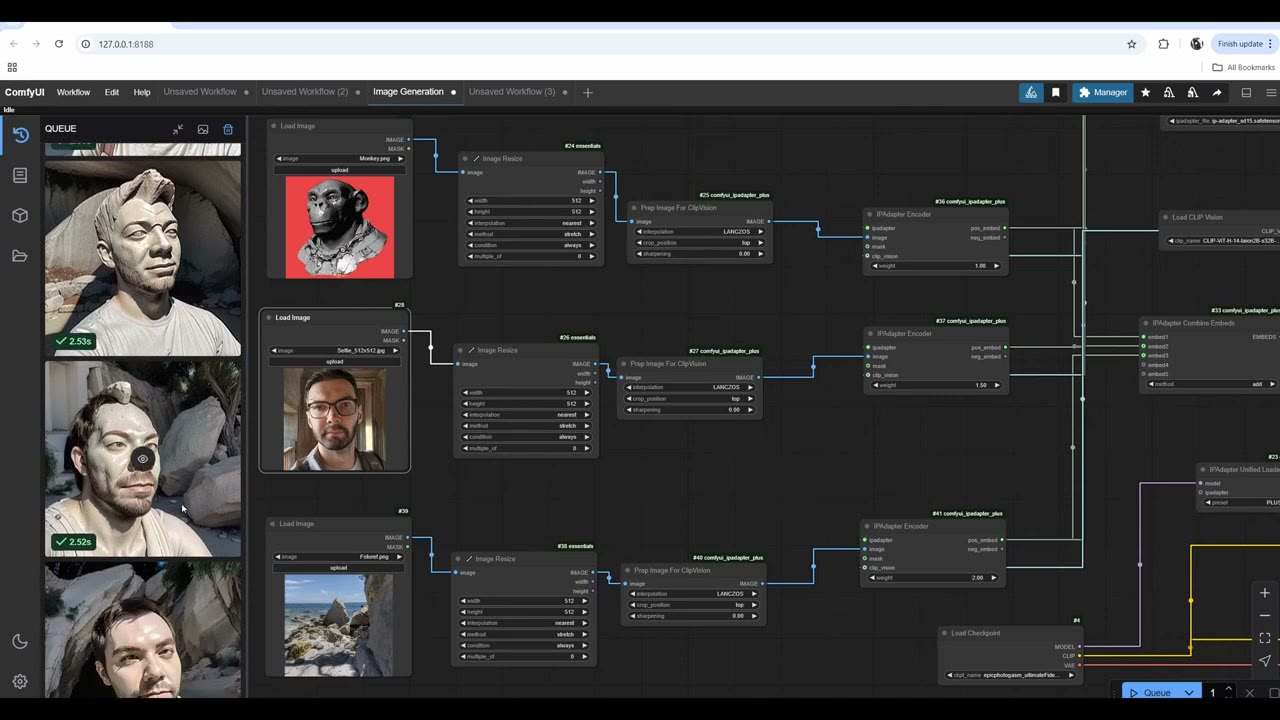
Nem toda execução foi boa, mas gostei do que passou: rochas da paisagem, meus óculos (agora óculos de sol), a posição de rosto de três quartos do macaco e uma cabeça calva. Algumas execuções ganharam um visual de argila, que acho que vem mais dos penhascos do que do macaco.
Também testei o modelo DreamShaper, que deu um visual um pouco mais estilizado. De qualquer forma, você precisa rodar variações até obter algo de que goste.
Próximos passos
Para concentrar o IPAdapter numa parte da imagem, combine-o com uma máscara; veja mascarando qualquer coisa com o Florence 2. Para dar nitidez a resultados como estes, veja upscaling de IA gratuito com o SD 1.5. Para um estilo que o modelo aprende de forma permanente, treine um LoRA.
Assista à versão em vídeo (9:32)
Tudo o que está acima também está no vídeo, se você preferir acompanhar na tela. O vídeo está em inglês.
Perguntas frequentes
Por que o IPAdapter ignora o meu prompt?
Com weight 1,0 a imagem de referência domina. Reduza o weight: neste teste o prompt só começou a aparecer em cerca de 0,55, e abaixo de 0,5 a referência quase sumia. Quando você combina várias imagens com o Combine Embeds, o prompt é em grande parte ignorado.
Que método de combinação devo usar para duas imagens?
O Concat põe as imagens uma depois da outra e uma tende a dominar. O Add (ou average) as mistura; no meu teste ele também pegou a pose da segunda imagem. Depois equilibre-as com os pesos dos encoders.
Quantas imagens o IPAdapter pode combinar?
Três ainda são controláveis. Acima de três fica complicado.
Devo usar os modelos de IPAdapter do SD 1.5 ou do SDXL?
Existem modelos para o SDXL, mas são mais pesados e lentos. Para aprender e testar fluxos, o SD 1.5 é bem mais rápido e os resultados são bons.

Anton Tenitsky é artista 3D com mais de 15 anos em computação gráfica, que trabalhou com Nickelodeon, Gameloft, Marvel Rivals e muitos outros clientes. Mais sobre mim