Um prompt sozinho dá pouco controle sobre pose e composição. Uma cena 3D dá todo. Neste fluxo, posiciono um personagem no Blender, monto uma cena grosseira com caixas e deixo o Flux renderizá-la no estilo de um artista específico, aqui as gravuras de Albrecht Dürer, por meio de um LoRA de estilo.
O estilo vem de um LoRA que treinei com cerca de dez gravuras de Dürer. O treinamento é coberto passo a passo em como treinar um LoRA no estilo de qualquer artista, então este guia começa onde aquele termina: com um arquivo de LoRA treinado.
Em resumo
- Pose: um personagem e uma animação gratuitos do Mixamo, importados no Blender.
- Cena: cubos, esferas e cilindros, renderizados com o Eevee.
- Estrutura: um mapa de profundidade do Depth Anything V2 conduz o Flux depth ControlNet v3, com força de cerca de 0,7.
- Estilo: um LoRA do Flux treinado na obra de um artista, com sua trigger word no início do prompt.
- Qualidade: Flux 1 dev, guidance 3, 25 steps.
1. Pegue um personagem posicionado no Mixamo
O Mixamo é uma biblioteca gratuita da Adobe de personagens e animações. Escolha um personagem e depois busque nas animações uma pose que combine com a sua ideia. Busquei «sword» e usei Great Sword Crouching Block; qualquer quadro de uma animação pode ser a sua pose.
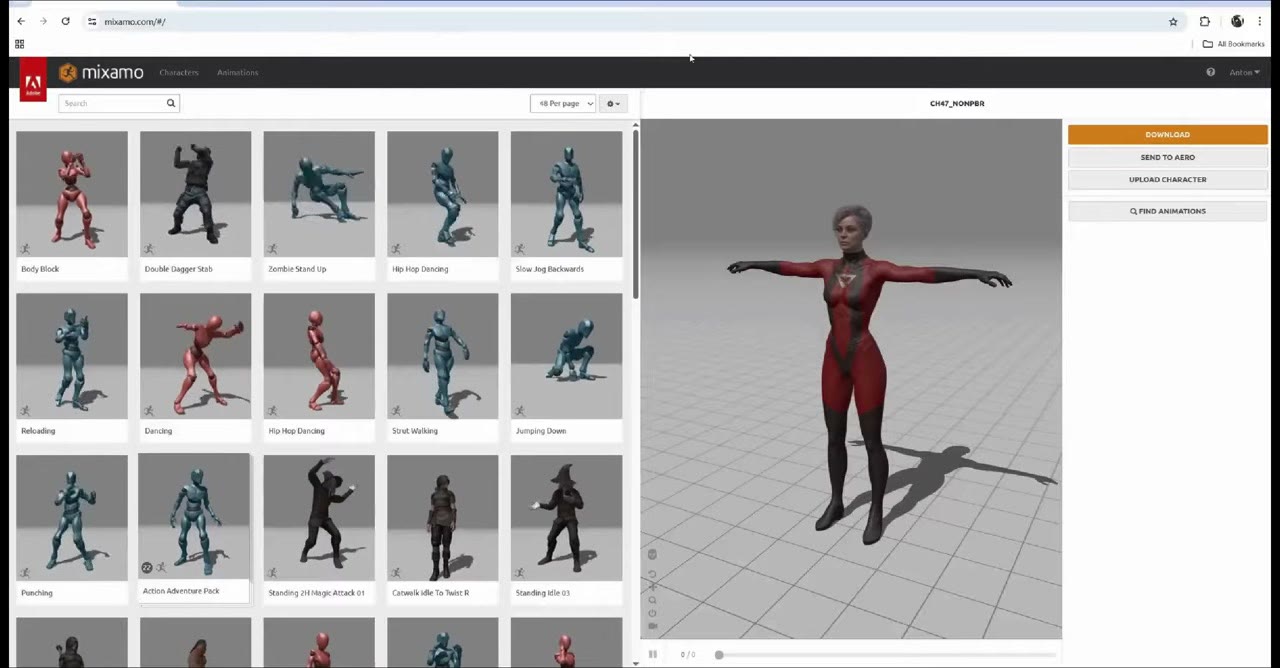
O personagem não precisa ter boa anatomia. Os ControlNets de profundidade funcionam com formas bem grosseiras, até bonecos de palitos. Baixe a animação como FBX com as configurações padrão (a minha tinha cerca de 50 MB).
Uma nota de licenciamento: para os personagens que vendo, fiz e preparei o rig dos meus próprios, porque não posso usar os personagens do Mixamo comercialmente num pacote. Para posicionar seus próprios renders, o Mixamo é o começo mais fácil.
2. Monte a cena no Blender
No Blender, use File → Import → FBX, esconda o armature e percorra a linha do tempo para achar o quadro e o ângulo que quer.
Depois monte a cena com primitivas. Adicionei um cilindro como sabre de luz (é uma pose estática, então não precisa de parentesco) e fiz uma cidade inteira de caixas: duplicadas muitas vezes, esticadas e espalhadas. Posicione a câmera, adicione uma luz e renderize com o Eevee, com ray tracing ligado.
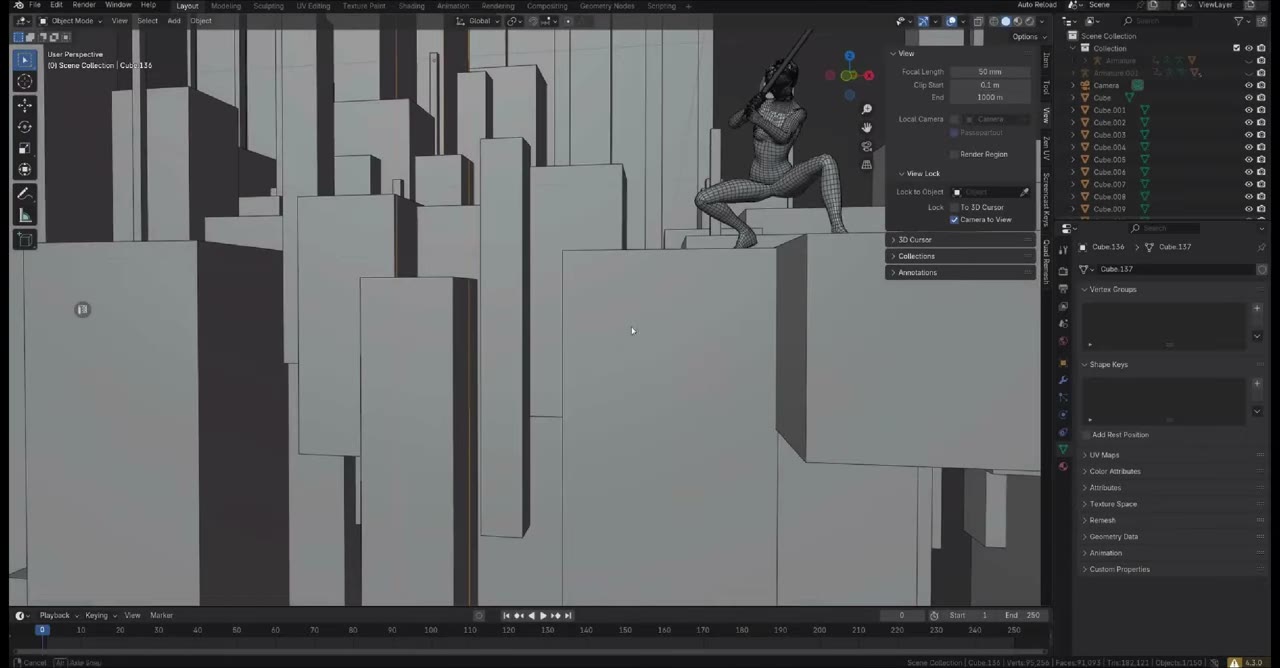
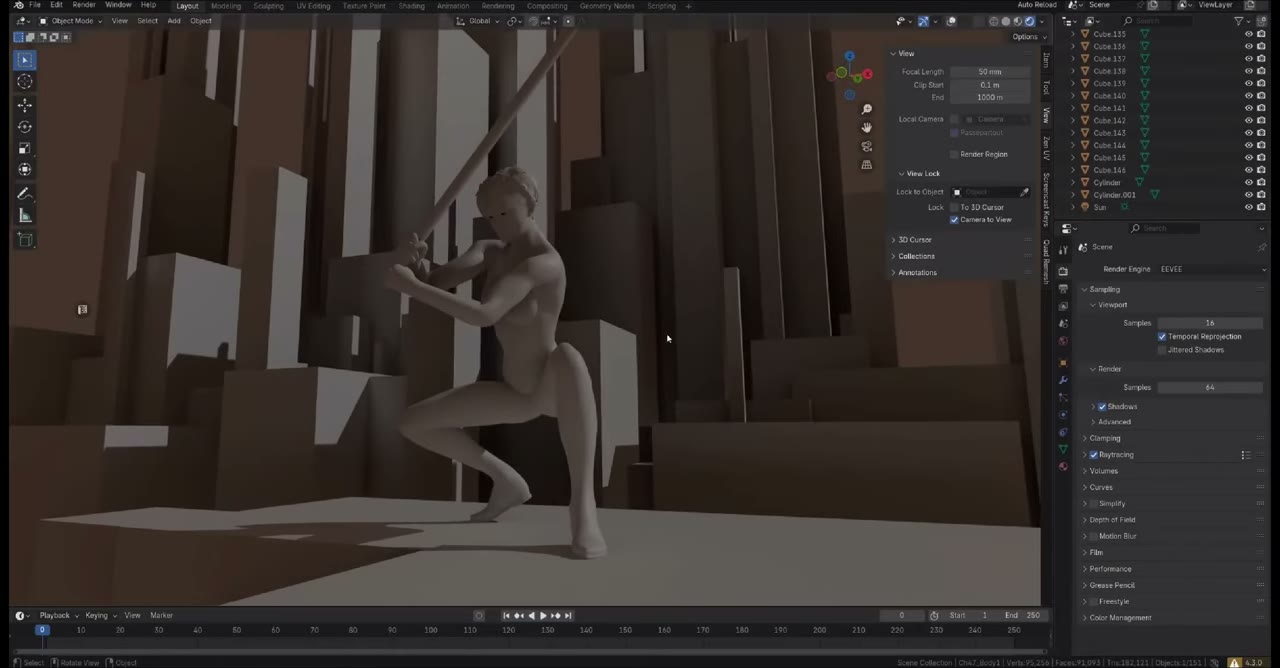
A anatomia na minha pose é feia, com deformações estranhas e as clássicas «mãos de IA». Não importa: com a força certa de ControlNet, a IA a reconstrói.
3. O fluxo do ComfyUI
Você vai precisar destes custom nodes, todos pelo ComfyUI Manager: comfyui_controlnet_aux (Depth Anything), x-flux-comfyui (ControlNet e sampler do Flux), KJNodes (nós Set/Get), rgthree (image comparer) e o WAS Node Suite (Image Save). O fluxo pronto, com meus três LoRAs de artistas, está no meu Patreon.
Carregue e redimensione o render
Um nó Load Image traz o seu render do Blender. Uso renders quadrados: em 1024 × 1024, o Flux dá resultados muito bons de forma confiável. Uma nota no fluxo lista outras boas resoluções para o Flux.
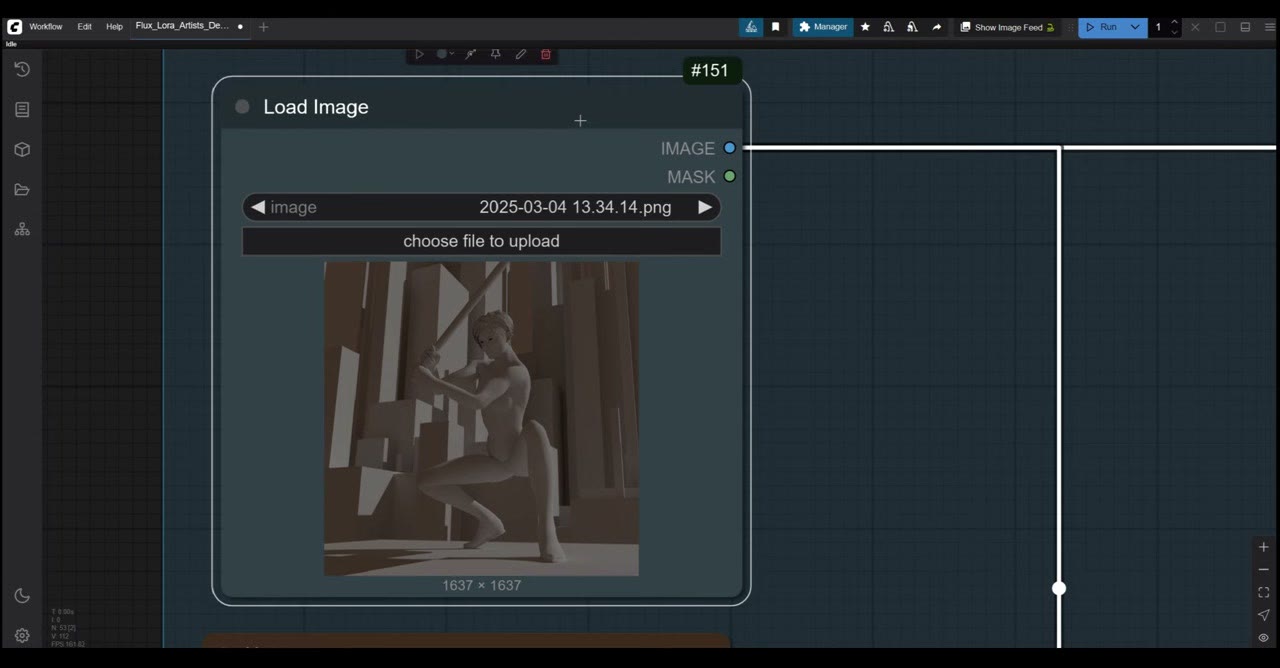
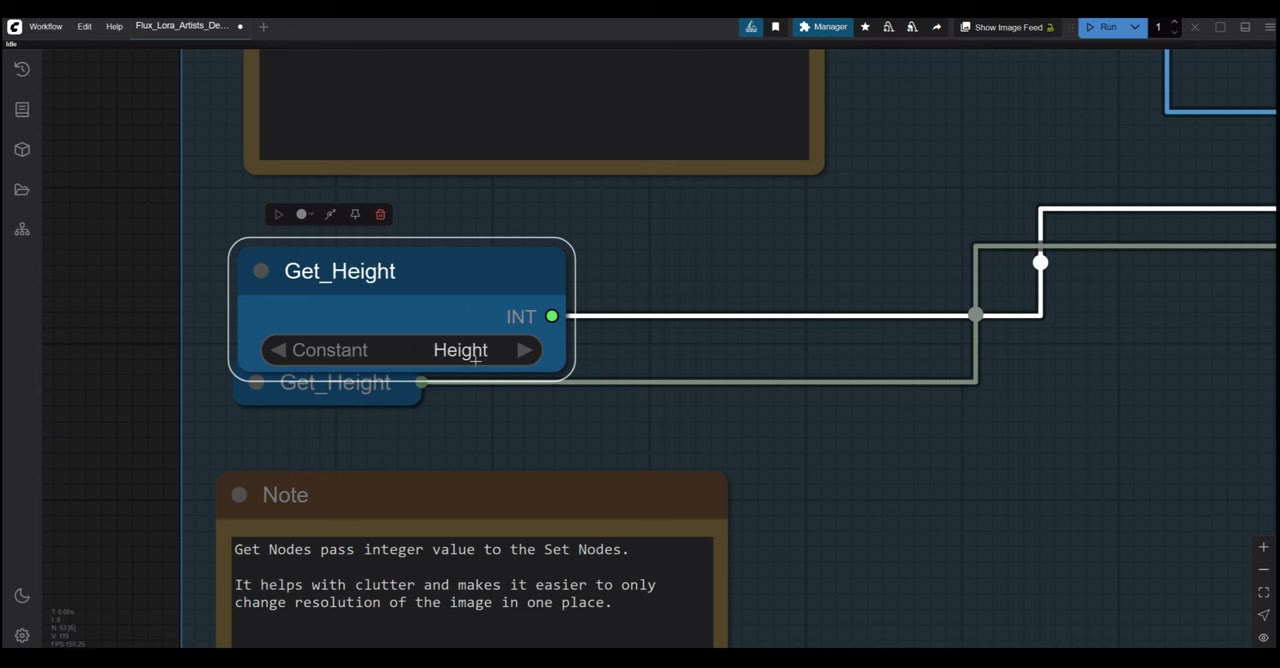
Um truque organizado: nós Set e Get. A resolução é necessária em vários lugares. Em vez de digitá-la em todo lado ou passar fios longos pelo grafo, coloco a largura e a altura em nós de inteiros, guardo-as com nós Set (chamados width e height) e as leio em qualquer lugar com nós Get. Mude o tamanho uma vez, no começo, e todo nó que o usa se atualiza.
Mapa de profundidade e ControlNet
O render redimensionado passa pelo Depth Anything V2. Uso o maior modelo para a melhor qualidade; existem menores se você estiver curto de memória, embora o Flux precise bastante de qualquer jeito. A resolução dele também vem do nó Get.
O mapa de profundidade entra no Apply Flux ControlNet com o Flux depth ControlNet v3 (do Model Manager). A força é o ajuste que importa:
- Perto de 1,0: o resultado fica muito feio.
- Abaixo de 0,5: criativo demais; perde sua pose.
- De 0,6 a 0,9 é a faixa útil. Eu uso 0,7, porque deixa ao Flux liberdade suficiente para corrigir a anatomia.
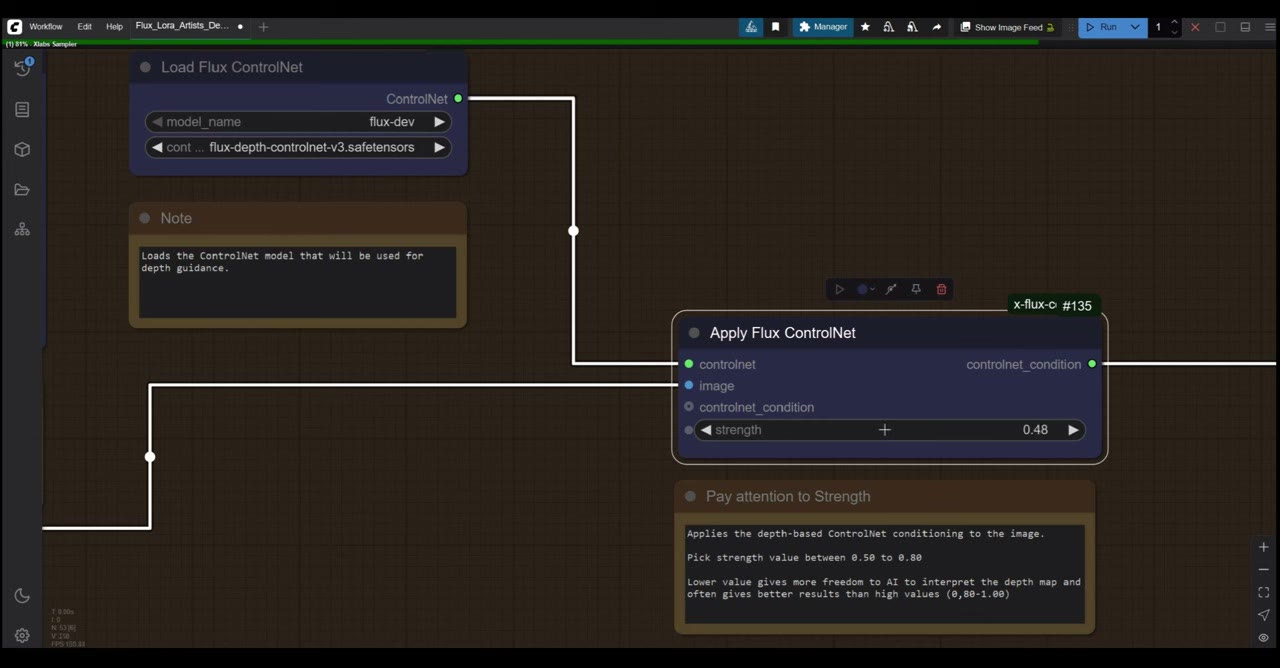
Essa liberdade é o ponto. Posicionei um personagem feminino do Mixamo, e o resultado é uma figura masculina de armadura completa, com anatomia convincente.
Modelo e LoRA
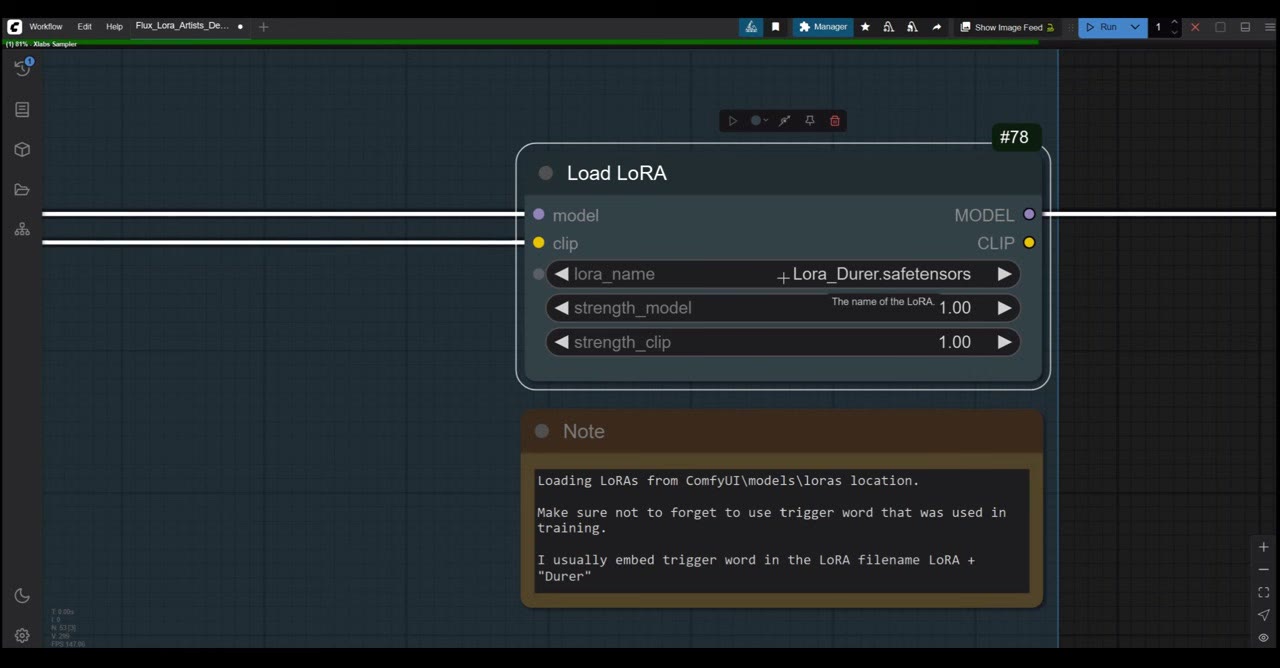
O Load Diffusion Model carrega o Flux 1 dev (cerca de 12 GB; o download pelo Model Manager congela o ComfyUI até terminar). Ele alimenta um nó Load LoRA com o LoRA de estilo, aqui o meu LoRA de Dürer, que ajusta os pesos do modelo em direção a esse visual. Deixo a força do LoRA no máximo; reduza se quiser só um toque do estilo.
O Empty Latent Image recebe a mesma largura e altura dos nós Get.
Prompt
O DualCLIPLoader carrega os dois codificadores de texto do Flux, CLIP-L e T5 XXL (ambos no Model Manager). Eles transformam cada parte do seu prompt numa direção para a imagem.
Comece o prompt positivo com a trigger word do seu LoRA e depois acrescente contexto. O Flux foi projetado para prompts em linguagem natural e na prática não usa prompts negativos, então descreva o que quer, e não o que não quer. Flux Guidance em 3; muito mais alto e a imagem queima, com contraste duro.
Amostragem, decodificação, comparação e salvamento
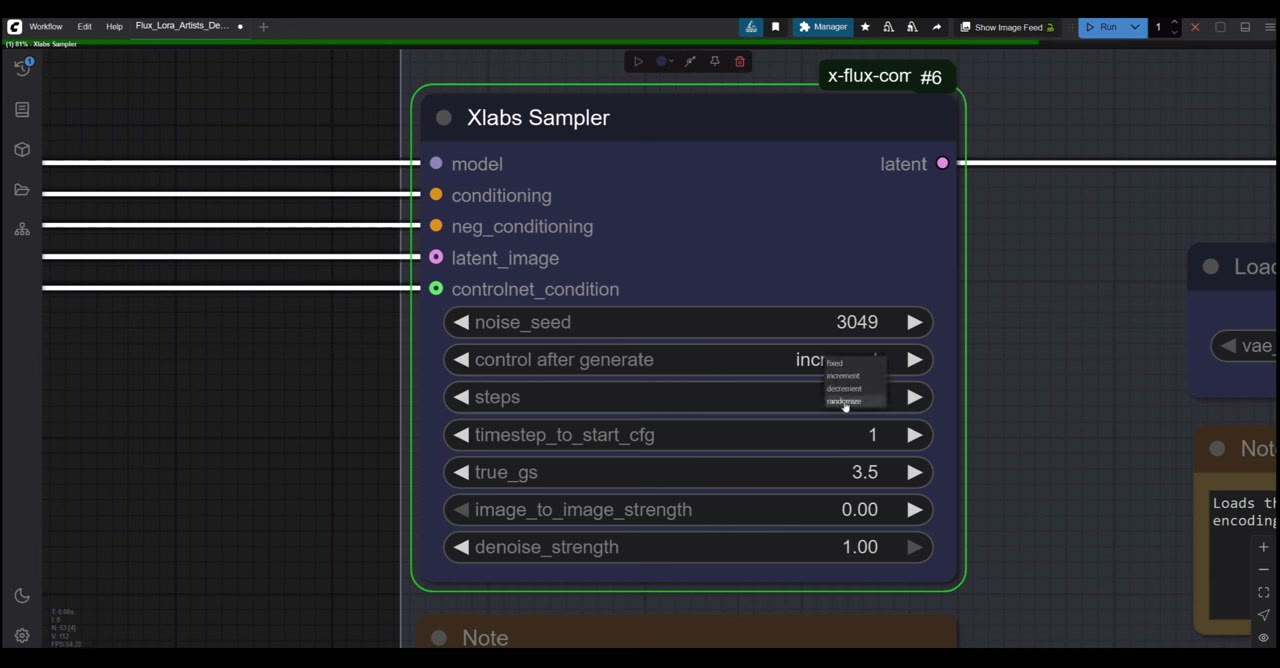
O XLabs Sampler reúne tudo: modelo, prompts, latente e ControlNet.
- Seed em increment, para as imagens serem numeradas em ordem e você poder reproduzir qualquer uma reutilizando sua seed e seus ajustes.
- Steps: 25. Há quem chegue a 50, mas obtenho bons resultados com 25; mais que isso é exagero.
O VAE Decode, com o VAE do Flux (cerca de 300 MB), converte o resultado em pixels. Um rgthree image comparer mostra o render do Blender e o resultado lado a lado, e um nó Image Save do WAS grava o arquivo com sua pasta e prefixo.
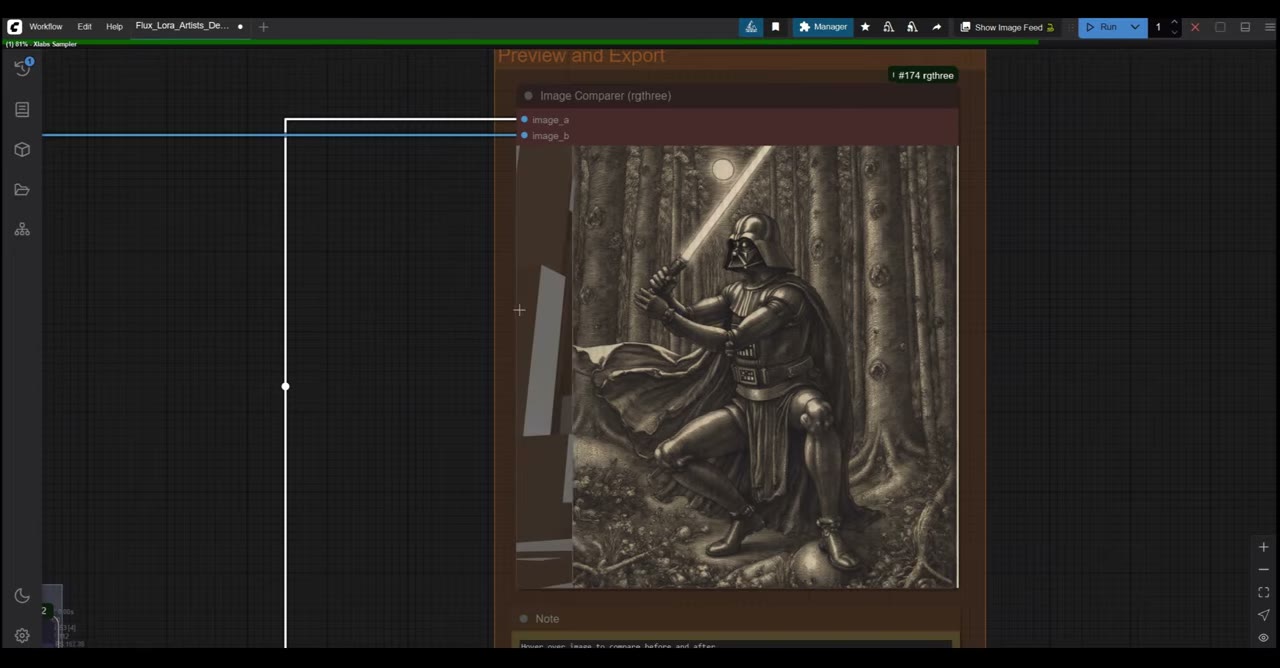
As mãos saíram decentes. Rode dez vezes e você terá uma quase perfeita.
Solução de problemas
Se uma execução travar (a minha parou em 81% ao calcular o mapa de profundidade), reinicie o ComfyUI. Tenho 24 GB de VRAM, e nem isso sempre basta quando outros programas estão usando a placa. Se sua GPU for menor, alugar uma é o caminho mais fácil; minha introdução ao RunPod explica como.
Se você experimentar o RunPod, meu link de indicação dá a novas contas que se cadastram com o Google de US$ 5 a US$ 500 em crédito após seus primeiros US$ 10, e eu recebo uma pequena comissão.
Assista à versão em vídeo (21:40)
Tudo o que está acima também está no vídeo, se você preferir acompanhar na tela. O vídeo está em inglês.
Perguntas frequentes
Preciso de um modelo 3D detalhado para isso?
Não. Um ControlNet de profundidade funciona com geometria bem grosseira; até bonecos de palitos podem servir. Minha cena foi feita com cubos, esferas e cilindros em volta de um personagem gratuito do Mixamo.
Que força de ControlNet devo usar?
Entre 0,6 e 0,9. Normalmente uso 0,7: mantém a pose e a composição, mas dá ao Flux liberdade suficiente para corrigir uma anatomia ruim.
A IA pode mudar o corpo do personagem?
Sim, se a força do ControlNet deixar espaço. Posicionei um personagem feminino do Mixamo e o resultado é uma figura masculina de armadura, com a anatomia corrigida.

Anton Tenitsky é artista 3D com mais de 15 anos em computação gráfica, que trabalhou com Nickelodeon, Gameloft, Marvel Rivals e muitos outros clientes. Mais sobre mim