プロンプトだけでは、ポーズと構図をほとんど制御できません。3Dシーンなら、すべてを制御できます。このワークフローでは、Blenderでキャラクターにポーズを付け、箱で大まかなシーンを組み、スタイルLoRAを通してFluxに特定のアーティスト(ここではアルブレヒト・デューラーの版画)のスタイルでレンダリングさせます。
スタイルは、デューラーの版画約10点で学習したLoRAから来ています。学習の手順は任意のアーティストのスタイルでLoRAを学習する方法で詳しく説明しているので、このガイドは、そこが終わるところ、つまり学習済みのLoRAファイルがある状態から始めます。
ポイント
- ポーズ: Mixamoの無料のキャラクターとアニメーションを、Blenderにインポート。
- シーン: キューブ、球、円柱をEeveeでレンダリング。
- 構造: Depth Anything V2の深度マップがFlux depth ControlNet v3を動かし、強度は約0.7。
- スタイル: アーティストの作品で学習したFlux LoRA。トリガーワードをプロンプトの先頭に置きます。
- 品質: Flux 1 dev、guidance 3、25ステップ。
1. Mixamoからポーズ付きキャラクターを入手する
Mixamoは、Adobeが提供する、キャラクターとアニメーションの無料ライブラリです。キャラクターを選び、アイデアに合うポーズをアニメーションから検索します。私は「sword」で検索してGreat Sword Crouching Blockを使いました。アニメーションのどのフレームでもポーズにできます。
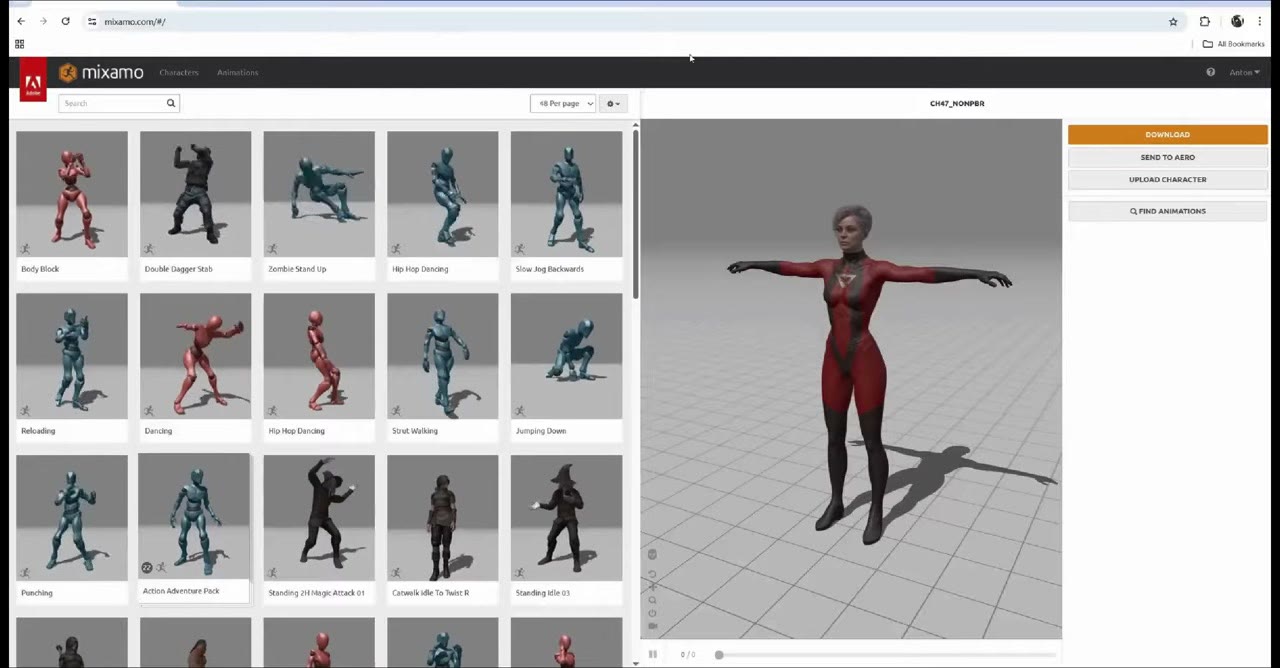
キャラクターの解剖学が良い必要はありません。深度ControlNetは、棒人間でも機能するほど粗い形で動きます。アニメーションは、デフォルト設定のFBXでダウンロードします(私のものは約50MBでした)。
ライセンスに関する注意:販売しているキャラクターについては、パッケージでMixamoのキャラクターを商用利用できないので、自分で作ってリギングしました。自分のレンダリングのポーズ付けには、Mixamoが最も手軽な出発点です。
2. Blenderでシーンを作る
BlenderでFile → Import → FBXを使い、アーマチュアを非表示にして、タイムラインを動かし、欲しいフレームと角度を探します。
その後、プリミティブでシーンを作ります。ライトセーバーとして円柱を追加し(静止ポーズなのでペアレントは不要)、都市全体を箱で作りました。箱を何度も複製して、引き伸ばして散らします。カメラを置き、ライトを追加して、レイトレーシングをオンにしたEeveeでレンダリングします。
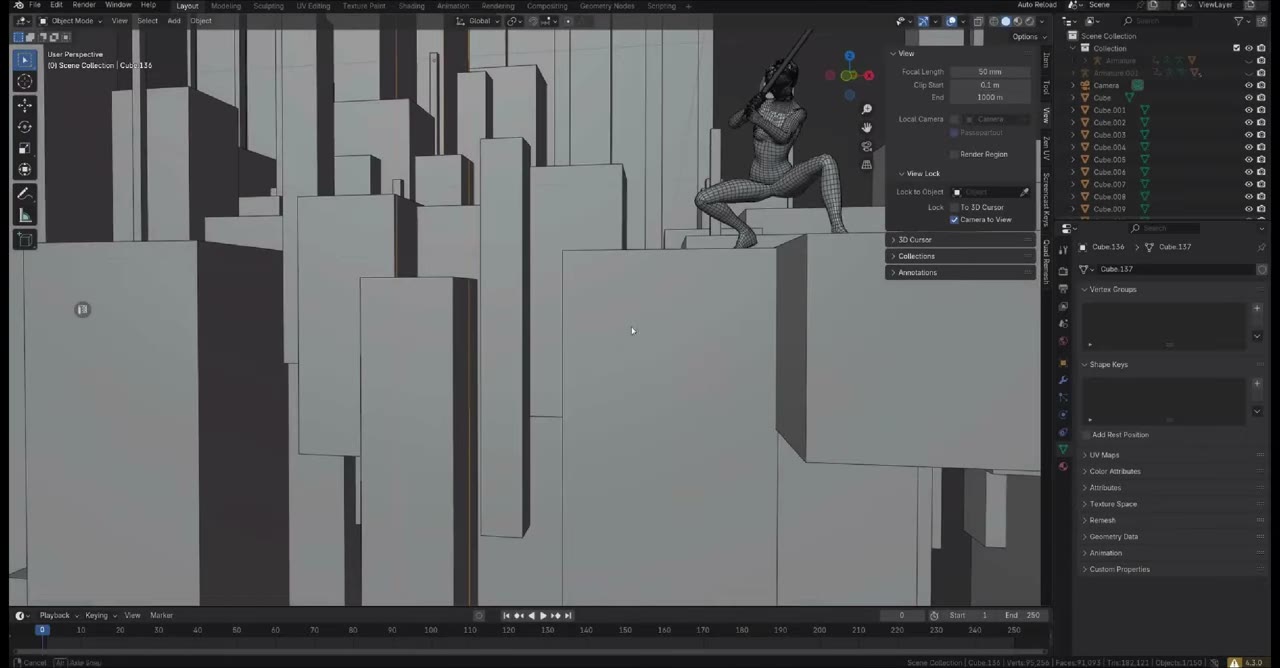
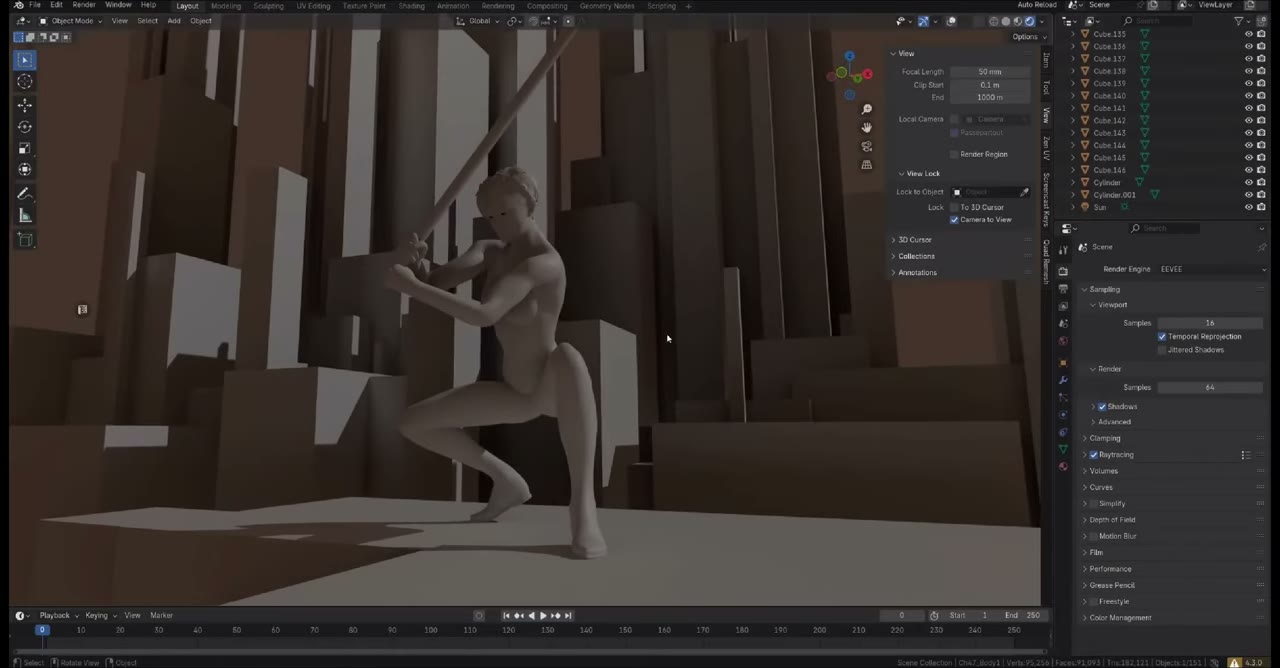
私のポーズの解剖学は醜く、奇妙な変形とお決まりの「AIの手」があります。それでも問題ありません。ControlNetの強度が適切なら、AIが作り直します。
3. ComfyUIのワークフロー
次のカスタムノードが必要で、すべてComfyUI Managerから入ります。comfyui_controlnet_aux(Depth Anything)、x-flux-comfyui(FluxのControlNetとサンプラー)、KJNodes(Set/Getノード)、rgthree(image comparer)、WAS Node Suite(Image Save)です。私の3つのアーティストLoRAを含む完成したワークフローは、私のPatreonにあります。
レンダリングを読み込んでリサイズする
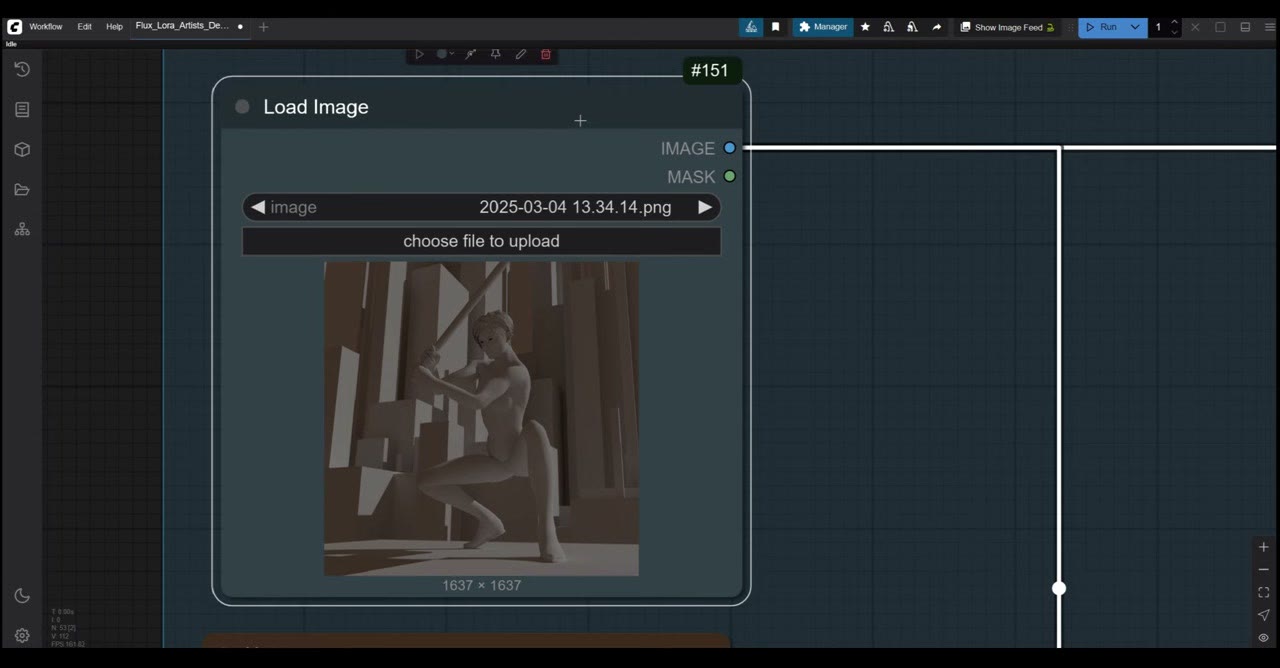
Load Imageノードに、Blenderのレンダリングを読み込みます。私は正方形のレンダリングを使います。1024 × 1024なら、Fluxは安定して非常に良い結果を出します。ワークフロー内のノートに、Fluxで良好な他の解像度が載っています。
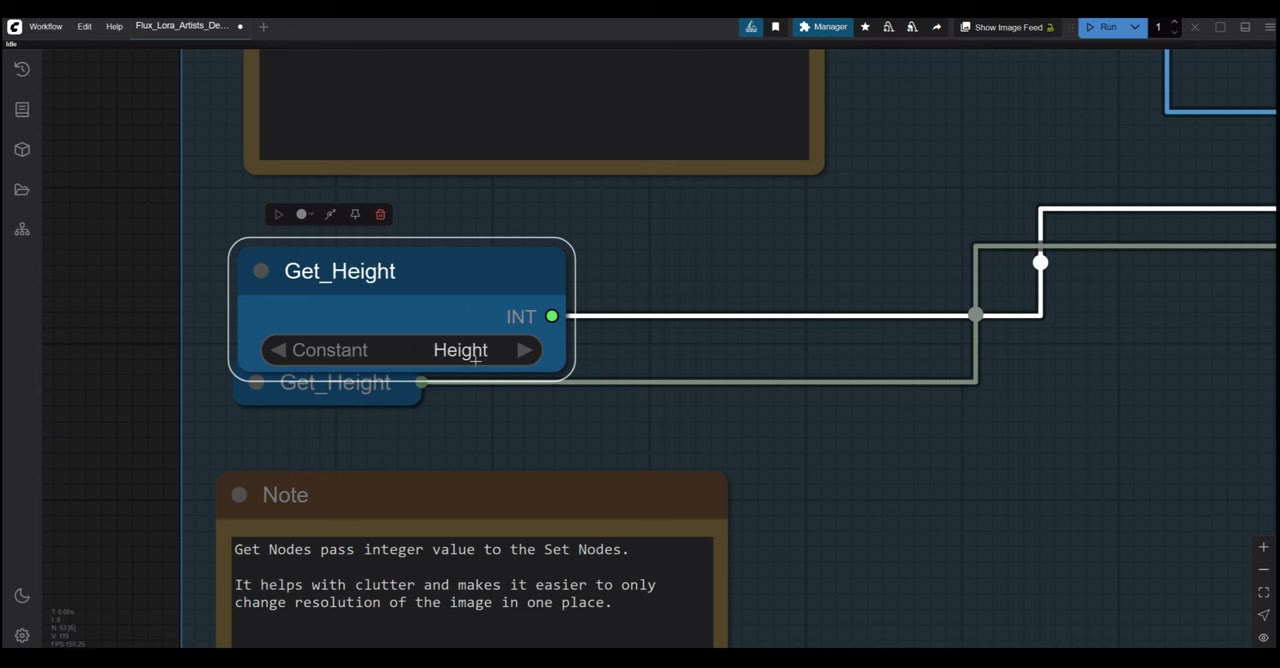
便利なコツ:SetノードとGetノード。 解像度は、いくつもの場所で必要になります。あちこちに入力したり、グラフを横切る長い線を引いたりする代わりに、幅と高さを整数ノードに入れ、(widthとheightという名前の)Setノードで保存し、どこでもGetノードで読み出します。サイズは最初に1回変えるだけで、使うすべてのノードが更新されます。
深度マップとControlNet
リサイズしたレンダリングはDepth Anything V2を通ります。最高の品質を得るため最大のモデルを使います。メモリが足りなければ小さいモデルもありますが、Fluxはもともとかなりのメモリを必要とします。その解像度もGetノードから来ます。
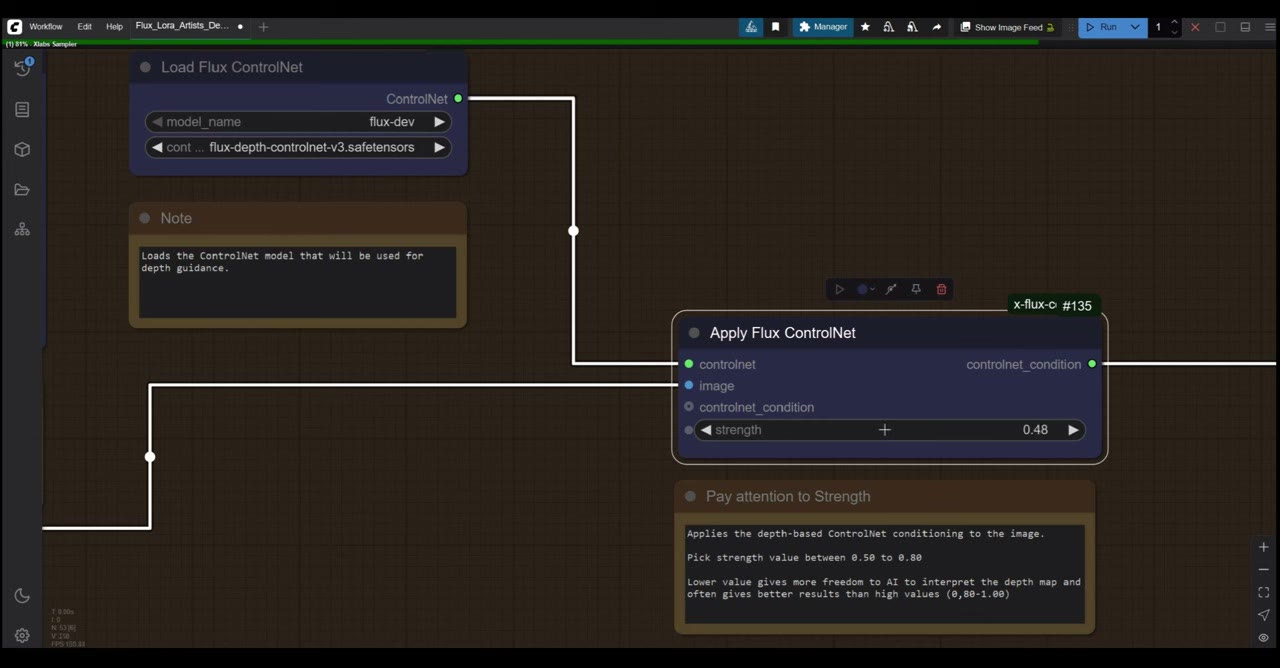
深度マップは、(Model Managerから入手する)Flux depth ControlNet v3を使ったApply Flux ControlNetに入ります。重要なのは強度です。
- 1.0付近: 結果がとても醜くなります。
- 0.5未満: 創造的すぎて、ポーズが失われます。
- 0.6〜0.9が有効な範囲です。私は0.7を使います。 Fluxに解剖学を直せる十分な自由が残るからです。
この自由こそが狙いです。私は女性のMixamoキャラクターにポーズを付けましたが、結果は全身鎧を着た、説得力のある解剖学の男性の姿でした。
モデルとLoRA
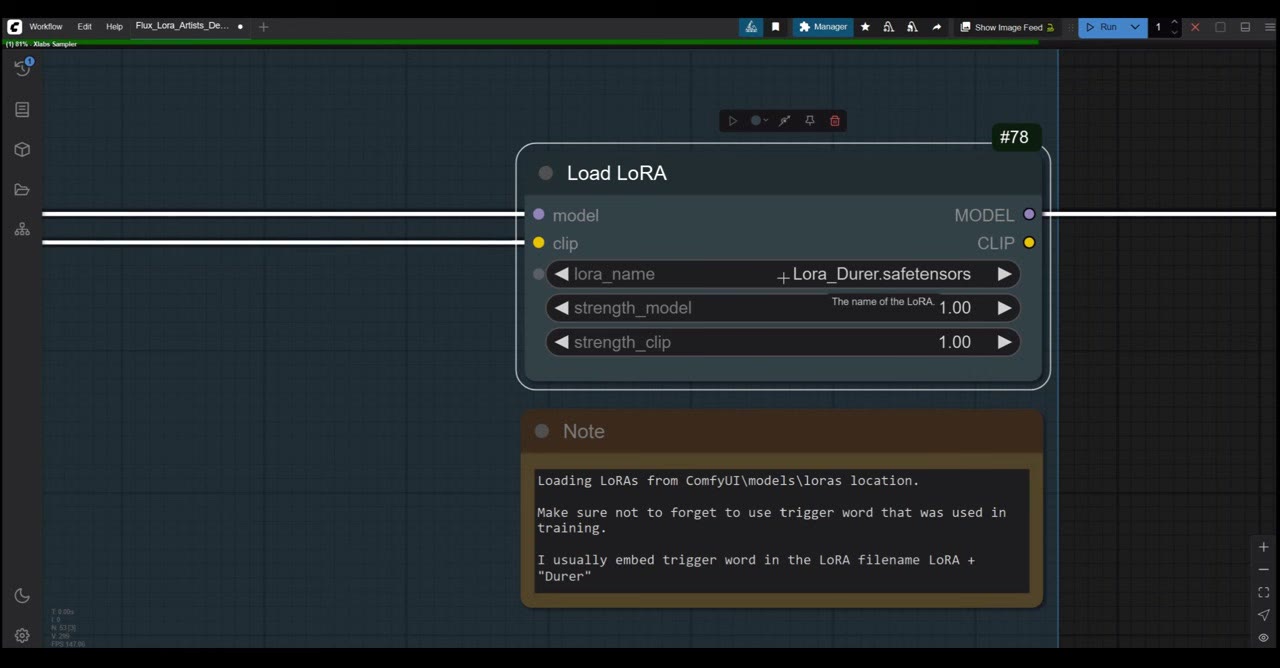
Load Diffusion ModelがFlux 1 dev(約12GB。Model Managerからのダウンロードは、終わるまでComfyUIがフリーズします)を読み込みます。それがスタイルLoRA、ここではデューラーLoRAのLoad LoRAノードに渡り、モデルの重みをその見た目に近づけます。LoRAの強度は最大のままにしています。スタイルをほんのり出したいだけなら、下げてください。
Empty Latent Imageも、Getノードから同じ幅と高さを受け取ります。
プロンプト
DualCLIPLoaderが、Fluxの2つのテキストエンコーダー、CLIP-LとT5 XXL(どちらもModel Managerにあります)を読み込みます。プロンプトの各部分を、画像が向かう方向に変換します。
ポジティブプロンプトは、LoRAのトリガーワードで始め、そこに文脈を足します。Fluxは自然言語のプロンプト向けに作られていて、ネガティブプロンプトは実質的に使わないため、望まないものではなく望むものを記述します。Flux Guidanceは3です。もっと高いと画像が焼け、コントラストが強くなりすぎます。
サンプル、デコード、比較、保存
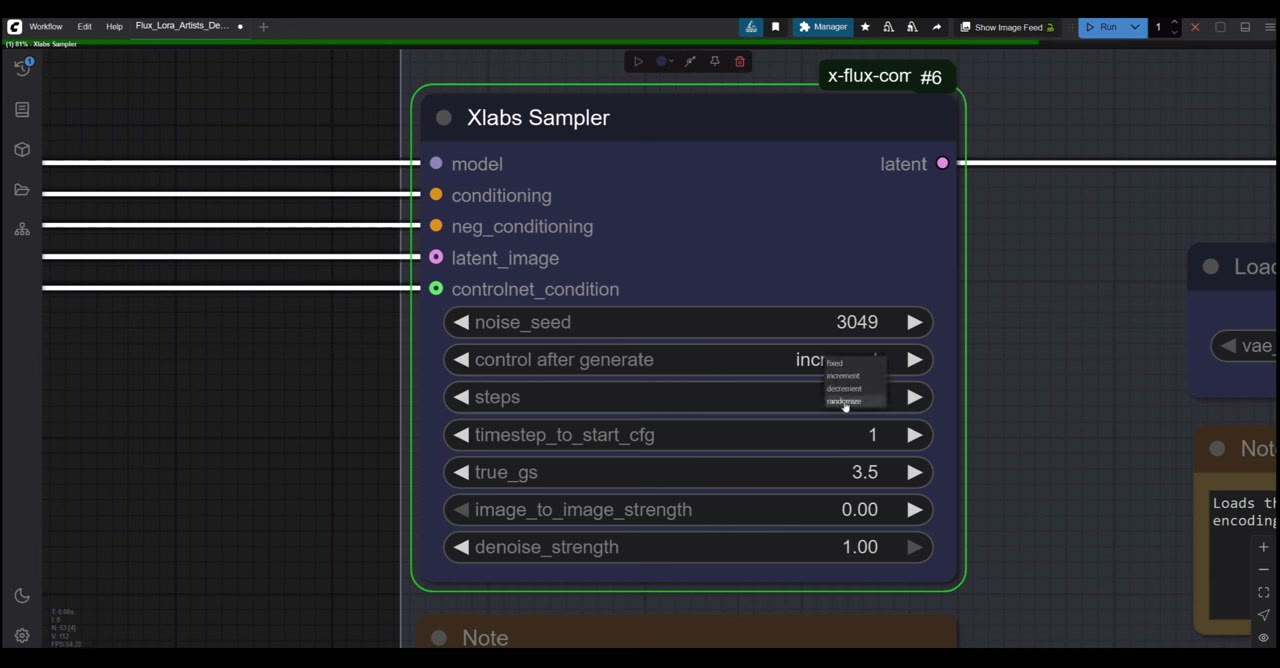
XLabs Samplerが、モデル、プロンプト、latent、ControlNetのすべてをまとめます。
- Seedはincrement。 画像が順番に番号付けされ、seedと設定を再利用すればいつでも再現できます。
- Steps: 25。 50まで上げる人もいますが、私は25で良い結果が出ます。それ以上は過剰です。
Flux VAE(約300MB)を使ったVAE Decodeが、結果をピクセルに変換します。rgthreeのimage comparerがBlenderのレンダリングと結果を並べて表示し、WASのImage Saveノードが、指定のフォルダとプレフィックスでファイルを書き出します。
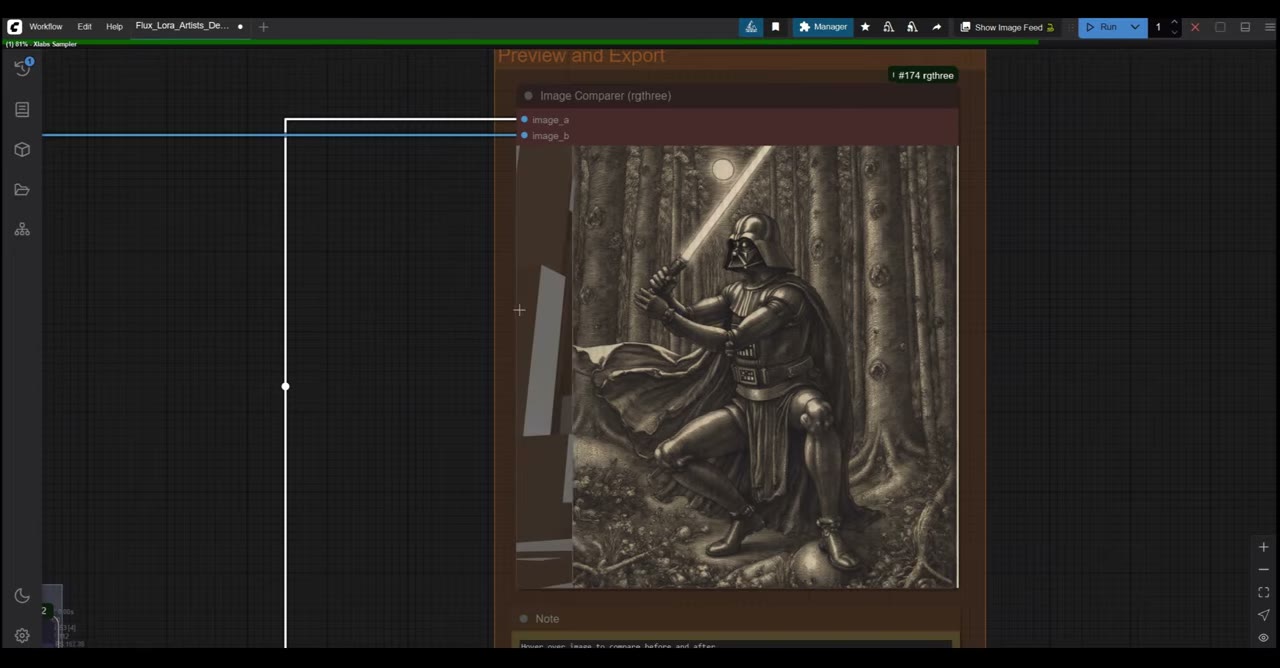
手はまずまずの出来でした。10回実行すれば、ほぼ完璧なものが出ます。
トラブルシューティング
実行が止まったら(私のものは深度マップの計算中に81%で止まりました)、ComfyUIを再起動してください。私はVRAMが24GBありますが、ほかのプログラムがカードを使っていると、それでも足りないことがあります。GPUが小さい場合は、借りるほうが手軽です。RunPod入門で方法を説明しています。
RunPodを試すなら、私の紹介リンクから、Googleでサインアップした新規アカウントは最初の10ドルの利用後に5〜500ドル分のクレジットを受け取れ、私には少額の紹介報酬が入ります。
動画版を見る (21:40)
上の内容はすべて動画でも説明しています。画面を見ながら進めたい方はこちらをどうぞ。 動画は英語です。
よくある質問
これには詳細な3Dモデルが必要ですか?
いいえ。深度ControlNetはとても粗いジオメトリで動き、棒人間でも機能します。私のシーンは、無料のMixamoキャラクターの周りに置いた、キューブ、球、円柱で作りました。
ControlNetの強度はどのくらいにすべきですか?
0.6〜0.9です。私は通常0.7を使います。ポーズと構図を保ちつつ、Fluxに悪い解剖学を直せるだけの自由を与えます。
AIはキャラクターの体を変えられますか?
はい、ControlNetの強度に余地があれば可能です。私は女性のMixamoキャラクターにポーズを付けましたが、結果は解剖学が修正された、鎧を着た男性の姿になりました。

Anton Tenitsky は コンピュータグラフィックスで15年以上の経験を持つ3Dアーティストで、Nickelodeon、Gameloft、Marvel Rivalsをはじめ多くのクライアントと仕事をしてきました。 プロフィールを見る