Un prompt por sí solo te da poco control sobre la pose y la composición. Una escena 3D te lo da todo. En este flujo coloco en pose a un personaje en Blender, monto una escena tosca con cajas y dejo que Flux la renderice con el estilo de un artista concreto, aquí los grabados de Albrecht Dürer, mediante un LoRA de estilo.
El estilo viene de un LoRA que entrené con unos diez grabados de Dürer. El entrenamiento se explica paso a paso en cómo entrenar un LoRA con el estilo de cualquier artista, así que esta guía empieza donde termina aquella: con un archivo LoRA ya entrenado.
En resumen
- Pose: un personaje y una animación gratuitos de Mixamo, importados en Blender.
- Escena: cubos, esferas y cilindros, renderizados con Eevee.
- Estructura: un mapa de profundidad de Depth Anything V2 controla el ControlNet de profundidad de Flux v3, con una fuerza de unos 0,7.
- Estilo: un LoRA de Flux entrenado con la obra de un artista, con su trigger word al principio del prompt.
- Calidad: Flux 1 dev, guidance 3, 25 steps.
1. Consigue un personaje en pose desde Mixamo
Mixamo es una biblioteca gratuita de Adobe con personajes y animaciones. Elige un personaje y luego busca entre las animaciones una pose que encaje con tu idea. Yo busqué «sword» y usé Great Sword Crouching Block; cualquier fotograma de una animación puede ser tu pose.
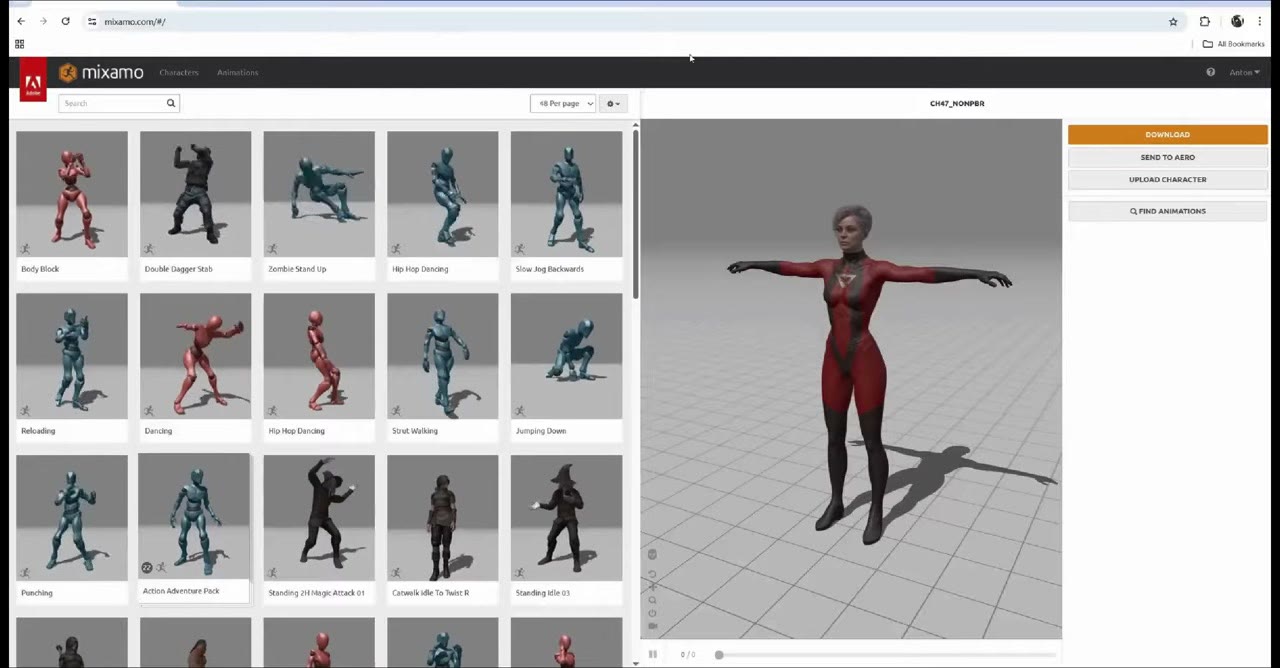
El personaje no necesita una buena anatomía. Los ControlNet de profundidad funcionan con formas muy toscas, incluso muñecos de palitos. Descarga la animación como FBX con los ajustes por defecto (la mía ocupaba unos 50 MB).
Una nota sobre licencias: para los personajes que vendo, hice y rigueé los míos, porque no puedo usar los personajes de Mixamo comercialmente en un paquete. Para poner en pose tus propios renders, Mixamo es el comienzo más fácil.
2. Construye la escena en Blender
En Blender, usa File → Import → FBX, oculta la armadura y recorre la línea de tiempo para encontrar el fotograma y el ángulo que quieres.
Después construye la escena con primitivas. Añadí un cilindro como sable láser (es una pose estática, así que no hace falta emparentarlo) y creé todo un paisaje urbano con cajas: duplicadas muchas veces, estiradas y repartidas. Coloca la cámara, añade una luz y renderiza con Eevee, con el ray tracing activado.
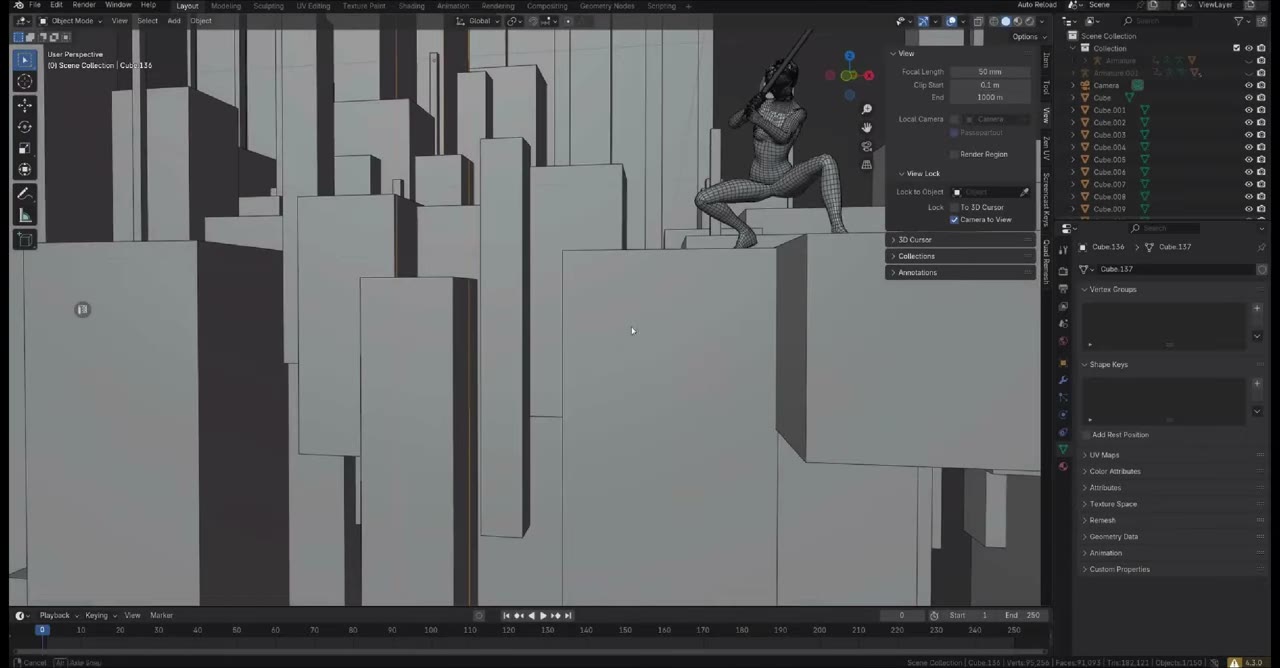
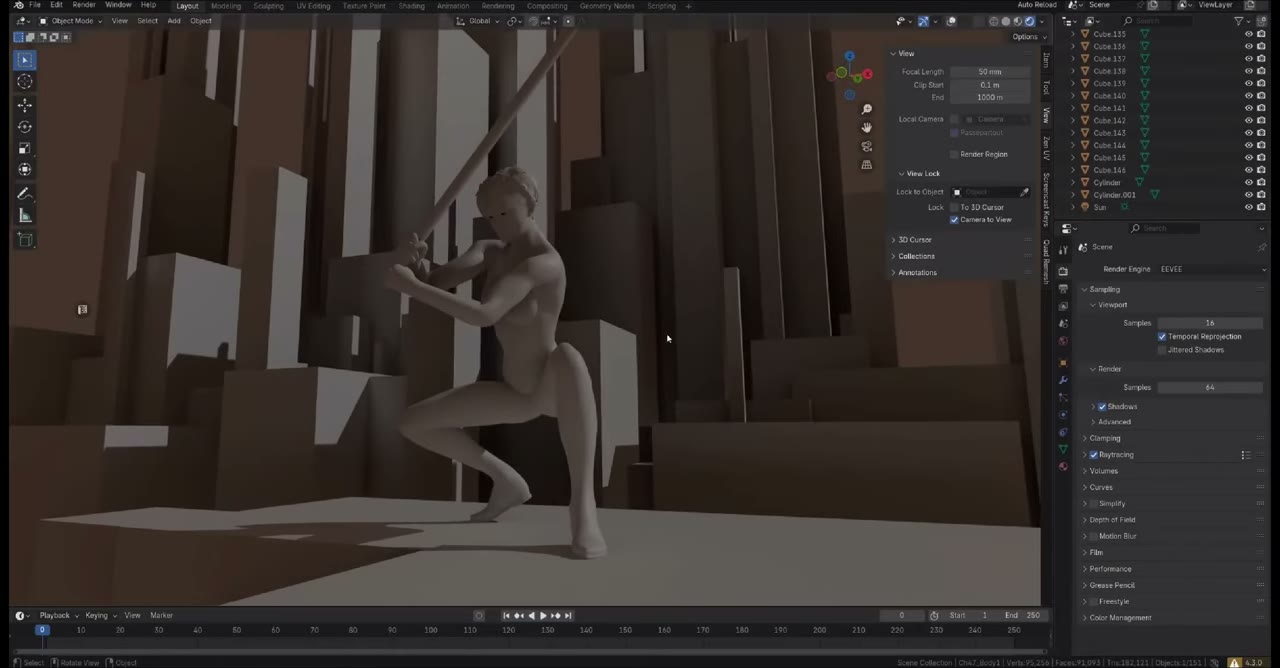
La anatomía de mi pose es fea, con deformaciones raras y las típicas «manos de IA». No importa: con la fuerza de ControlNet adecuada, la IA la reconstruye.
3. El flujo de ComfyUI
Necesitarás estos custom nodes, todos desde el ComfyUI Manager: comfyui_controlnet_aux (Depth Anything), x-flux-comfyui (ControlNet y sampler de Flux), KJNodes (nodos Set/Get), rgthree (comparador de imágenes) y el WAS Node Suite (Image Save). El flujo terminado, con mis tres LoRA de artistas, está en mi Patreon.
Carga y redimensiona el render
Un nodo Load Image trae tu render de Blender. Uso renders cuadrados: a 1024 × 1024, Flux da de forma fiable muy buenos resultados. Una nota en el flujo enumera otras buenas resoluciones para Flux.
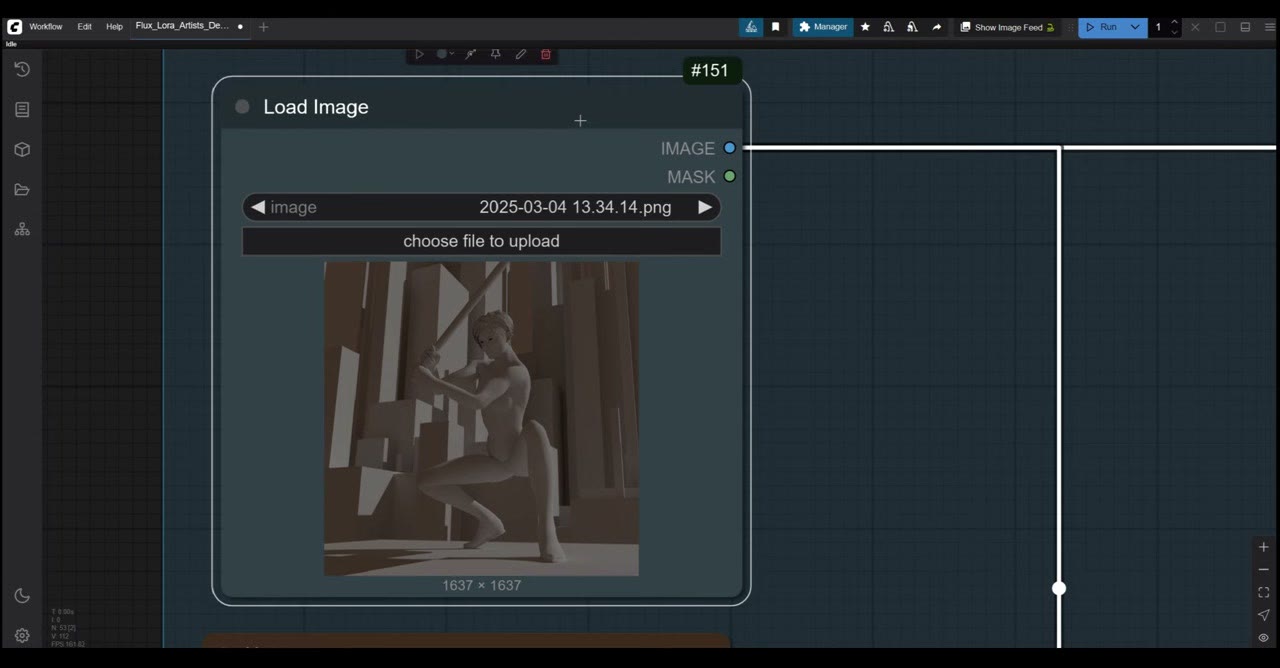
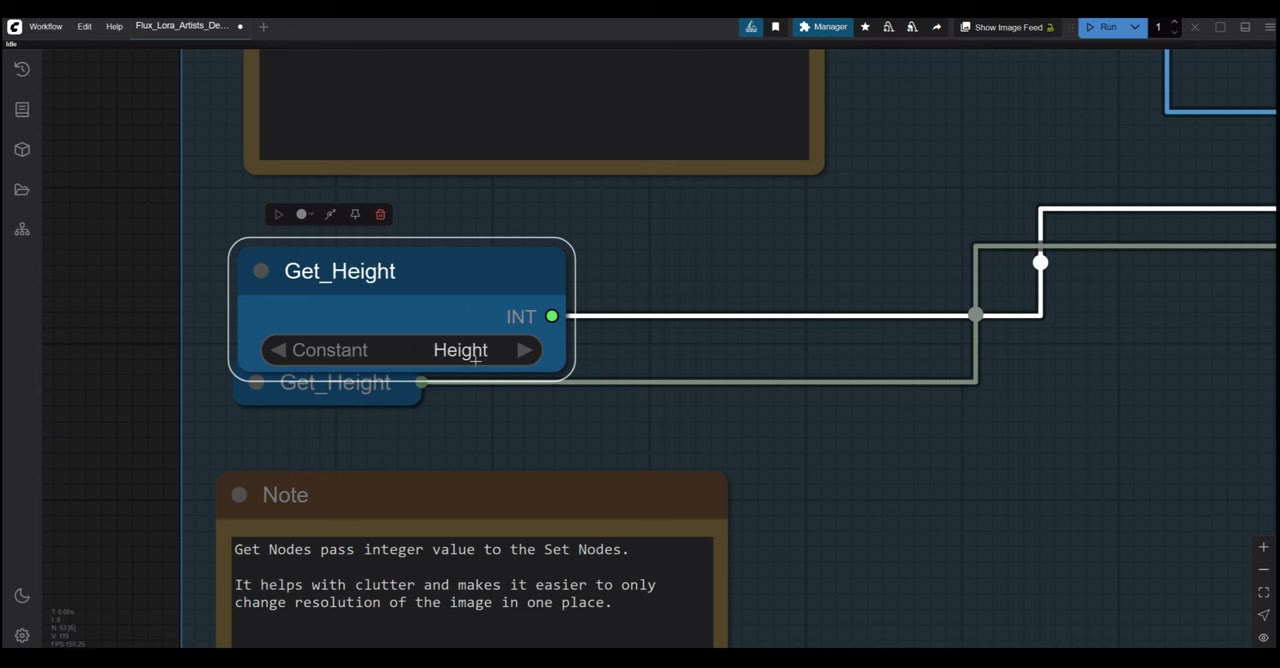
Un truco ordenado: nodos Set y Get. La resolución se necesita en varios sitios. En lugar de escribirla en todas partes o tender cables largos por el grafo, pongo el ancho y el alto en nodos de enteros, los guardo con nodos Set (llamados width y height) y los leo en cualquier sitio con nodos Get. Cambia el tamaño una vez, al principio, y se actualiza cada nodo que lo usa.
Mapa de profundidad y ControlNet
El render redimensionado pasa por Depth Anything V2. Uso el modelo más grande para tener la mejor calidad; existen otros más pequeños si andas justo de memoria, aunque Flux necesita bastante de todos modos. Su resolución también viene del nodo Get.
El mapa de profundidad entra en Apply Flux ControlNet con el ControlNet de profundidad de Flux v3 (del Model Manager). La fuerza es el ajuste que importa:
- Cerca de 1,0: el resultado queda muy feo.
- Por debajo de 0,5: demasiado creativo; pierde tu pose.
- De 0,6 a 0,9 es el rango útil. Yo uso 0,7, porque deja a Flux libertad suficiente para corregir la anatomía.
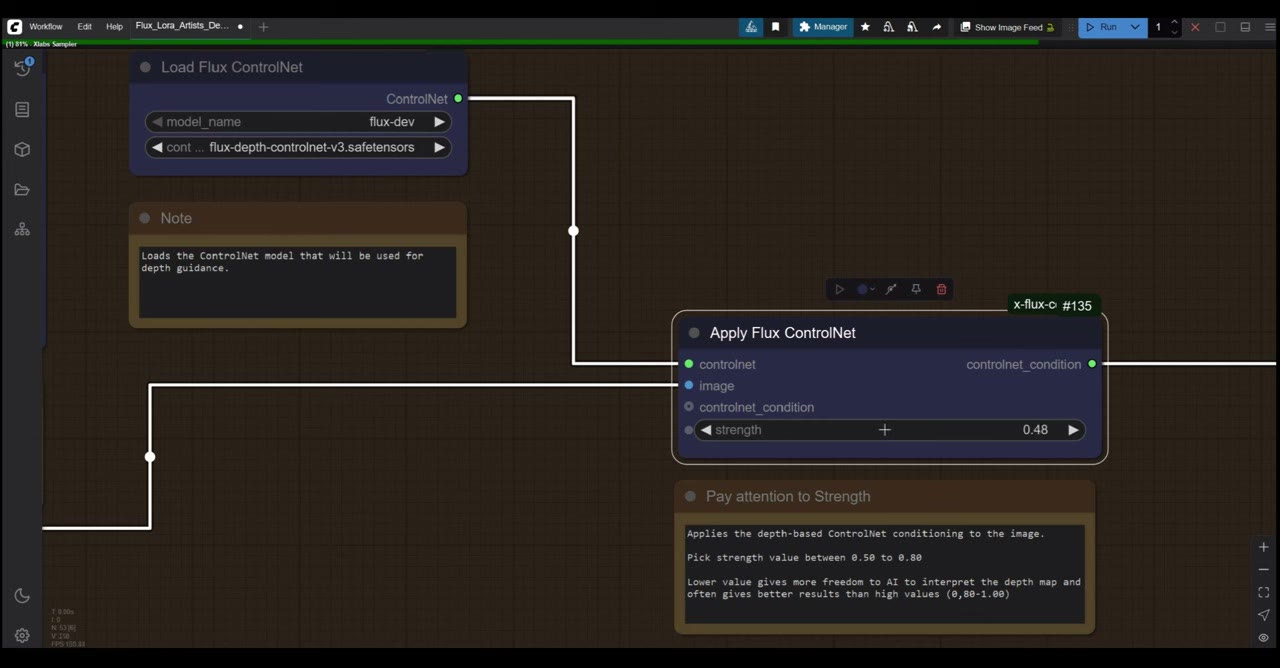
Esa libertad es el objetivo. Coloqué en pose un personaje femenino de Mixamo y el resultado es una figura masculina con armadura completa, con una anatomía creíble.
Modelo y LoRA
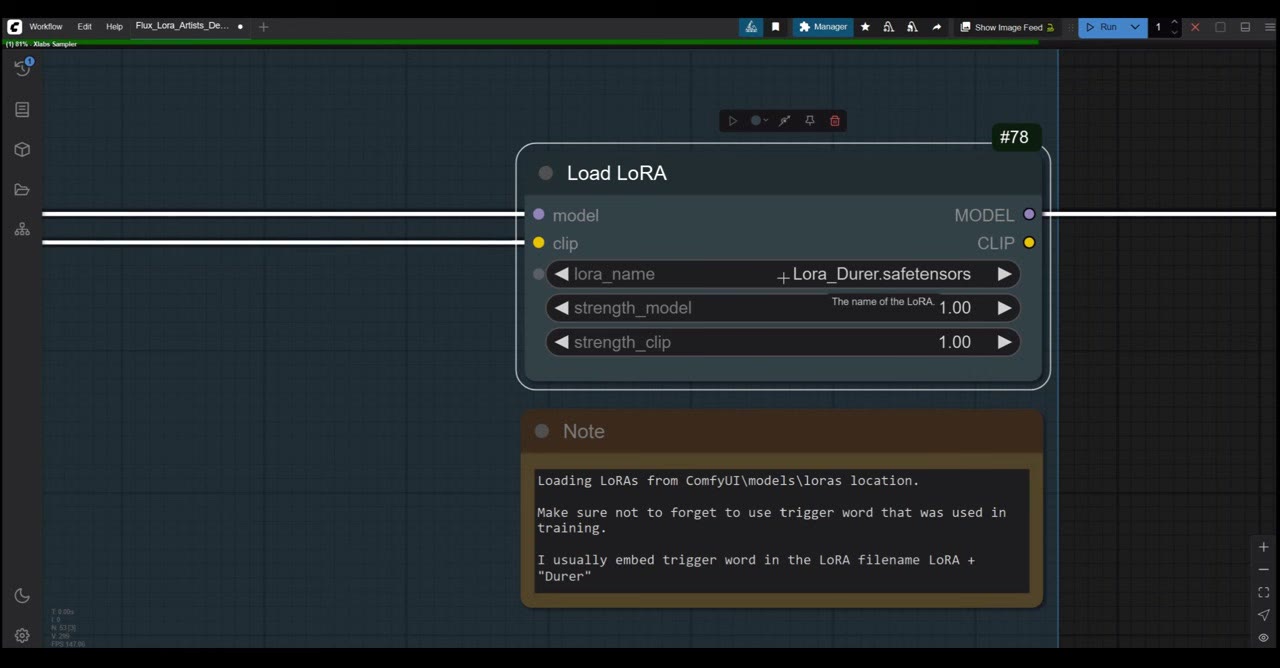
Load Diffusion Model carga Flux 1 dev (unos 12 GB; la descarga desde el Model Manager congela ComfyUI hasta que termina). Alimenta un nodo Load LoRA con el LoRA de estilo, aquí mi LoRA de Dürer, que ajusta los pesos del modelo hacia ese aspecto. Dejo la fuerza del LoRA al máximo; bájala si solo quieres un toque del estilo.
El Empty Latent Image recibe el mismo ancho y alto desde los nodos Get.
Prompt
El DualCLIPLoader carga los dos codificadores de texto de Flux, CLIP-L y T5 XXL (ambos en el Model Manager). Convierten cada parte de tu prompt en una dirección para la imagen.
Empieza el prompt positivo con la trigger word de tu LoRA, y luego añade contexto. Flux está diseñado para prompts en lenguaje natural y en realidad no usa prompts negativos, así que describe lo que quieres, no lo que no quieres. Flux Guidance en 3; mucho más alto y la imagen se quema, con un contraste duro.
Muestrea, decodifica, compara, guarda
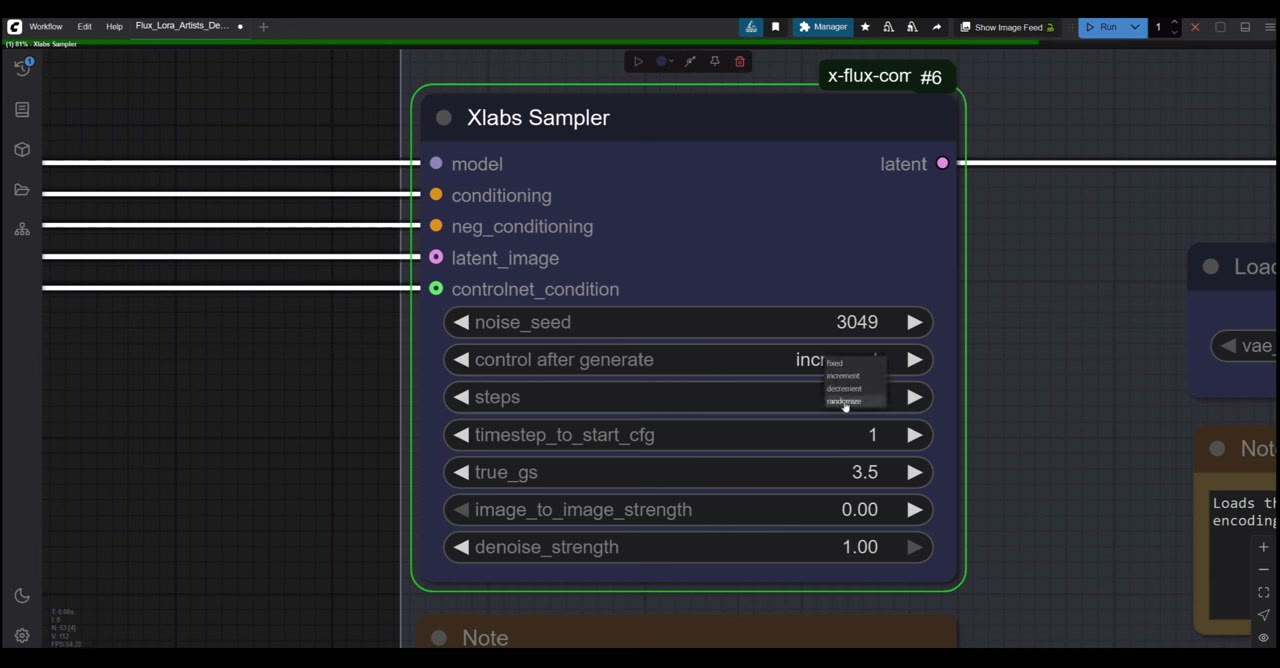
El XLabs Sampler lo reúne todo: modelo, prompts, latente y ControlNet.
- Seed en increment, para que las imágenes se numeren en orden y siempre puedas reproducir una reutilizando su seed y sus ajustes.
- Steps: 25. La gente llega a 50, pero yo obtengo buenos resultados con 25; lo que pase de ahí es excesivo.
VAE Decode, con el VAE de Flux (unos 300 MB), convierte el resultado en píxeles. Un comparador de imágenes de rgthree muestra el render de Blender y el resultado uno al lado del otro, y un nodo Image Save de WAS escribe el archivo con tu carpeta y tu prefijo.
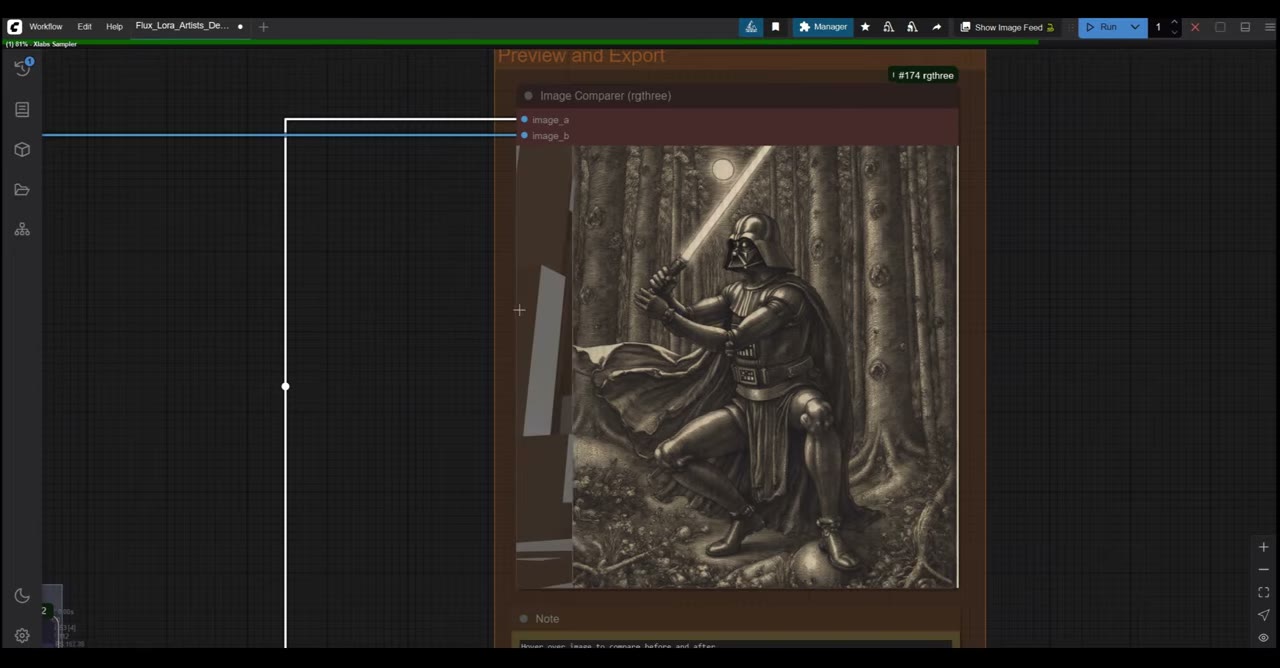
Las manos salieron decentes. Ejecútalo diez veces y tendrás una casi perfecta.
Solución de problemas
Si una ejecución se atasca (la mía se detuvo al 81 % mientras calculaba el mapa de profundidad), reinicia ComfyUI. Tengo 24 GB de VRAM, y ni siquiera eso siempre basta cuando otros programas usan la tarjeta. Si tu GPU es más pequeña, alquilar una es la vía más fácil; mi introducción a RunPod explica cómo.
Si pruebas RunPod, mi enlace de referido da a las cuentas nuevas que se registran con Google entre 5 y 500 $ de crédito después de su primer gasto de 10 $, y yo recibo una pequeña comisión.
Ver la versión en vídeo (21:40)
Todo lo anterior también está en el vídeo, si prefieres seguirlo en pantalla. El vídeo está en inglés.
Preguntas frecuentes
¿Necesito un modelo 3D detallado para esto?
No. Un ControlNet de profundidad funciona con geometría muy tosca; incluso los muñecos de palitos pueden servir. Mi escena se construyó con cubos, esferas y cilindros alrededor de un personaje gratuito de Mixamo.
¿Qué fuerza de ControlNet debo usar?
Entre 0,6 y 0,9. Yo suelo usar 0,7: mantiene la pose y la composición pero da a Flux libertad suficiente para corregir una mala anatomía.
¿Puede la IA cambiar el cuerpo del personaje?
Sí, si la fuerza del ControlNet le deja margen. Coloqué en pose un personaje femenino de Mixamo y el resultado es una figura masculina con armadura, con la anatomía corregida.

Anton Tenitsky es artista 3D con más de 15 años en gráficos por ordenador, que ha trabajado con Nickelodeon, Gameloft, Marvel Rivals y muchos otros clientes. Más sobre mí