Status: Testado no RunPod. Rodei os dois fluxos com este template no RunPod para o vídeo.
Fazer um efeito sonoro com IA é fácil. Fazer 50 ou 500, cada um com seu próprio prompt, duração e nome de arquivo, é para isso que serve esta configuração. Ela roda o Stable Audio 3 Medium no ComfyUI com dois fluxos prontos: um para sons avulsos e outro que percorre uma lista sozinho.
Você pode rodar localmente: o guia de instalação no GitHub lista todos os modelos e nós, e um chatbot pode transformá-lo em comandos de instalação para sua máquina. Ou use o template do RunPod de um clique, que vem com tudo instalado em cerca de dois minutos.
Em resumo
- Modelo: Stable Audio 3 Medium, integrado ao ComfyUI. É leve: quase qualquer GPU funciona.
- Um som: digite um prompt, defina a duração em segundos, execute.
- Lote: três listas (prompts, durações, nomes de arquivo), uma linha por som, execute até terminar.
- Ajustes que uso: 50 steps, guidance 7.
- Veredicto honesto: não é o melhor modelo de áudio que existe, mas é muito barato de rodar em volume.
Configuração
No RunPod: abra o template, escolha uma GPU e implante. O modelo é leve, então a GPU quase não importa; usei uma placa com cerca de 20 GB de VRAM. Um disco de 30–40 GB é mais que suficiente, já que os modelos somam cerca de 11 GB. A configuração leva cerca de dois minutos. O ComfyUI pode dizer «ready» um pouco cedo, então dê mais um ou dois minutos. Se o RunPod é novidade para você, comece pela minha introdução ao RunPod.
Localmente: você precisa do ComfyUI 0.30 ou mais novo (o suporte ao Stable Audio 3 é nativo), dos dois arquivos de modelo do repositório da Comfy-Org e do meu nó Prompt Cycler para o fluxo em lote. Você pode instalar o nó pelo «install via Git URL» do ComfyUI Manager.
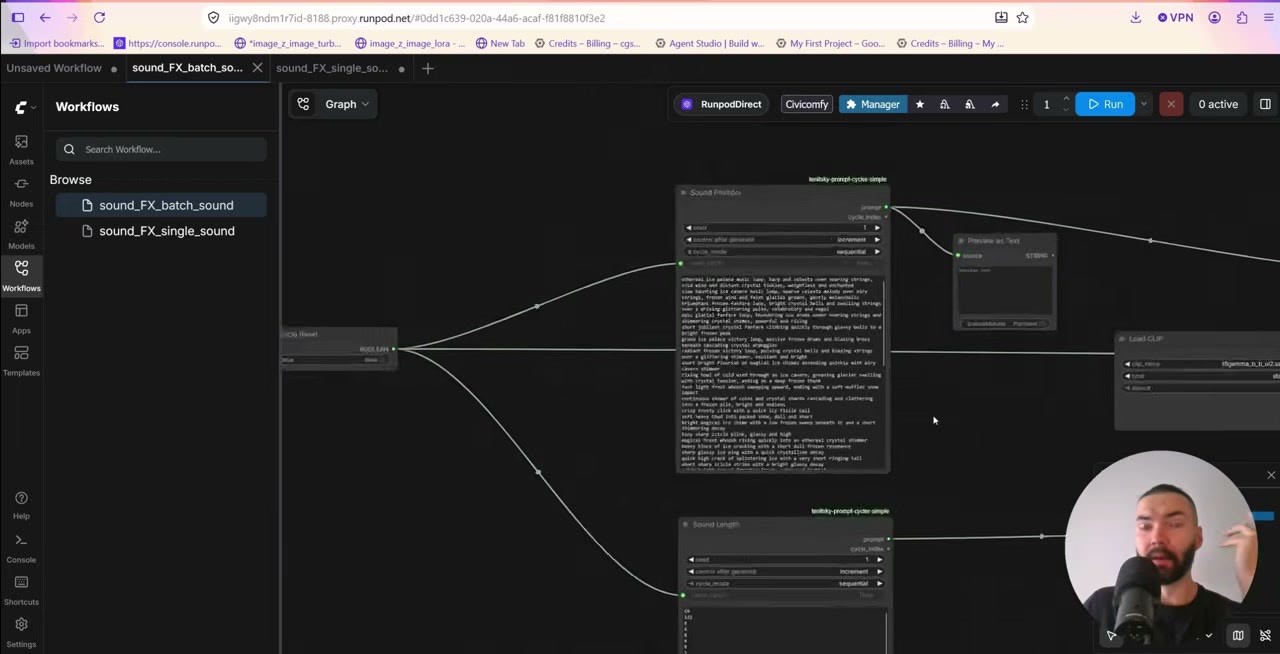
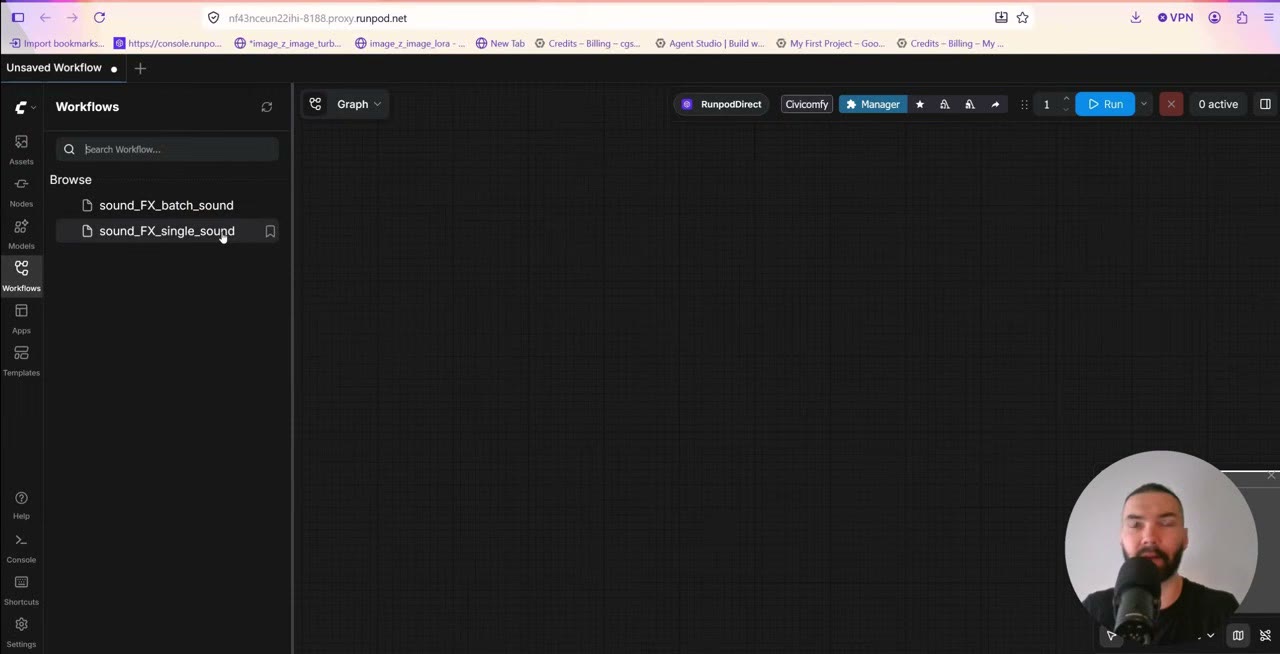
Os dois fluxos aparecem na barra lateral Workflows do ComfyUI: sound_FX_single_sound e sound_FX_batch_sound.
O fluxo de som único
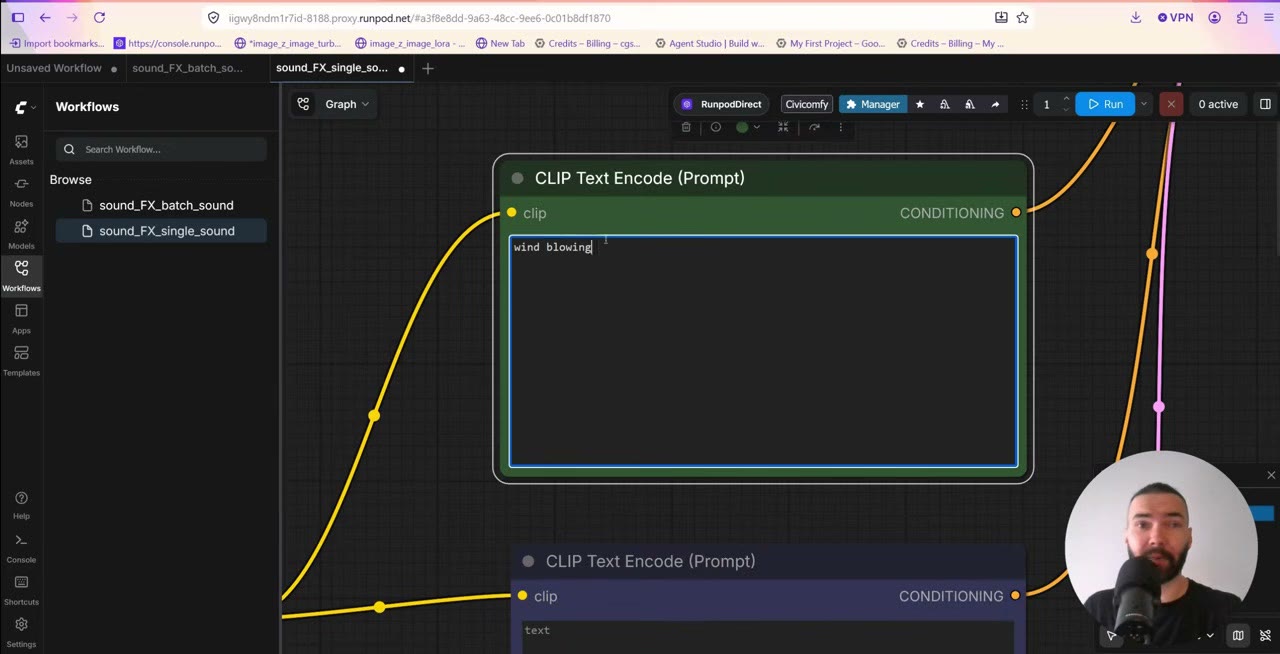
É um grafo pequeno:
- Load Checkpoint com o Stable Audio 3 Medium.
- Codificador de texto → prompts positivo e negativo. Ao contrário de muitos modelos, o Stable Audio suporta prompts negativos. Colocar «hiss» ou «ambient noise» ali às vezes limpa o resultado; às vezes não faz diferença.
- EmptyLatentAudio, onde você define a duração em segundos.
- KSampler com 50 steps e guidance (CFG) 7.
- Save Audio (MP3).
Duas coisas a saber sobre os ajustes:
- A duração é um máximo, não uma promessa. Peça 6 segundos e você pode receber 4 segundos de som e depois silêncio.
- Steps. 50 steps com guidance 7 é o que uso para qualidade. Também testei 8 steps com guidance 1 e ainda obtive sons utilizáveis, já que o modelo é rápido nos dois casos. Se quiser essa velocidade de propósito, o template pode baixar o Stable Audio 3 Medium destilado, feito para 8 steps com CFG 1 (defina
DOWNLOAD_SA3_MEDIUM=1e selecione-o no carregador de checkpoints).
Clique em Run. Um som leva alguns segundos, e você pode tocá-lo direto no nó. Os arquivos são salvos em ComfyUI/output/audio/ como MP3. Em um pod, baixe-os pelo JupyterLab.
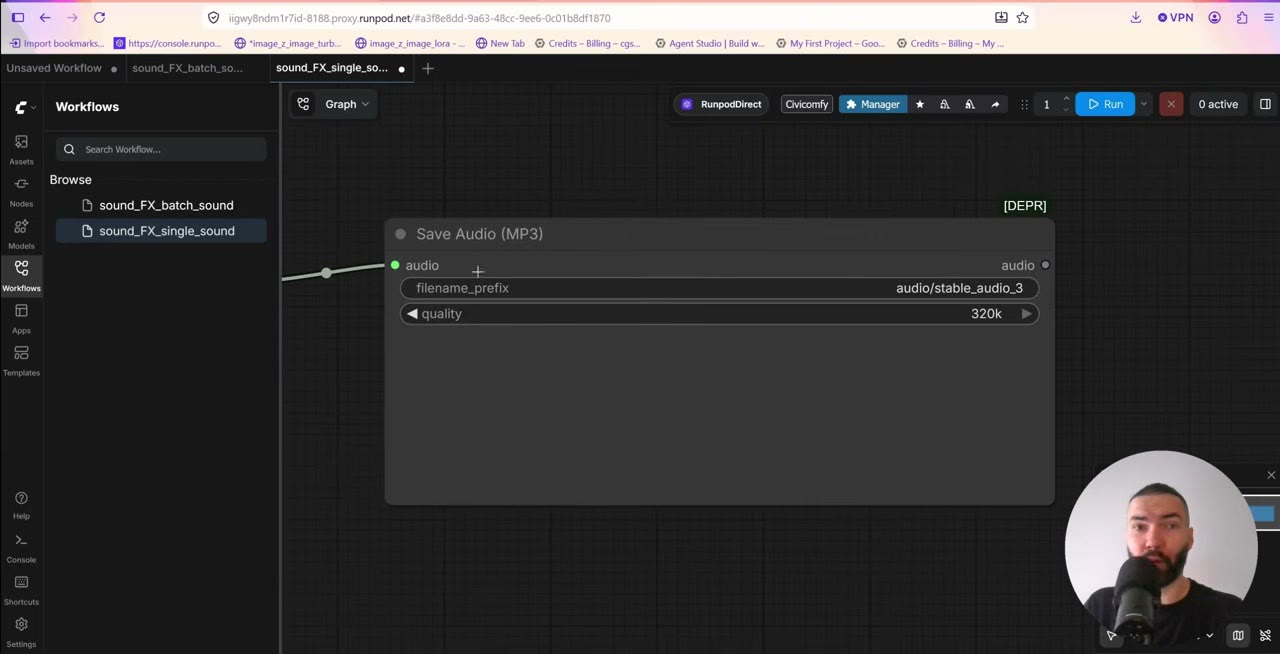
output/audio.O fluxo em lote
Um som por vez não é o objetivo. O fluxo em lote é o mesmo grafo com três listas, todas controladas pelo nó Prompt Cycler:
- Prompts: uma descrição de som por linha.
- Durações: a duração em segundos de cada linha (na minha lista, de 8 a 132 segundos).
- Nomes de arquivo: um nome por som.
A linha 1 de cada lista pertence ao som 1, a linha 2 ao som 2, e assim por diante. Mantenha as três listas com o mesmo tamanho e na mesma ordem.
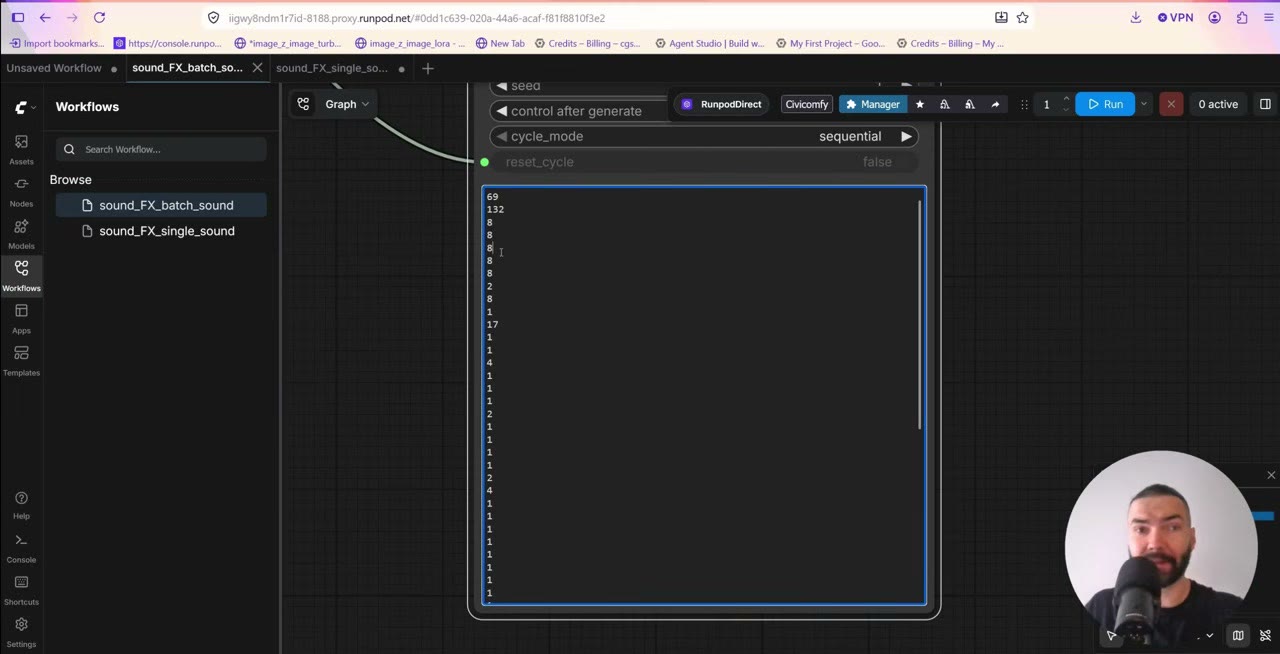
A maneira mais fácil de preencher as listas é pedir a um chatbot (ChatGPT, Gemini ou Claude) os prompts, as durações e os nomes de arquivo como três listas limpas, sem numeração nem marcadores.
Depois enfileire com Run (Instant), ou defina a contagem do lote como o número de linhas. Um nó de pré-visualização mostra qual prompt está rodando. Cada som leva alguns segundos.
Reiniciando o lote
A posição do lote fica na memória. Para recomeçar da primeira linha, ou depois de reiniciar o ComfyUI:
- Defina Cycle Reset como
truee execute uma vez. - Volte a defini-lo como
false. - Enfileire o lote de novo.
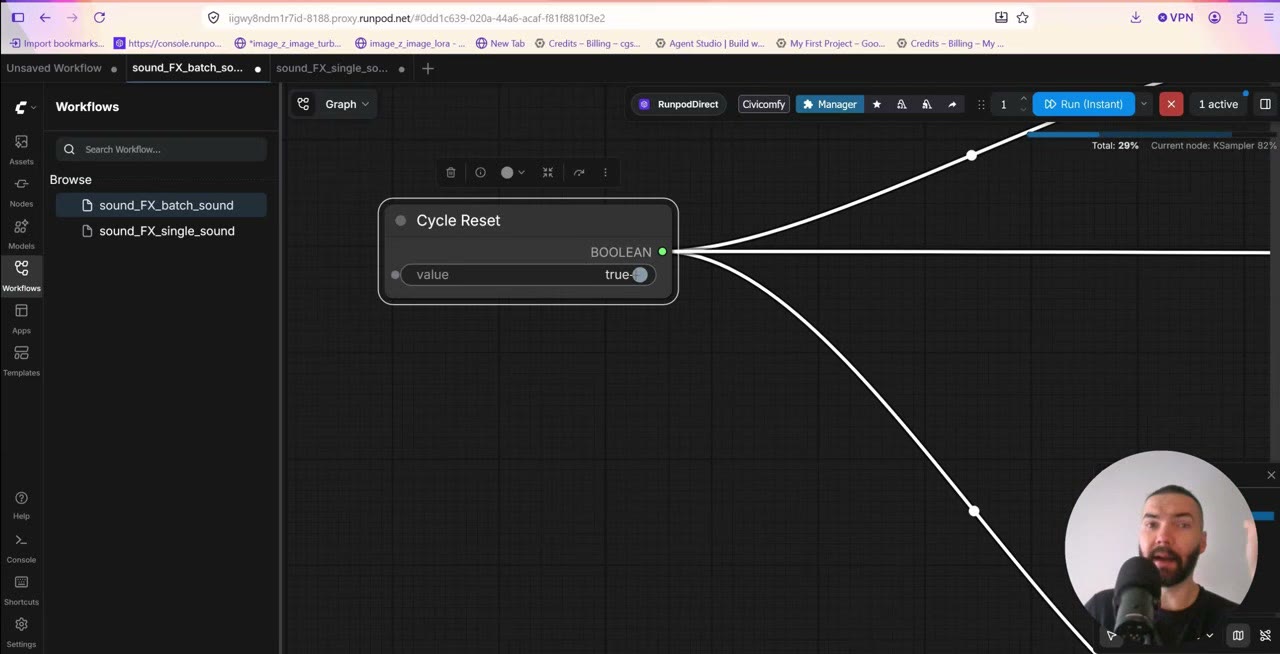
É um pouco desajeitado, mas é a abordagem mais confiável que encontrei. As listas também voltam ao início depois da última linha, então enfileire só tantas execuções quantas linhas você tiver, ou o lote recomeça.
Cada arquivo recebe um número anexado, como _00001. Eu os renomeio depois.
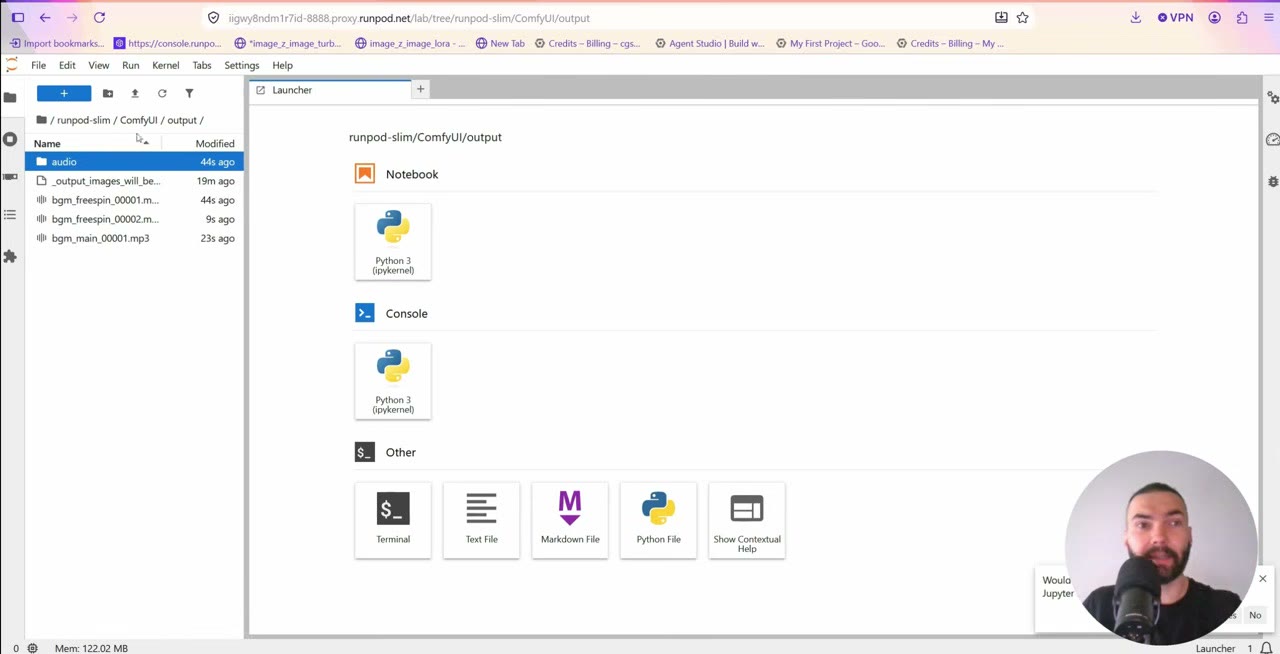
ComfyUI/output/audio, prontos para baixar.Quão bom é?
Os resultados variam. Alguns sons são ótimos, outros não, e o prompt faz uma grande diferença. O Stable Audio 3 não é o melhor modelo de áudio disponível: comparei com o ElevenLabs, e às vezes eram equivalentes, às vezes o ElevenLabs era melhor.
O que esta configuração oferece é volume e controle: centenas de sons com seus próprios nomes e durações, na sua própria GPU ou em uma alugada barata, e a liberdade de repetir qualquer um que não tenha ficado bom.
Quando terminar
Pare o pod para parar de cobrar, depois encerre-o: até o disco de um pod parado custa alguns centavos.
O link do template é um link de indicação do RunPod, assim como este: novas contas que se cadastram com o Google ganham de US$ 5 a US$ 500 em crédito após seus primeiros US$ 10, e eu recebo uma pequena comissão.
Assista à versão em vídeo (8:52)
Tudo o que está acima também está no vídeo, se você preferir acompanhar na tela. O vídeo está em inglês.
Perguntas frequentes
De que GPU preciso para o Stable Audio 3?
De muito pouco. O modelo tem cerca de 9 GB e rodou com folga na placa que usei, com cerca de 20 GB de VRAM. Uma placa de 16 GB deve bastar.
Qual a duração máxima de um efeito sonoro do Stable Audio 3?
Você define a duração em segundos. Minha lista em lote tinha durações de 8 a 132 segundos. O modelo nem sempre preenche o tempo: um pedido de 6 segundos pode dar 4 segundos de som e depois silêncio.
O Stable Audio 3 é tão bom quanto o ElevenLabs?
Nos meus testes, às vezes eram equivalentes e às vezes o ElevenLabs era melhor. A vantagem aqui é rodar centenas de sons na sua própria GPU ou em uma alugada barata.
Por que meu lote recomeçou do primeiro som?
A posição do lote fica na memória. Depois de reiniciar o ComfyUI, ou quando você enfileira mais execuções do que linhas, ele recomeça. Enfileire exatamente tantas execuções quantas linhas você tiver.

Anton Tenitsky é artista 3D com mais de 15 anos em computação gráfica, que trabalhou com Nickelodeon, Gameloft, Marvel Rivals e muitos outros clientes. Mais sobre mim