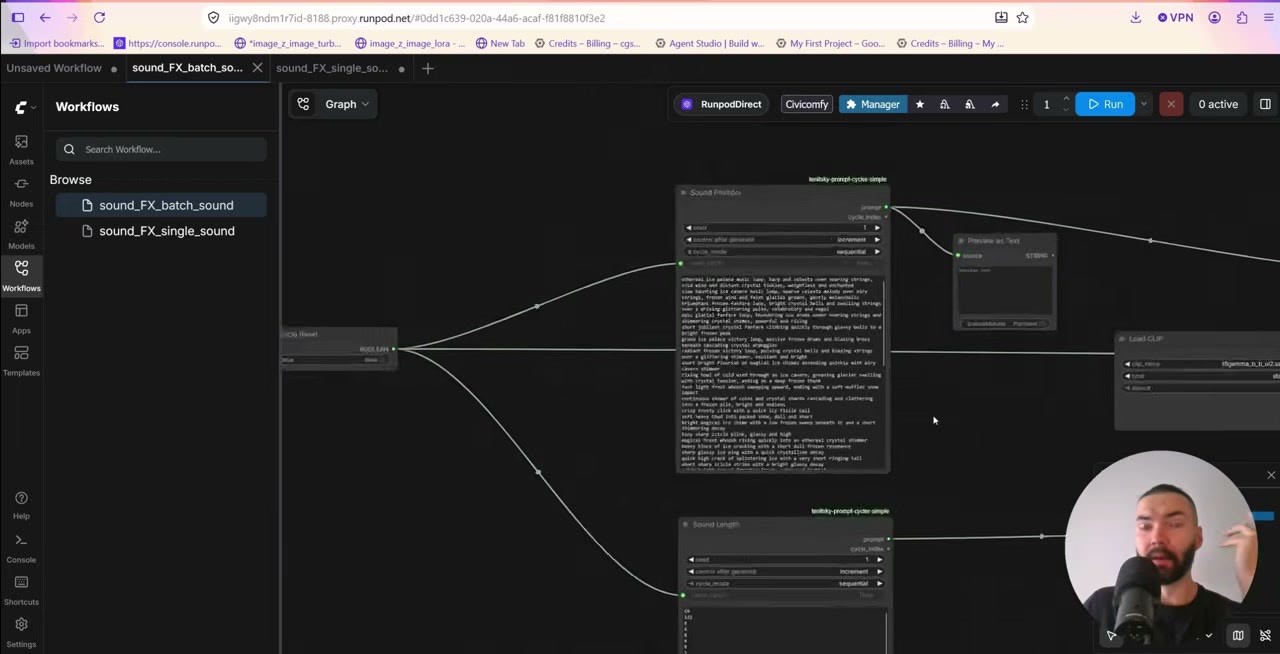
Statut: Testé sur RunPod. J'ai fait tourner les deux workflows avec ce template sur RunPod pour la vidéo.
Faire un effet sonore avec l’IA est facile. En faire 50 ou 500, chacun avec son propre prompt, sa durée et son nom de fichier, c’est à cela que sert cette configuration. Elle fait tourner Stable Audio 3 Medium dans ComfyUI avec deux workflows prêts : un pour les sons isolés et un qui parcourt une liste tout seul.
Vous pouvez l’exécuter en local : le guide d’installation sur GitHub liste chaque modèle et chaque node, et un chatbot peut le transformer en commandes d’installation pour votre machine. Ou utilisez le template RunPod en un clic, qui a tout d’installé en environ deux minutes.
En bref
- Modèle : Stable Audio 3 Medium, intégré à ComfyUI. Il est léger : presque n’importe quel GPU convient.
- Un son : saisissez un prompt, réglez la durée en secondes, lancez.
- Lot : trois listes (prompts, durées, noms de fichiers), une ligne par son, lancez jusqu’à la fin.
- Réglages que j’utilise : 50 étapes, guidance 7.
- Verdict honnête : pas le meilleur modèle audio qui soit, mais très peu coûteux à faire tourner en volume.
Mise en place
Sur RunPod : ouvrez le template, choisissez un GPU et déployez. Le modèle est léger, le GPU importe donc à peine ; j’ai utilisé une carte avec environ 20 Go de VRAM. Un disque de 30 à 40 Go est largement suffisant, les modèles pesant environ 11 Go. L’installation prend environ deux minutes. ComfyUI peut afficher « ready » un peu trop tôt, laissez-lui encore une ou deux minutes. Si RunPod est nouveau pour vous, commencez par mon introduction à RunPod.
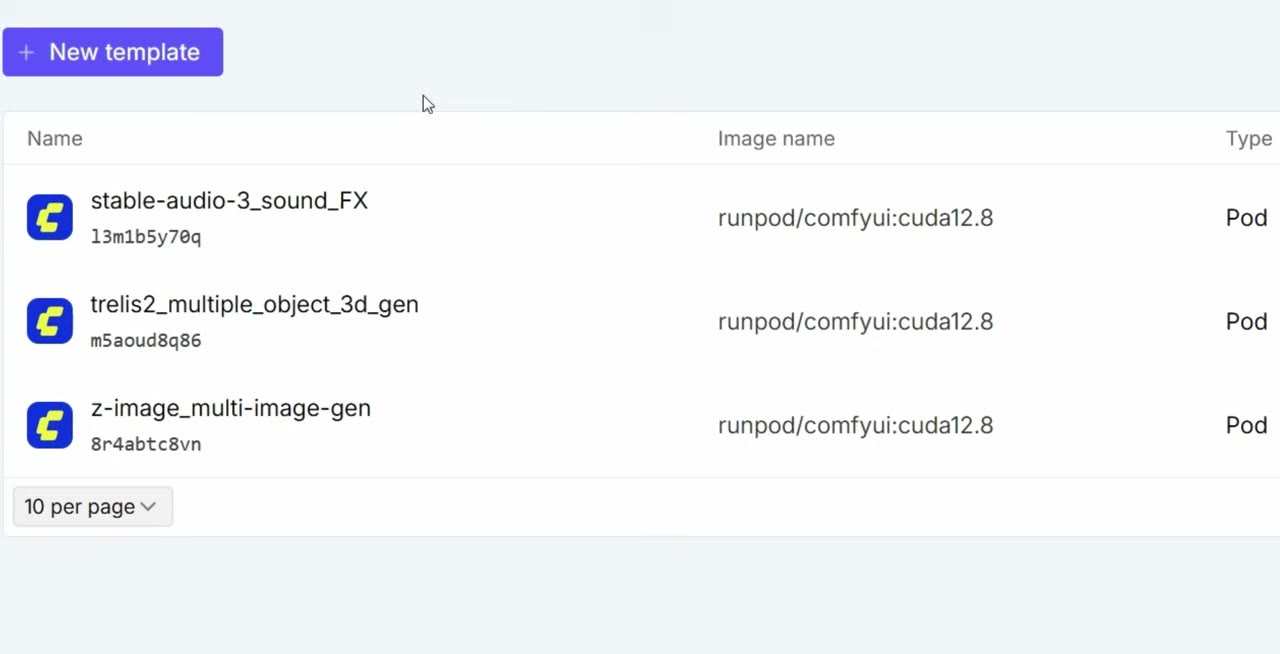
En local : il vous faut ComfyUI 0.30 ou plus récent (la prise en charge de Stable Audio 3 est intégrée), les deux fichiers de modèle du dépôt Comfy-Org et mon node Prompt Cycler pour le workflow par lots. Vous pouvez installer le node via « install via Git URL » du ComfyUI Manager.
Les deux workflows apparaissent dans la barre latérale Workflows de ComfyUI : sound_FX_single_sound et sound_FX_batch_sound.
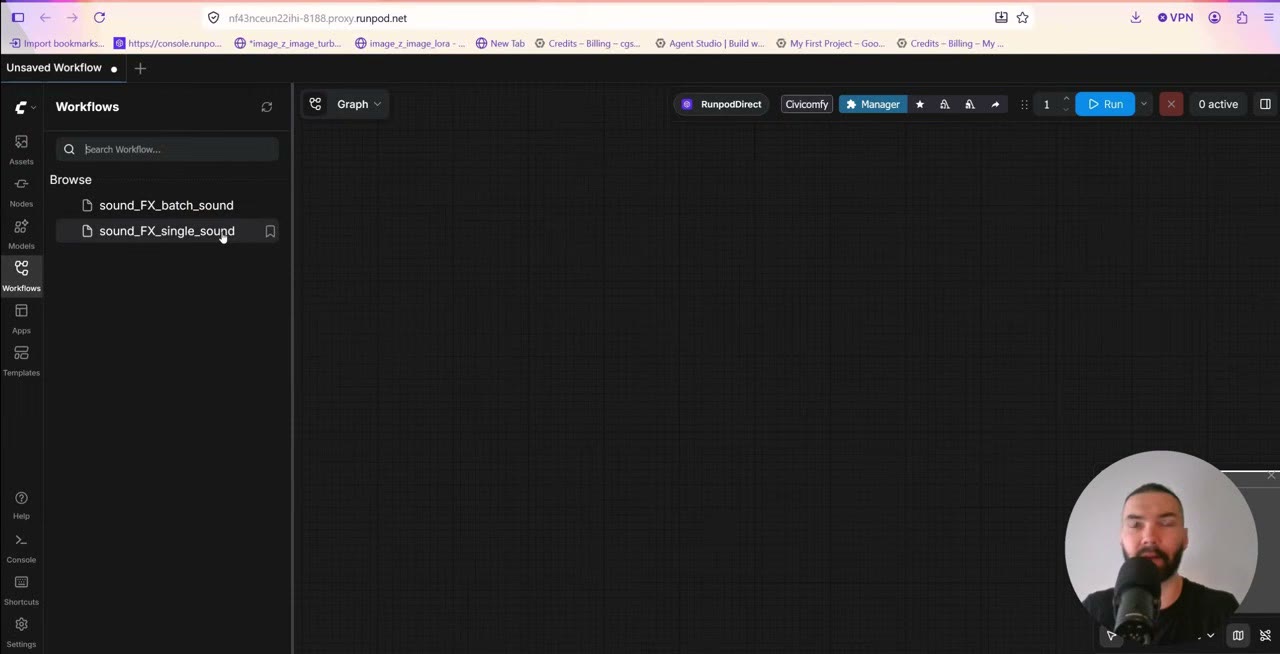
Le workflow à un seul son
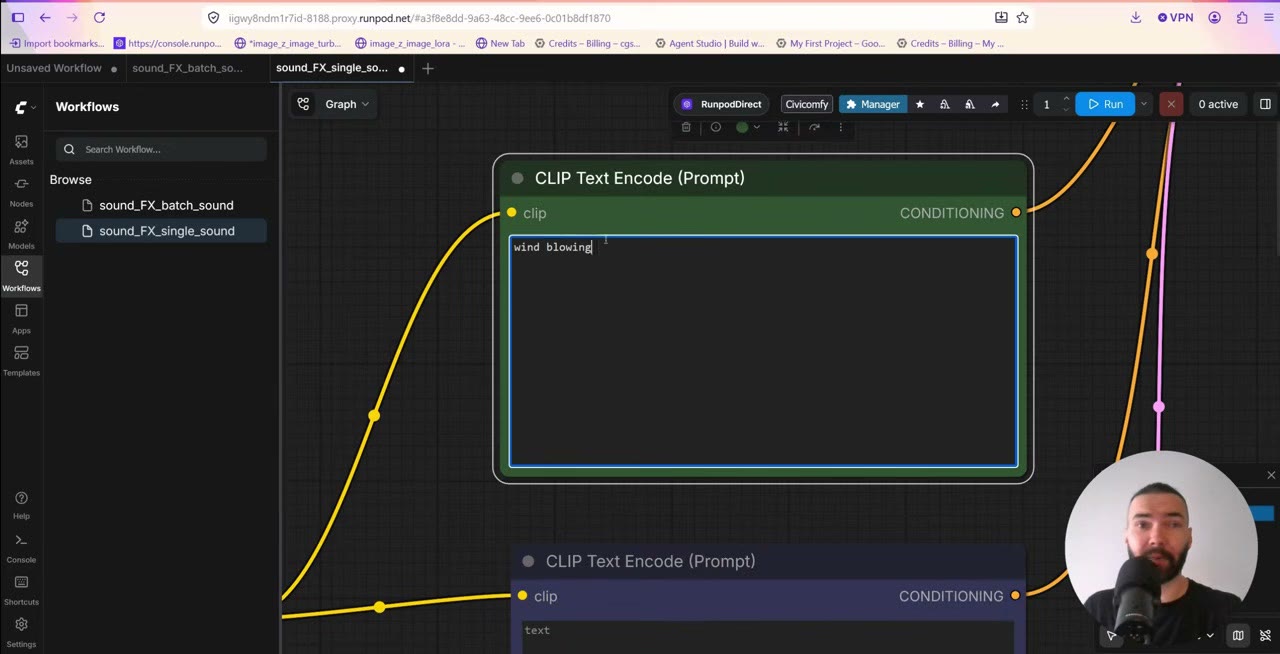
C’est un petit graphe :
- Load Checkpoint avec Stable Audio 3 Medium.
- Encodeur de texte → prompts positif et négatif. Contrairement à beaucoup de modèles, Stable Audio prend en charge les prompts négatifs. Y mettre « hiss » ou « ambient noise » nettoie parfois le résultat ; parfois, cela ne change rien.
- EmptyLatentAudio, où vous réglez la durée en secondes.
- KSampler à 50 étapes et guidance (CFG) 7.
- Save Audio (MP3).
Deux choses à savoir sur les réglages :
- La durée est un maximum, pas une promesse. Demandez 6 secondes et vous pouvez obtenir 4 secondes de son puis du silence.
- Étapes. 50 étapes avec une guidance de 7 est ce que j’utilise pour la qualité. J’ai aussi essayé 8 étapes avec une guidance de 1 et obtenu quand même des sons utilisables, le modèle étant rapide dans les deux cas. Si vous voulez cette vitesse volontairement, le template peut télécharger le Stable Audio 3 Medium distillé, conçu pour 8 étapes à CFG 1 (définissez
DOWNLOAD_SA3_MEDIUM=1, puis sélectionnez-le dans le chargeur de checkpoint).
Cliquez sur Run. Un son prend quelques secondes, et vous pouvez l’écouter directement sur le node. Les fichiers sont enregistrés en MP3 dans ComfyUI/output/audio/. Sur un pod, téléchargez-les via JupyterLab.
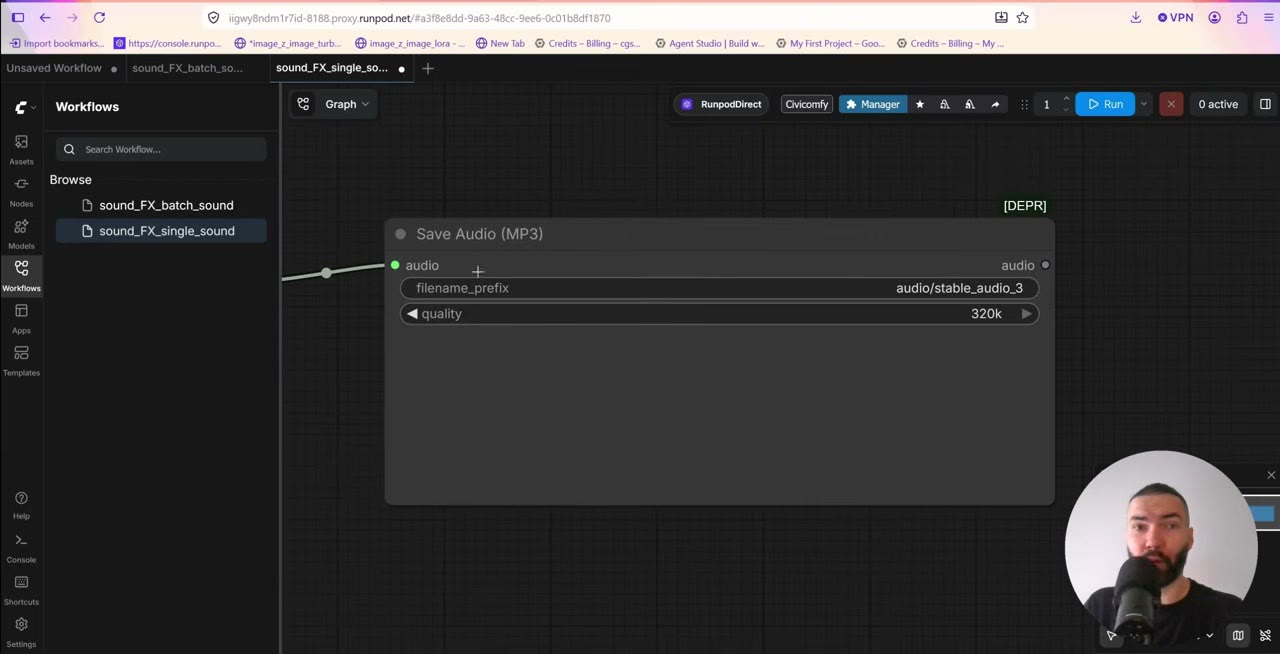
output/audio.Le workflow par lots
Un son à la fois n’est pas le but. Le workflow par lots est le même graphe avec trois listes, toutes pilotées par le node Prompt Cycler :
- Prompts : une description de son par ligne.
- Durées : la durée en secondes de chaque ligne (dans ma liste, de 8 à 132 secondes).
- Noms de fichiers : un nom par son.
La ligne 1 de chaque liste appartient au son 1, la ligne 2 au son 2, et ainsi de suite. Gardez les trois listes de même longueur et dans le même ordre.
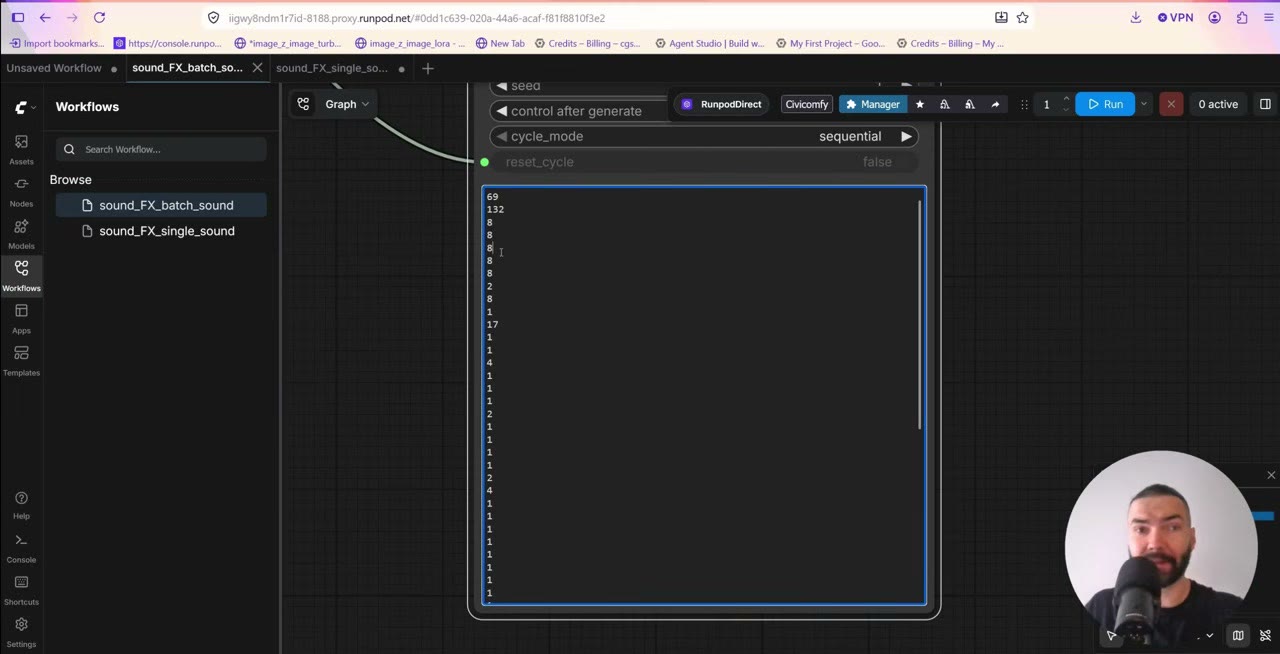
Le moyen le plus simple de remplir les listes est de demander à un chatbot (ChatGPT, Gemini ou Claude) les prompts, les durées et les noms de fichiers sous forme de trois listes propres, sans numérotation ni puces.
Mettez ensuite en file avec Run (Instant), ou réglez le nombre de lots sur le nombre de lignes. Un node d’aperçu montre quel prompt est en cours. Chaque son prend quelques secondes.
Réinitialiser le lot
La position dans le lot est conservée en mémoire. Pour repartir de la première ligne, ou après un redémarrage de ComfyUI :
- Mettez Cycle Reset à
trueet lancez une fois. - Remettez-le à
false. - Mettez de nouveau le lot en file.
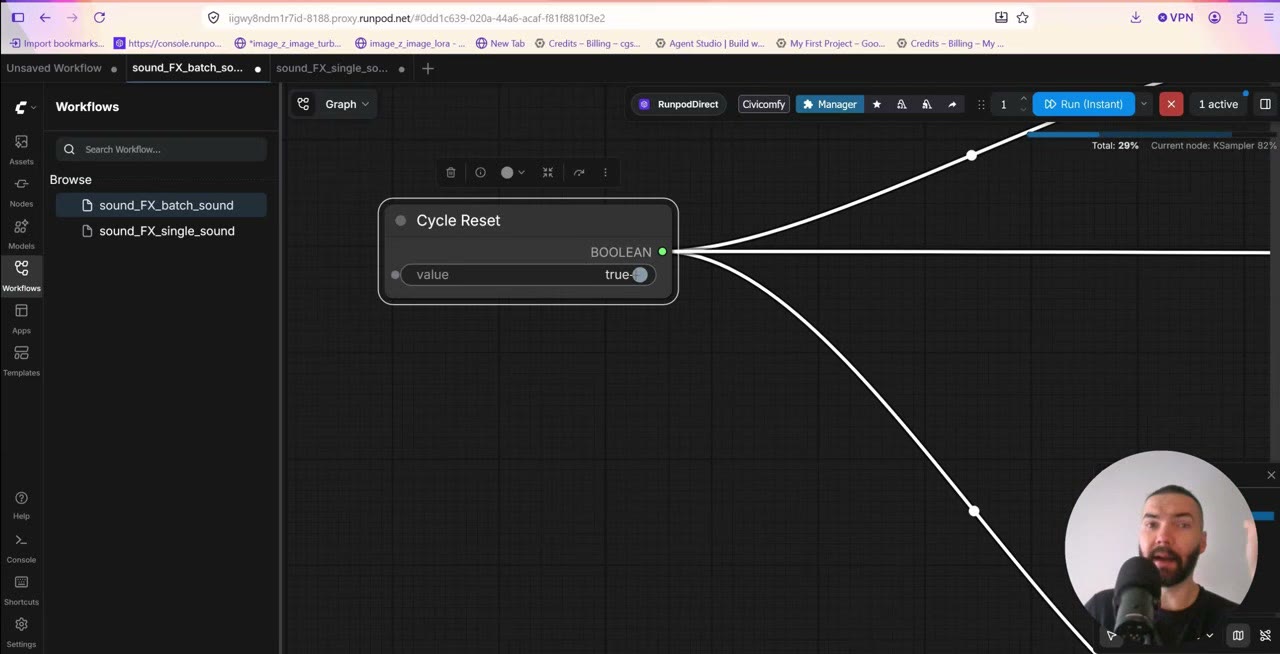
C’est un peu lourd, mais c’est l’approche la plus fiable que j’aie trouvée. Les listes reviennent aussi au début après la dernière ligne, ne mettez donc en file que le nombre d’exécutions égal à vos lignes, sinon le lot recommence.
Chaque fichier reçoit un numéro en suffixe, comme _00001. Je les renomme ensuite.
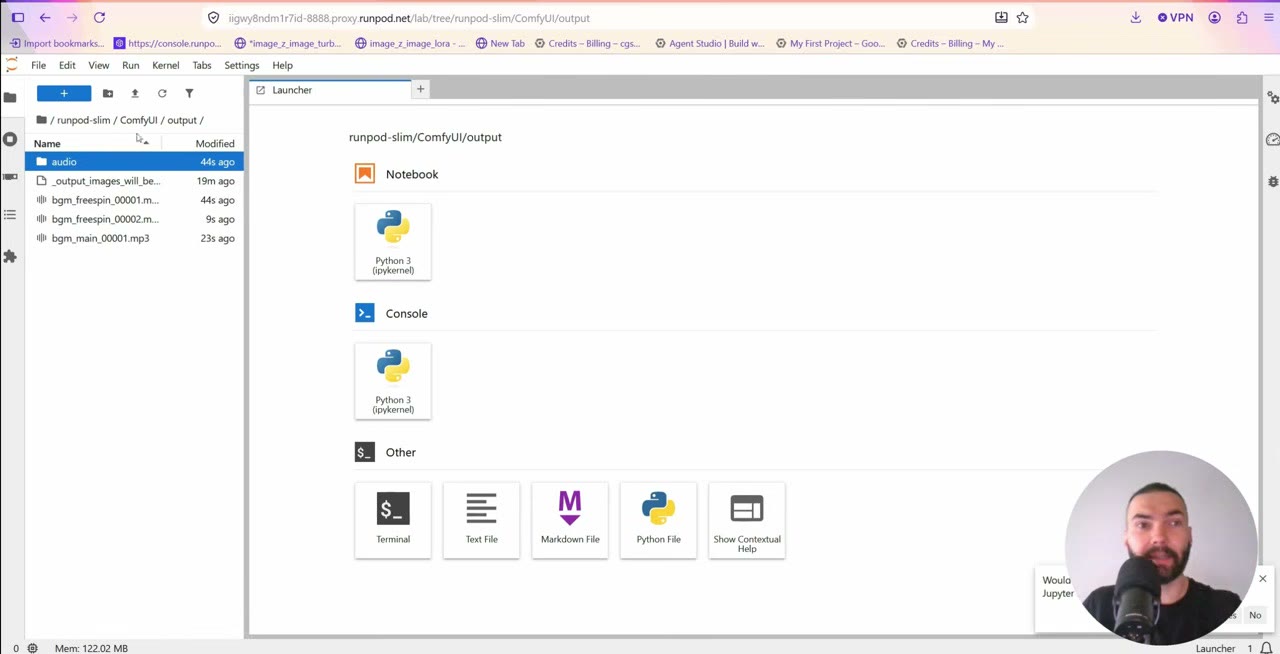
ComfyUI/output/audio, prêts à être téléchargés.Qu’en est-il de la qualité ?
Les résultats varient. Certains sons sont excellents, d’autres non, et la façon de rédiger le prompt change beaucoup de choses. Stable Audio 3 n’est pas le meilleur modèle audio disponible : je l’ai comparé à ElevenLabs, et parfois ils étaient au même niveau, parfois ElevenLabs était meilleur.
Ce que cette configuration vous apporte, c’est du volume et du contrôle : des centaines de sons avec vos propres noms et durées, sur votre propre GPU ou sur un GPU loué bon marché, et la liberté de refaire tout ce qui n’a pas convaincu.
Quand vous avez fini
Arrêtez le pod pour qu’il ne soit plus facturé, puis terminez-le : même le disque d’un pod arrêté coûte quelques centimes.
Le lien du template est un lien de parrainage RunPod, tout comme celui-ci : les nouveaux comptes inscrits avec Google reçoivent entre 5 et 500 $ de crédit après leurs 10 premiers dollars, et je touche une petite commission.
Voir la version vidéo (8:52)
Tout ce qui précède est aussi dans la vidéo, si vous préférez suivre à l’écran. La vidéo est en anglais.
Questions fréquentes
De quel GPU ai-je besoin pour Stable Audio 3 ?
De très peu. Le modèle pèse environ 9 Go et a tourné sans effort sur la carte que j'ai utilisée, avec environ 20 Go de VRAM. Une carte de 16 Go devrait suffire.
Quelle peut être la durée d'un effet sonore Stable Audio 3 ?
Vous réglez la durée en secondes. Ma liste par lots avait des durées de 8 à 132 secondes. Le modèle ne remplit pas toujours le temps : une demande de 6 secondes peut donner 4 secondes de son puis du silence.
Stable Audio 3 est-il aussi bon qu'ElevenLabs ?
Dans mes tests, ils étaient parfois au même niveau et parfois ElevenLabs était meilleur. L'avantage ici est de produire des centaines de sons sur votre propre GPU ou sur un GPU loué bon marché.
Pourquoi mon lot est-il reparti du premier son ?
La position dans le lot est conservée en mémoire. Après un redémarrage de ComfyUI, ou quand vous mettez en file plus d'exécutions que de lignes, il recommence. Mettez en file exactement autant d'exécutions que vous avez de lignes.

Anton Tenitsky est artiste 3D avec plus de 15 ans d'expérience en infographie, qui a travaillé avec Nickelodeon, Gameloft, Marvel Rivals et de nombreux autres clients. En savoir plus sur moi