AI画像は、特に全身ショットで、壊れた手や変な顔になることがよくあります。何百枚もあるときに、1枚ずつ直す方法は成り立ちません。このワークフローはバッチでそれを行います。フォルダを順に処理し、説明から手(と顔)を見つけ、その部分だけをFluxで高解像度に描き直して、修正した画像を保存します。
Fluxが必要なので、VRAMは最低12GBです。ときどき1枚を手作業で直すだけでいいなら、クラウドでも動く、よりシンプルな手のインペイントのワークフローをご覧ください。
ポイント
- 見つける: Florence 2が、テキストの説明から「hands」や「face」をマスクします。
- 直す: Impact PackのSEGS detailerがその部分を切り出し、512 pxで描画して、貼り戻します。
- 設定: 20ステップ、denoise 0.65〜0.7。
- 再実行を前提に: 良くない試行がかなりあります。最良のものを残してください。
- カスケード: 手を修正し、その画像を2つ目のdetailerに渡して顔を修正します。
手が壊れる理由と、これで直る理由
手が壊れるのは、たいてい解像度のせいで、モデルが描けないからではありません。顔の横に手がある、クローズアップのポートレートをレンダリングすれば、手は十分なピクセルを占めて、きれいに仕上がります。全身の画像では、同じ手が数ピクセルしかもらえず、余分な指はそこから生まれます。私のテスト画像では、顔は良く、手は良くありませんでした。
そこでワークフローは、レタッチャーと同じことをします。問題の箇所を切り出し、拡大し、詳細に描き直して、元に戻すのです。
ワークフロー1:フォルダ全体の1つの要素を直す
フォルダを読み込む
Load Image Batchにフォルダのパスを貼り付け、モードをincremental imageにして、実行のたびに次の画像を取り出します。プレビューノードが、どの画像を処理中かを表示します。
Florence 2で手を見つける
ComfyUI-Florence2パックがモデルローダーを提供し、初回の実行時にモデルが自動でダウンロードされます。私は**large(fine-tuned)**を使いました。baseのほうが速く、結果も良好だったので、次回はそちらを試すつもりです。
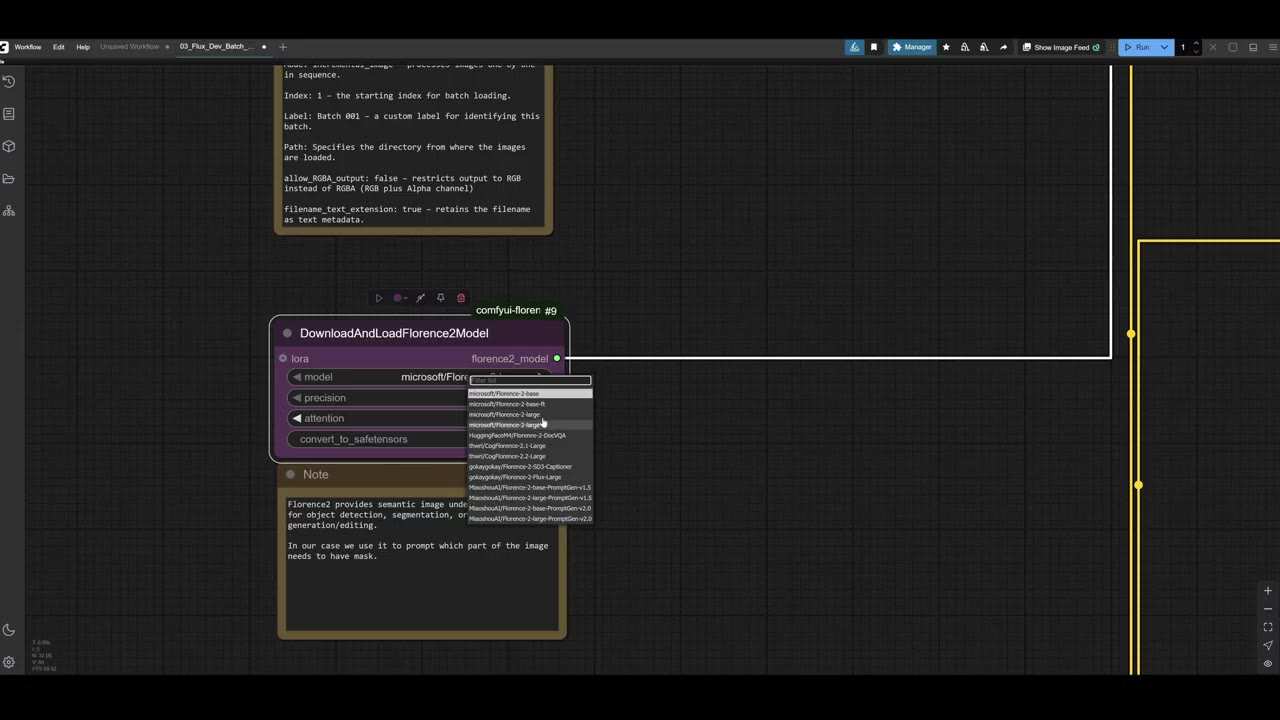
Florence 2ノードで、タスクをcaption to phrase groundingにして、見つけたいもの(ここでは「hands」)を入力します。Florence 2にはほかにも多くのこと(画像の記述、テキストの読み取り)ができますが、このタスクが、フレーズから領域を見つけ、そのマスクを返すものです。詳細はFlorence 2であらゆるものをマスクするで説明しています。
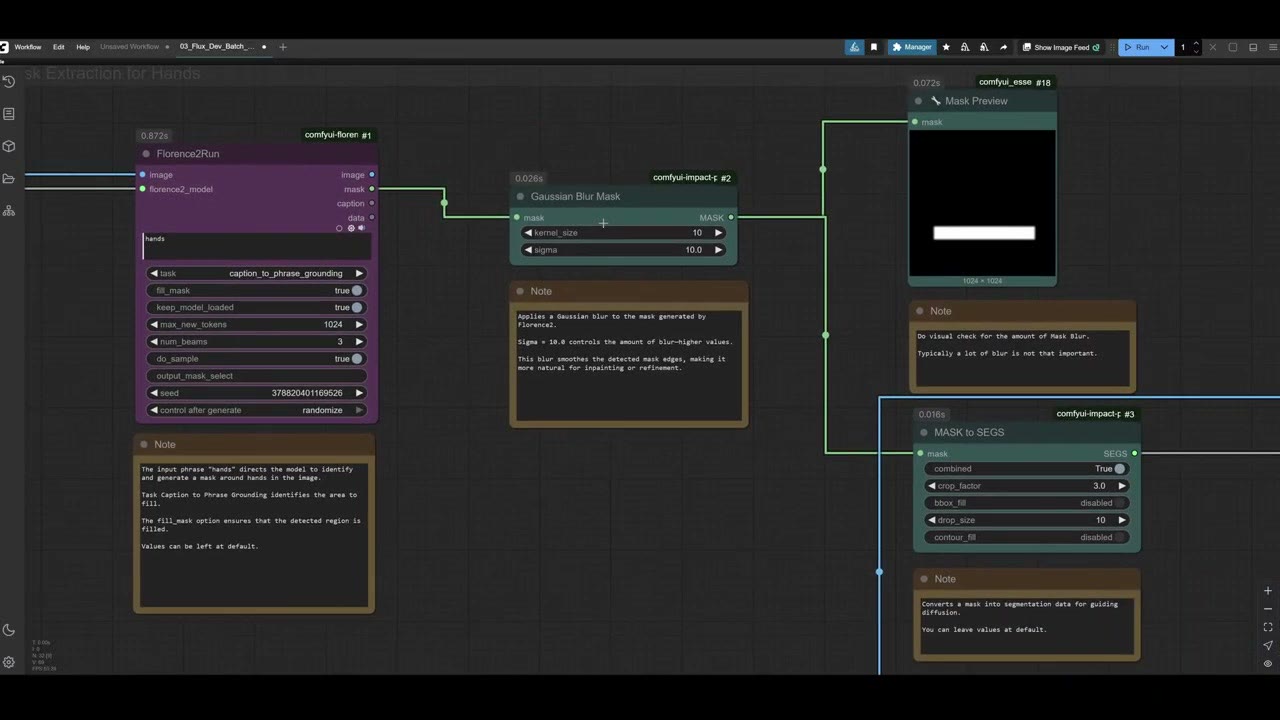
マスクをぼかして、セグメントにする
- Gaussian Blur Maskが、エッジを柔らかくします。エッジが硬いマスクは、目に見える継ぎ目を残すことがあるからです。
- Mask to SEGSが、マスクを、detailerが扱う形式のセグメントに変換します。
SEGS detailerで描き直す
Impact PackのDetailer (SEGS)ノードが、各セグメントを切り出し、比率を保ったままガイドサイズが512 pxになるように拡大します。これで手に使えるピクセルが大幅に増え、そこから改善が生まれます。
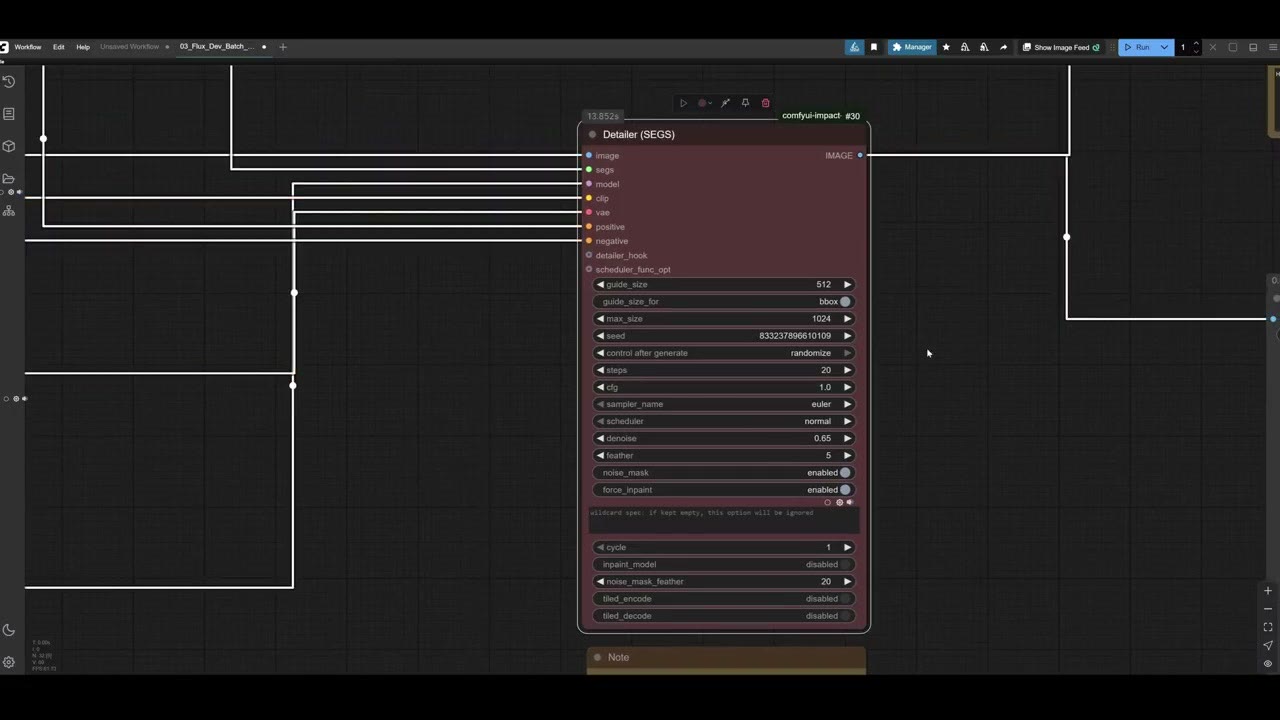
通常の生成と同じ入力を受け取ります。
- モデル: Flux dev、VAE、Fluxの2つのテキストエンコーダーを使うDualCLIPLoader。
- Flux Guidanceを通したポジティブプロンプト。私は「two hands, five fingers」のようなものを書きました。片手しか見えていなくても機能します。ネガティブは空のままです。
本当に重要な設定は2つだけです。
- Steps: 20。 20〜30で機能し、20で正直十分です。
- Denoise: 0.65〜0.7。 元の領域のどれだけを描き直すかを決めます。約0.5を下回ると、モデルはそこにランダムなもの(手の代わりに乗り物、別の顔など)を作ります。0.9では、同じ壊れた手が残ります。
比較して保存する
rgthreeのimage comparerが前後を表示し、結果が保存されます。修正された手は、少し小さくなることがありますが、あまり目立ちません。
何度か実行する前提で
ここが重要な点です。試行の6〜8割が良くない結果になることもよくあります。 繰り返し実行して、良いものを選び出してください。
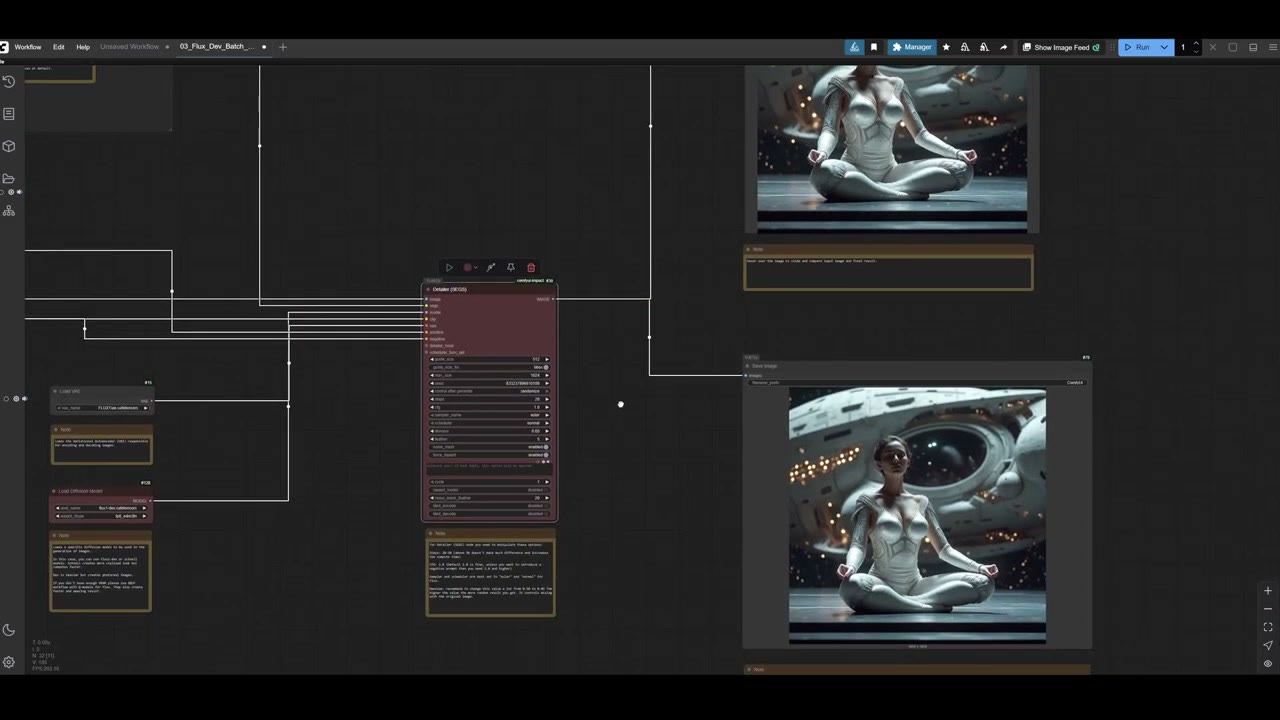
結果が意外なこともあります。ある画像ではマスクが誤作動して全身を覆ったため、detailerはすべてを描き直しました。手は隠すことで直し、顔と足は改善され、スーツのデザインもかなり変わりました。「person」のようなプロンプトなら、そうなるでしょう。別の画像では、手が以前より悪くなりました。実行を続けてください。
ワークフロー2:手、そして顔
顔も直すには、2つ目のdetailerをカスケードさせます。
- 最初のグループが上記のように手をマスクして修正します。
- その出力画像が、「face」を探す2つ目のマスク抽出と、2つ目のSEGS detailerに入ります。
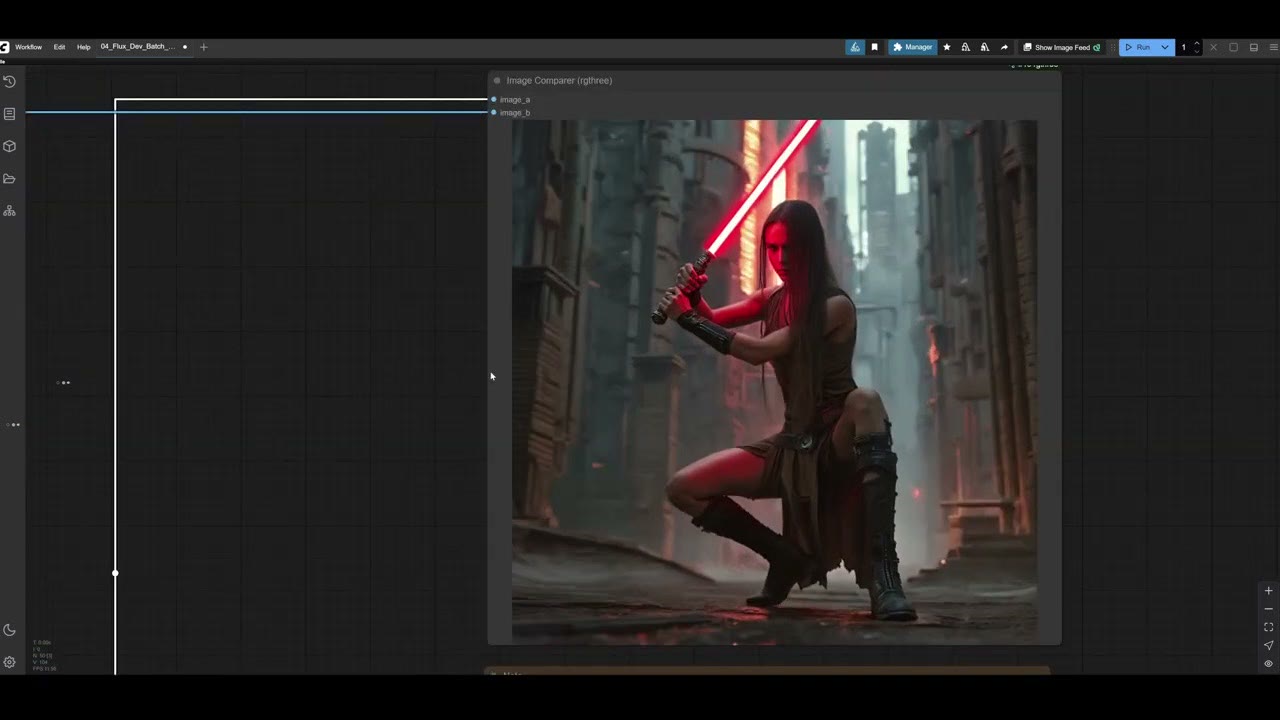
私のテストでは、顔は人間とは言い難いものから説得力のあるものになり、片方の手は素晴らしい出来でした(もう片方は、あと数回の実行が必要でした)。
モデルノードを重複させないでください。 モデルを読み込むノードはすべて、GPUメモリに保持します。Florence 2、Flux、テキストエンコーダー、VAEは1回だけ読み込み、すべてのdetailerに接続してください。重複すると、何のメリットもなくVRAMがすぐに埋まります。
カスケードは続けられますが(ブーツ、次に背景)、すぐに現実的でなくなります。意味があるのは手と顔です。
オプション:複数のフォルダを同時に
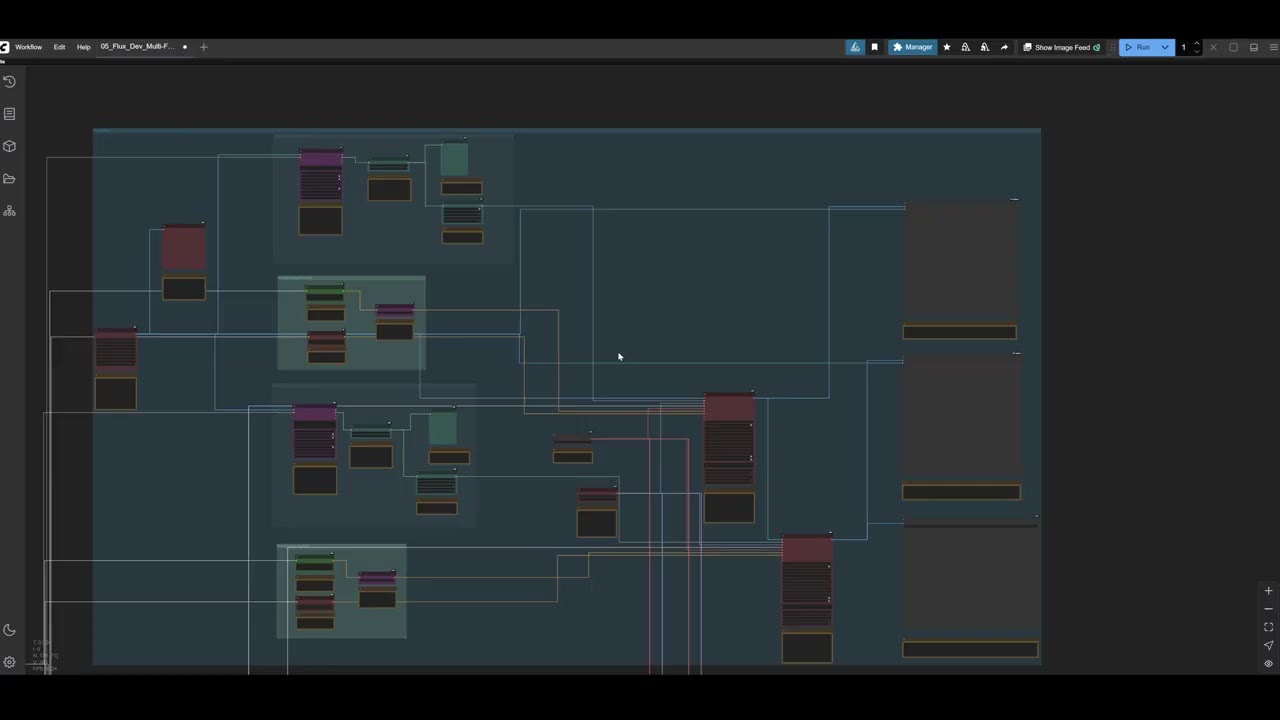
同じ修正を3つのフォルダに通す、バージョンも作りました。すべてが同じFlorence 2、Flux、テキストエンコーダー、VAEのノードを共有します。正直なところ、必要というよりテストに近いものです。ただ、異なるセット(中世、ファンタジー、SF)にそれぞれ別の修正をしたいなら、グループを複製して、それぞれに専用のLoad Image Batchを与え、共有のモデルに接続します。
すべてのワークフローは私のPatreonにあり、1回修正用のインペイントワークフローは、無料のお試し時間があるRunComfyにもあります。VRAMが12GBない場合は、借りたGPUでも動きます。RunPod入門をご覧ください。
RunComfyのリンクは紹介リンクで、私のRunPod紹介リンクも同様です。Googleでサインアップした新規RunPodアカウントは最初の10ドルの利用後に5〜500ドル分のクレジットを受け取れ、私には少額の紹介報酬が入ります。
動画版を見る (10:11)
上の内容はすべて動画でも説明しています。画面を見ながら進めたい方はこちらをどうぞ。 動画は英語です。
よくある質問
全身の画像で、AIが手や顔を間違えるのはなぜですか?
解像度のせいです。全身の画像では、手や顔に割り当てられるピクセルが少なくなります。同じモデルでも、クローズアップなら手をうまく描きます。修正方法は、その部分を切り出し、高解像度で描画して、貼り戻すことです。
手の修正には、denoiseをいくつにすべきですか?
0.65〜0.7あたりです。約0.5を下回ると、モデルはそこにランダムなものを作り出し、0.9では壊れた手がそのまま残ります。
修正はどのくらいの頻度でうまくいきますか?
毎回ではありません。私の実行では、6〜8割の試行が良くない結果になることも多くありました。何度か実行して、最良の結果を残してください。
VRAMはどのくらい必要ですか?
Fluxには最低12GBが必要です。各モデルは1回だけ読み込み、すべてのdetailerに接続してください。モデルノードを重複させると、そのたびにメモリを消費します。

Anton Tenitsky は コンピュータグラフィックスで15年以上の経験を持つ3Dアーティストで、Nickelodeon、Gameloft、Marvel Rivalsをはじめ多くのクライアントと仕事をしてきました。 プロフィールを見る