Les images IA sortent souvent avec des mains cassées et des visages étranges, surtout dans les plans en pied. Les corriger une par une ne marche pas quand on en a des centaines. Ce workflow le fait en lot : il parcourt un dossier, trouve les mains (et les visages) par description, rerend uniquement ces zones avec Flux en plus haute résolution, et enregistre l’image corrigée.
Il a besoin de Flux, donc de 12 Go de VRAM au minimum. Si vous ne devez corriger qu’une image de temps en temps à la main, mon workflow d’inpainting pour les mains, plus simple, tourne aussi dans le cloud.
En bref
- Trouver : Florence 2 masque « hands » ou « face » à partir d’une description textuelle.
- Corriger : le détailleur SEGS de l’Impact Pack découpe cette zone, la rend à 512 px et la recolle.
- Réglages : 20 étapes, denoise 0,65–0,7.
- Attendez-vous à relancer : beaucoup de tentatives ne sont pas bonnes ; gardez la meilleure.
- Cascade : corrigez les mains, puis passez cette image à un second détailleur pour le visage.
Pourquoi les mains se trompent, et comment cela y remédie
Les mains se cassent généralement à cause de la résolution, pas parce que le modèle ne sait pas les dessiner. Rendez un portrait en gros plan avec une main près du visage, et la main occupe beaucoup de pixels et sort bien. Dans une image en pied, la même main n’obtient que quelques pixels, et c’est de là que viennent les doigts en trop. Dans mon image de test, le visage était bon et les mains non.
Le workflow fait donc ce qu’un retoucheur ferait : il découpe la zone problématique, l’agrandit, la redessine en détail et la remet en place.
Workflow 1 : corriger un élément sur tout un dossier
Charger le dossier
Load Image Batch avec le chemin du dossier collé et le mode réglé sur incremental image, pour que chaque exécution prenne l’image suivante. Un node d’aperçu montre à quelle image il en est.
Trouver les mains avec Florence 2
Le pack ComfyUI-Florence2 fournit le chargeur de modèle ; le modèle se télécharge automatiquement la première fois que vous le lancez. J’ai utilisé large (fine-tuned) ; base est plus rapide et a aussi donné de bons résultats, c’est donc celui que j’essaierais la prochaine fois.
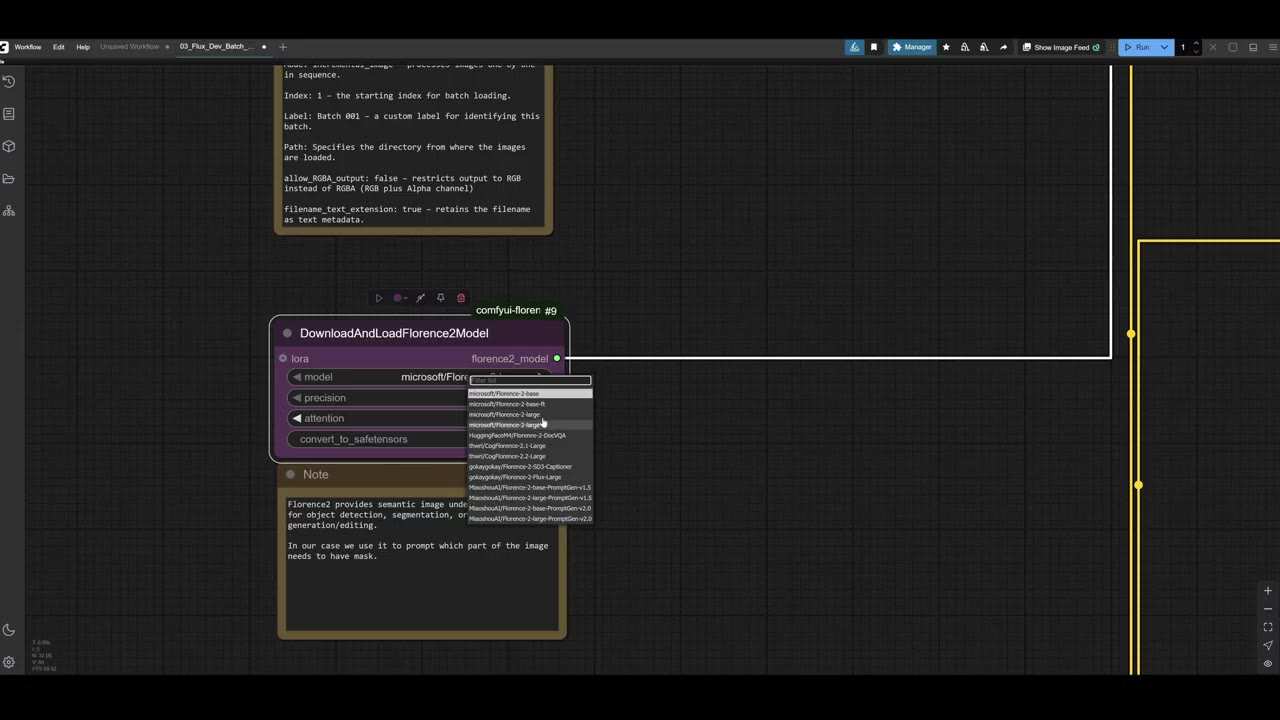
Dans le node Florence 2, réglez la tâche sur caption to phrase grounding et saisissez ce qu’il faut trouver, ici « hands ». Florence 2 peut faire bien plus (décrire une image, lire du texte), mais cette tâche est celle qui trouve une zone à partir d’une phrase et renvoie son masque. J’en parle plus en détail dans masquer n’importe quoi avec Florence 2.
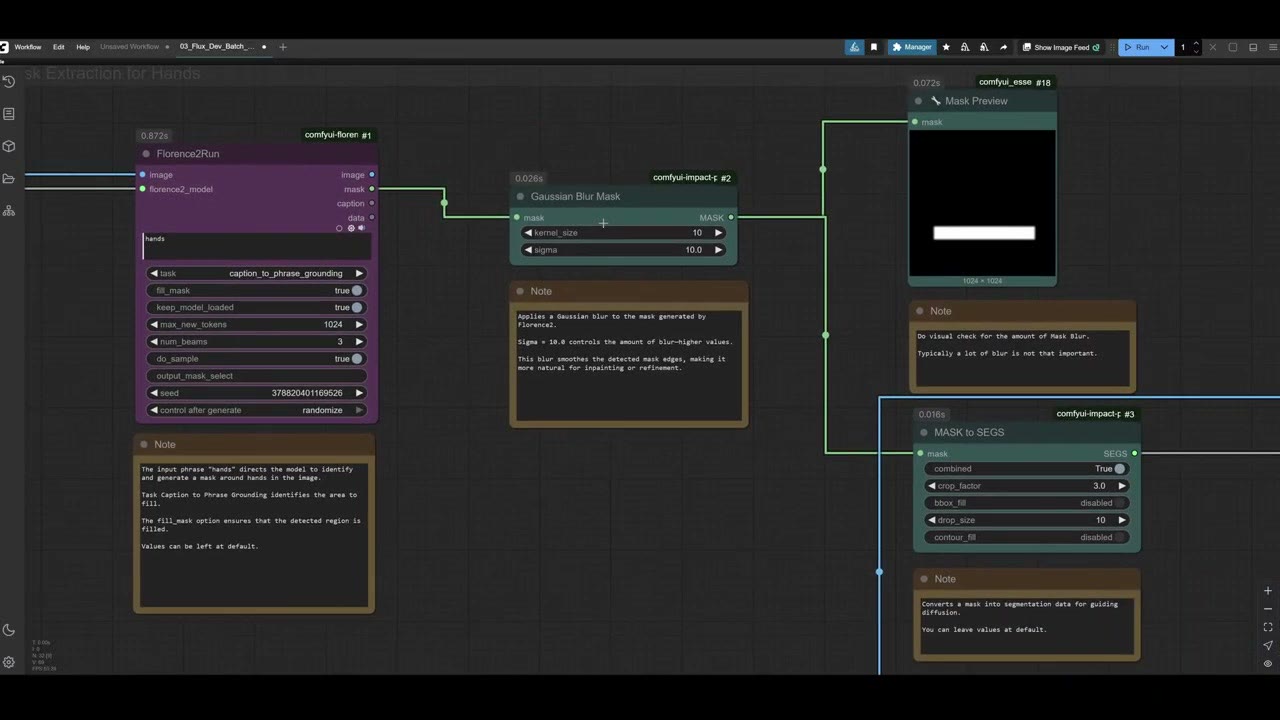
Adoucir le masque et en faire un segment
- Gaussian Blur Mask adoucit les bords, car un masque aux bords durs peut laisser une couture visible.
- Mask to SEGS transforme le masque en segment, le format avec lequel le détailleur travaille.
Rerendre avec le détailleur SEGS
Le node Detailer (SEGS) de l’Impact Pack découpe chaque segment et le met à l’échelle pour que sa taille de guidage soit de 512 px, proportionnellement. Cela donne à la main bien plus de pixels, et c’est de là que vient l’amélioration.
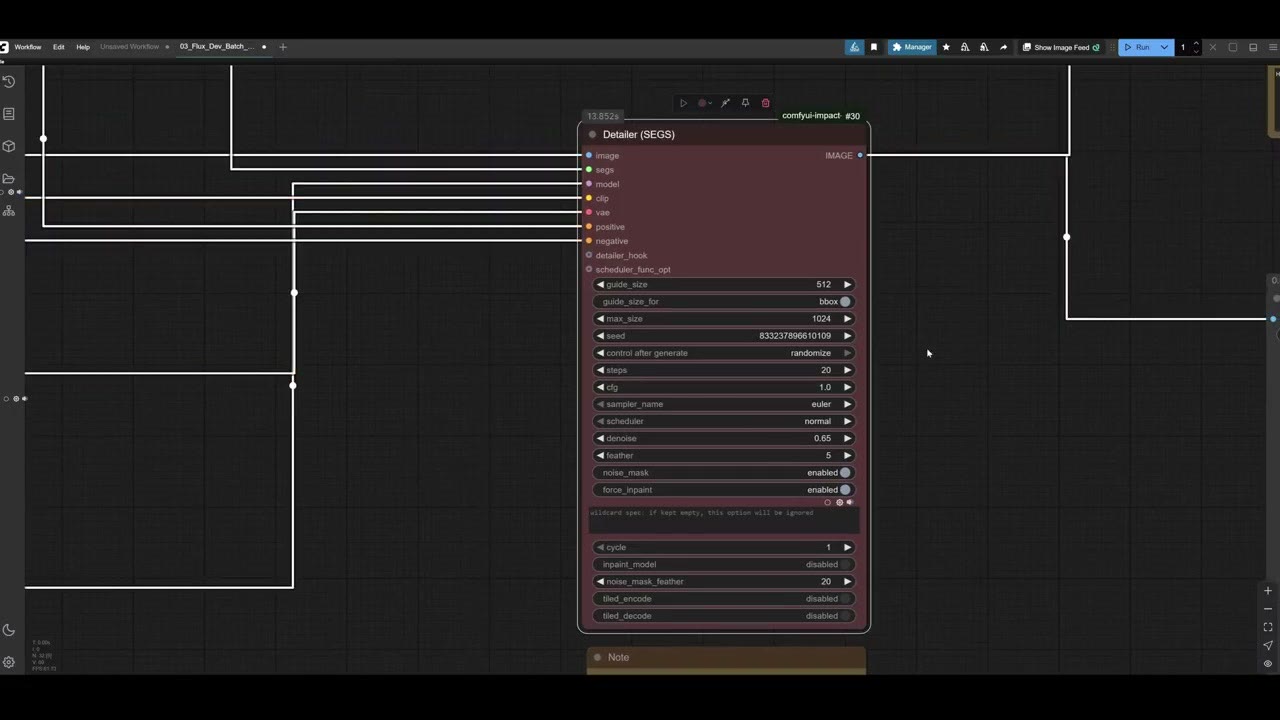
Il reçoit les mêmes entrées qu’une génération normale :
- Modèle : Flux dev, VAE et le DualCLIPLoader avec les deux encodeurs de texte de Flux.
- Prompt positif avec Flux Guidance. J’ai écrit quelque chose comme « two hands, five fingers » ; cela marche même quand une seule main est visible. Le négatif reste vide.
Seuls deux réglages comptent vraiment :
- Étapes : 20. De 20 à 30 convient, et 20 est honnêtement suffisant.
- Denoise : 0,65–0,7. C’est la part de la zone d’origine qui est redessinée. En dessous d’environ 0,5, le modèle crée quelque chose d’aléatoire à cet endroit (un véhicule à la place d’une main, ou un autre visage). À 0,9, il garde la même main cassée.
Comparer et enregistrer
Un rgthree image comparer montre l’avant et l’après, et le résultat est enregistré. Les mains corrigées sortent parfois un peu plus petites, même si ce n’est pas très visible.
Attendez-vous à lancer plusieurs fois
C’est la partie importante : souvent 60 à 80 % des tentatives ne sont pas bonnes. Lancez à répétition et choisissez les meilleures.
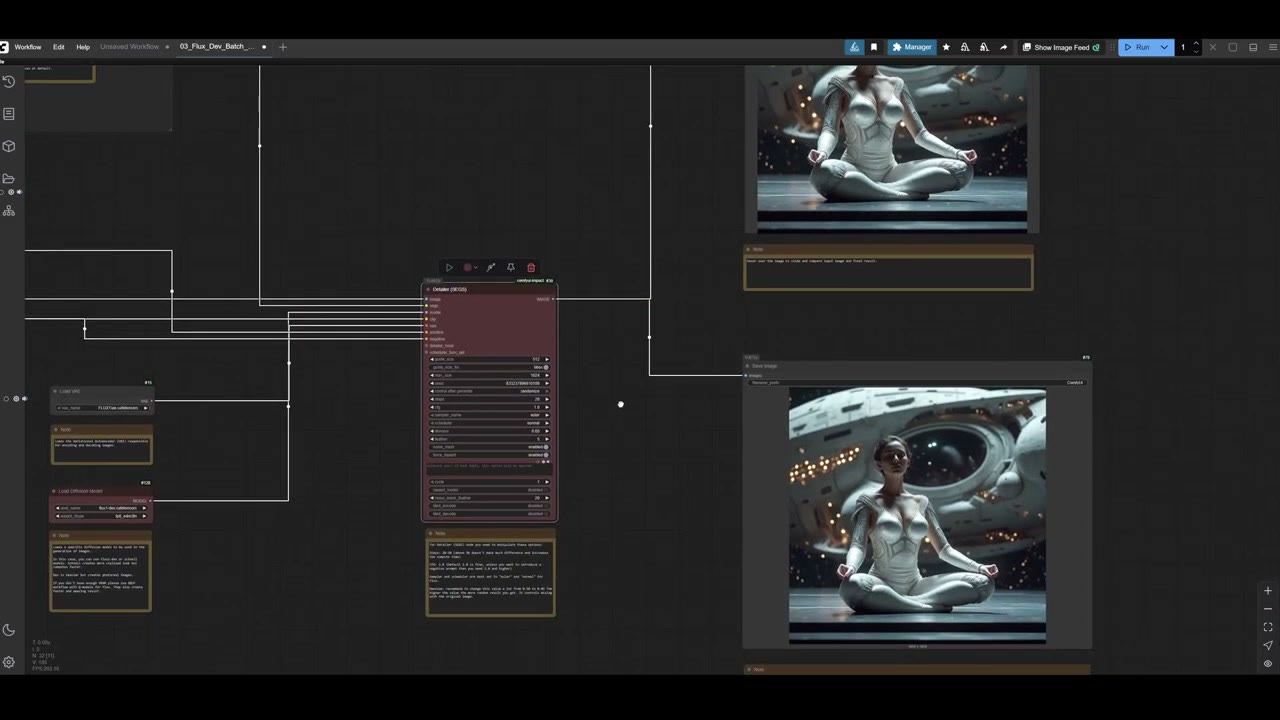
Parfois le résultat surprend. Sur une image, le masque a eu un défaut et a couvert toute la figure, si bien que le détailleur a tout redessiné : il a corrigé la main en la cachant, amélioré le visage et les pieds, et changé pas mal le design de la combinaison. C’est ce que vous obtiendriez avec un prompt comme « person ». Sur une autre image, les mains sont sorties pires qu’avant. Continuez à lancer.
Workflow 2 : mains, puis visage
Pour corriger aussi le visage, mettez en cascade un second détailleur :
- Le premier groupe masque les mains et les corrige, comme ci-dessus.
- Son image de sortie va dans une seconde extraction de masque, qui cherche « face », et un second détailleur SEGS.
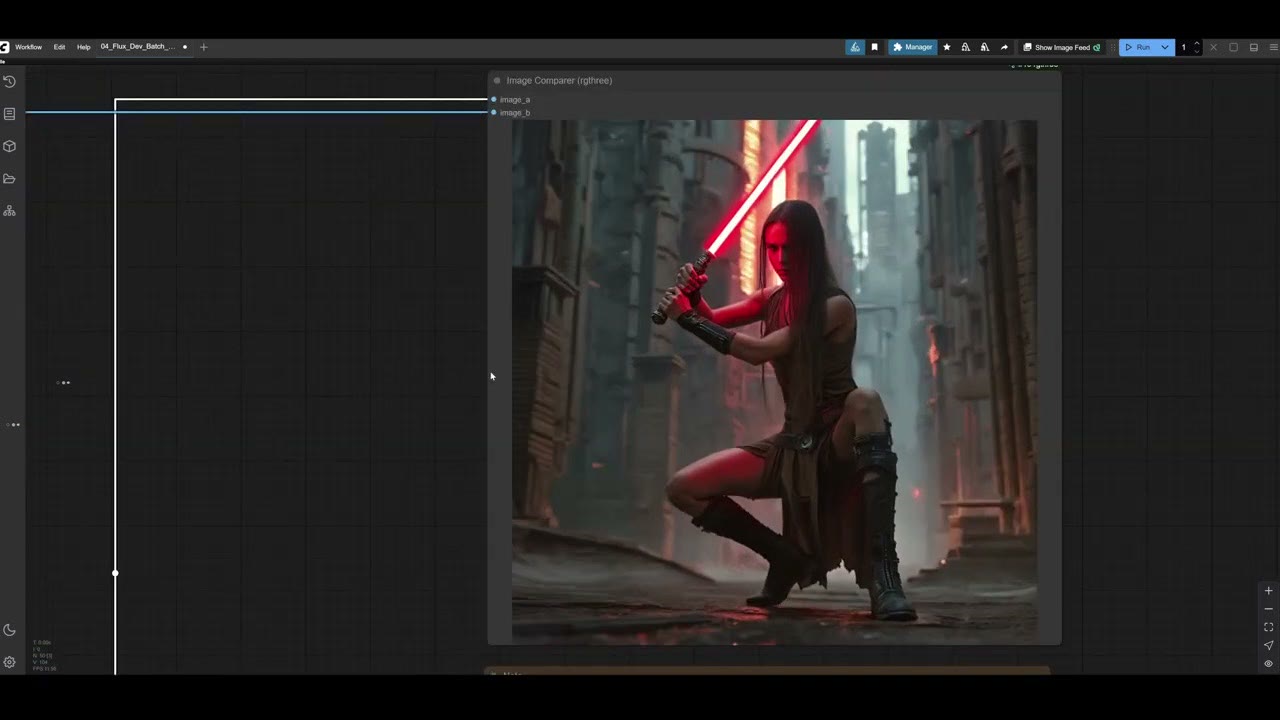
Dans mon test, le visage est passé de « pas tout à fait humain » à convaincant, et une main est sortie superbe (l’autre a demandé quelques exécutions de plus).
Ne dupliquez pas les nodes de modèle. Chaque node qui charge un modèle le garde dans la mémoire du GPU. Chargez Florence 2, Flux, les encodeurs de texte et le VAE une seule fois et connectez-les à chaque détailleur. Les doublons remplissent très vite votre VRAM sans aucun bénéfice.
Vous pouvez continuer à mettre en cascade (bottes, puis arrière-plan), mais cela devient vite impraticable. Les mains et les visages sont ce qui compte.
Optionnel : plusieurs dossiers à la fois
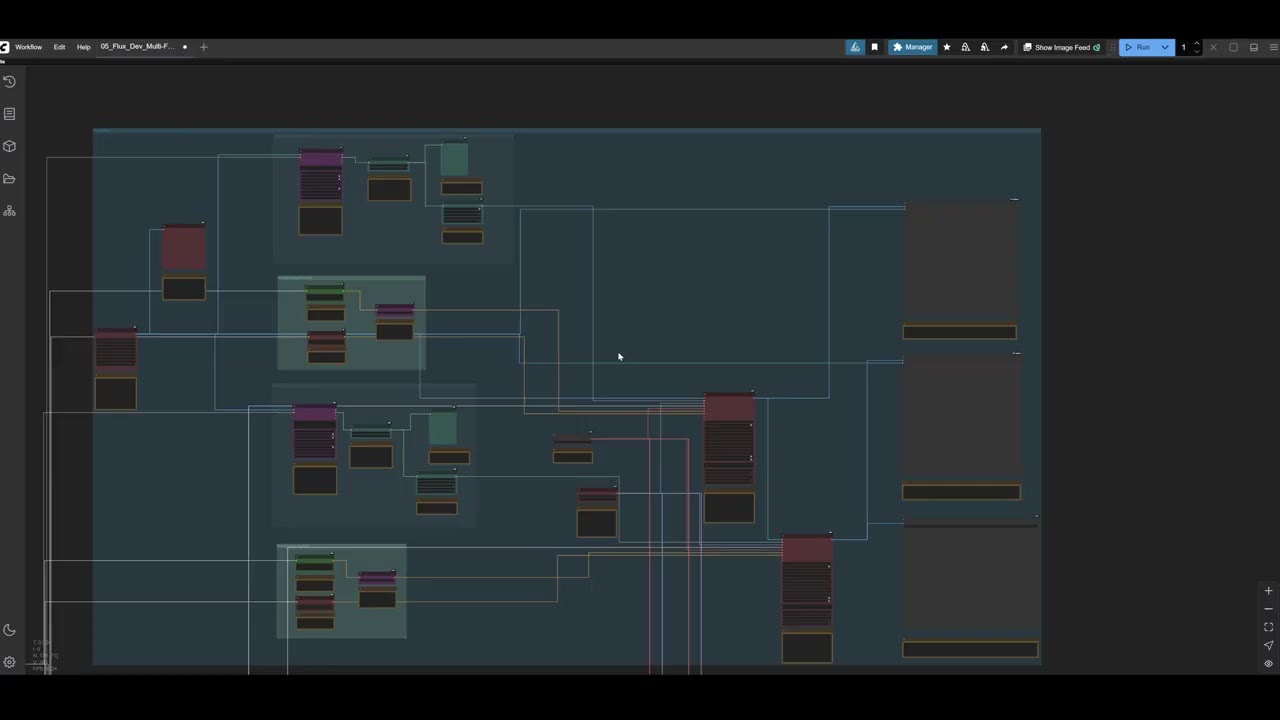
J’ai aussi construit une version qui fait passer trois dossiers par la même correction, tous partageant les mêmes nodes Florence 2, Flux, encodeur de texte et VAE. Honnêtement, c’est plus un test que quelque chose dont vous avez besoin. Mais si vous avez différents ensembles (médiéval, fantasy, science-fiction) avec des corrections différentes pour chacun, dupliquez les groupes, donnez à chacun son propre Load Image Batch et connectez-les aux modèles partagés.
Tous les workflows sont sur mon Patreon, et le workflow d’inpainting à correction unique est sur RunComfy avec des minutes d’essai gratuites. Si vous n’avez pas 12 Go de VRAM, un GPU loué fonctionne aussi ; voir mon introduction à RunPod.
Le lien RunComfy est un lien de parrainage, tout comme mon lien de parrainage RunPod : les nouveaux comptes RunPod inscrits avec Google reçoivent entre 5 et 500 $ de crédit après leurs 10 premiers dollars, et je touche une petite commission.
Voir la version vidéo (10:11)
Tout ce qui précède est aussi dans la vidéo, si vous préférez suivre à l’écran. La vidéo est en anglais.
Questions fréquentes
Pourquoi l'IA se trompe-t-elle sur les mains et les visages dans les images en pied ?
La résolution. Dans une image en pied, une main ou un visage ne reçoit que peu de pixels. Le même modèle rend bien les mains dans un gros plan. La solution est de découper cette zone, de la rendre en plus haute résolution et de la recoller.
Quel denoise utiliser pour corriger les mains ?
Autour de 0,65 à 0,7. En dessous d'environ 0,5, le modèle invente quelque chose d'aléatoire à cet endroit ; à 0,9, il garde la main cassée.
À quelle fréquence la correction fonctionne-t-elle ?
Pas à chaque fois : dans mes essais, souvent 60 à 80 % des tentatives n'étaient pas bonnes. Lancez plusieurs fois et gardez le meilleur résultat.
De combien de VRAM ai-je besoin ?
Au moins 12 Go pour Flux. Chargez chaque modèle une fois et connectez-le à chaque détailleur, car les nodes de modèle en double occupent chacun de la mémoire.

Anton Tenitsky est artiste 3D avec plus de 15 ans d'expérience en infographie, qui a travaillé avec Nickelodeon, Gameloft, Marvel Rivals et de nombreux autres clients. En savoir plus sur moi