AI画像の多くは、ほぼ正しい状態です。顔がずれている、袖が溶けている、手が間違っている。インペイントは、マスクした部分だけを描き直し、残りには触れません。このワークフローは、Flux DevとImpact PackのSEGS detailerでそれを行います。detailerは、マスクした領域を拡大してから描き直すので、小さな領域でも本物のディテールで戻ってきます。
このテクニックは、どんな被写体にも使えます。ここでは、スケッチから生成したキャラクター画像(Fluxでスケッチからアートへをご覧ください)を取り、顔、袖、脚、胴体、野球のバットと、部分ごとに直します。
ポイント
- Mask Editorで、柔らかいブラシ(hardnessをほぼゼロ)を使い、1つの領域をマスクします。
- MASK to SEGS → Detailer (SEGS): マスクした領域が512 pxに拡大され、Flux Devで描き直されて、元に溶け込まされます。
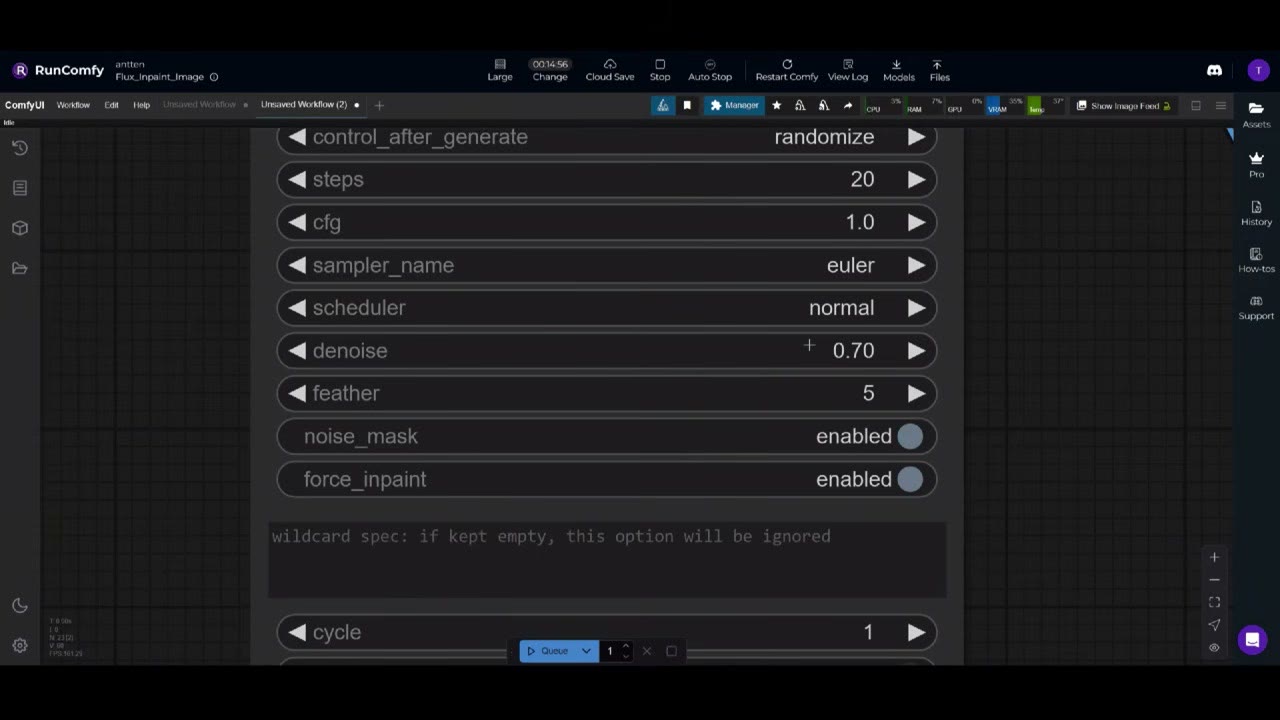
- 設定: Flux guidance 3.5、20ステップ、denoise 0.60〜0.70。
- 1回に1つの部分。 保存、ダウンロード、再アップロードして、次の部分をマスクします。
- 再実行を前提に: 顔で10〜15回は普通です。
各ノードの詳細と、最も難しい手のためのペイントオーバーのコツは、ComfyUIでAIの手を直すをご覧ください。このガイドは、同じ構成を画像全体に使う方法についてです。
ワークフロー
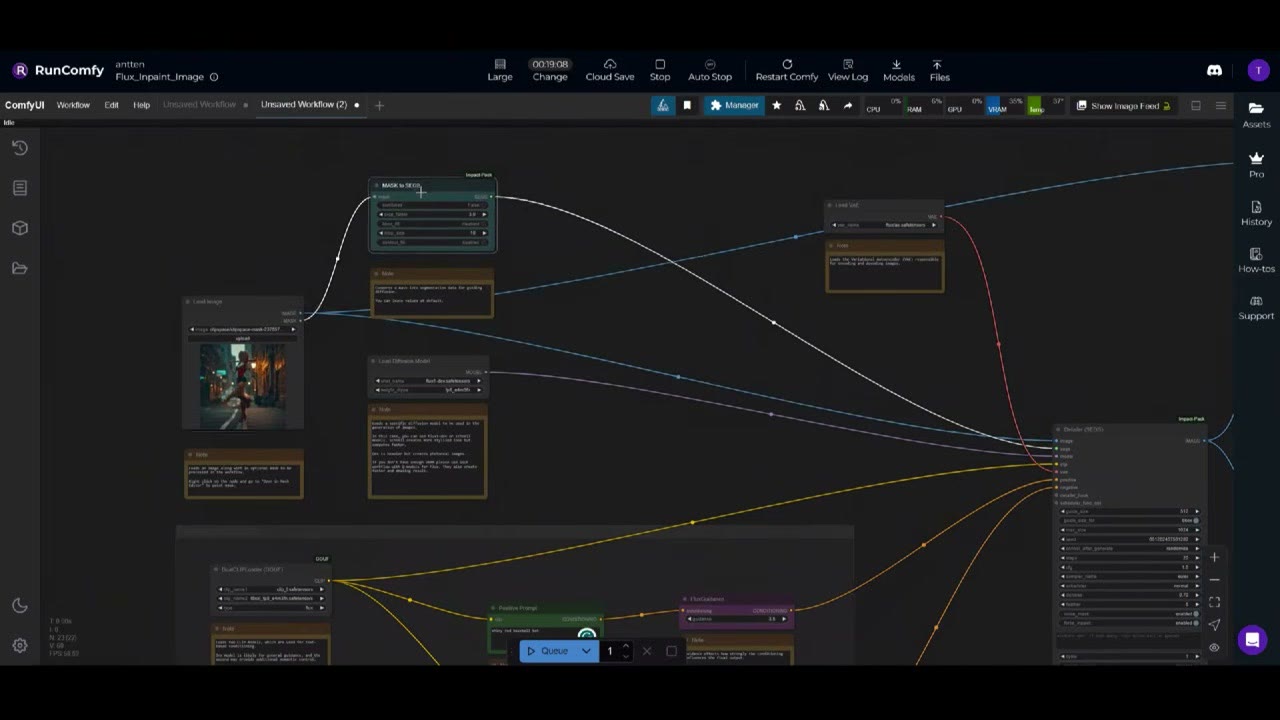
- Load Image: 直したい画像をアップロードします。右クリックしてOpen in Mask Editorを選ぶと、マスクを描けます。
- MASK to SEGS(Impact Pack)が、マスクをセグメントに変換し、その領域を切り分けて拡大できるようにします。
- **Detailer (SEGS)**が、すべてが集まる主要なノードです。わずか100 × 100ピクセルかもしれないマスクした領域を取り、512 × 512に拡大して、そこで描き直します。ピクセルが増えるほど、より良い結果を作れます。元の画像がガイドになるので、プロンプトはあまり要りません。そこにあるものをすでに読み取っています。セグメントだけでなく、元の画像も接続してください。
- Load Diffusion Model: 完全なFlux Devモデル。最初の生成は読み込みで約1分半かかり、その後は1回約16秒でした。
- Load VAE: Fluxの小さなオートエンコーダーで、latent空間から画像をデコードします。
- DualCLIPLoader: Fluxは2つのテキストエンコーダー、clip_lとt5xxlを必要とします。
- ポジティブプロンプト → FluxGuidance: Flux guidanceは、プロンプトが画像をどれだけ強く制御するかを決めます。3.5が標準で、よく機能します。ネガティブの入力も接続しますが、空のままにします。Fluxはネガティブプロンプトをうまく扱えないので、すべてをポジティブで記述します。
- 最後にImage ComparerとSave Image。
柔らかいマスクを描く
Mask Editorで、スライダーでブラシのサイズを設定し、hardnessをほぼゼロまで下げます。デフォルトは非常に硬く、硬いエッジは目に見える境界や継ぎ目を残します。領域の上を塗って、Saveをクリックします。
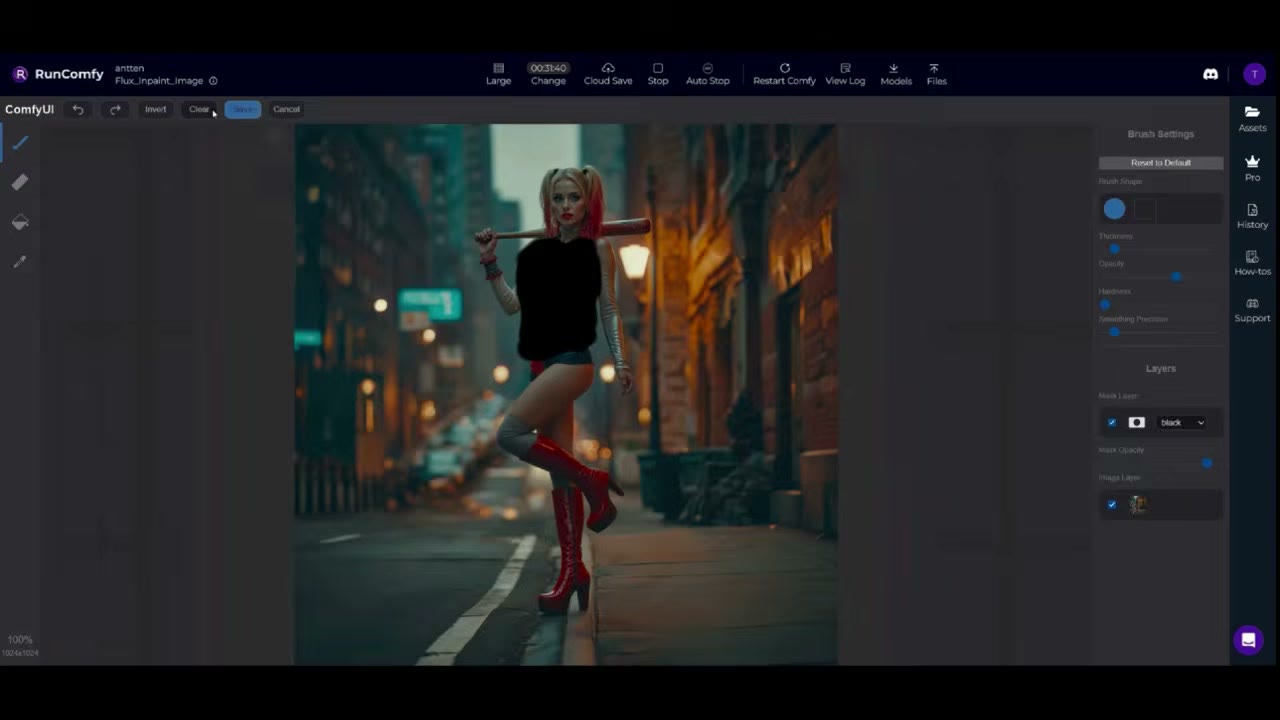
1回に1つの部分をマスクします: 腕、脚、ウエスト、胴体、顔、髪、バット。腕と脚を一度にやろうとすると、マスクが大きくなりすぎて画像を乱します。単にうまくいきません。
プロンプトと設定
プロンプトはとてもシンプルで構いません。顔には「young beautiful female face, red lips」と入力しました。ずっと何かを間違い続ける場合にだけ、ディテールを足します。
detailerでは次のとおりです。
- Seed: 実行ごとにランダム。画像を再現したいならseedを保持してください。同じプロンプトと設定で、他の人でもまったく同じ結果が得られます。
- Steps: 20。 通常の範囲は20〜50で、50を超えると効果が薄れます。Fluxはかなり遅いので、20なら高速で高品質です。
- CFG: 1.0。 guidanceはすでにFluxGuidanceノードから来ているので、CFGはここでは効果がありません。そのままにします。
- Denoise: 0.60〜0.70。 領域がどれだけ変わってよいかです。この範囲は、変えすぎも変えなさすぎもせず、モデルに十分な自由を与えます。数百、数千回の生成の後、実験でたどり着きました。
実行、保存、再アップロード、繰り返し
実行のたびに顔が変わるので、うまくいくまで再実行を続けます。結果はComfyUIのoutputフォルダに保存されます。保存ノードのファイル名プレフィックス(私はflux_genを使いました)で、見つけやすくなります。
次の部分に取り組むには、現在の結果を入力にする必要があります。私は画像をダウンロードして、Load Imageに再アップロードしています。(RunComfyの中で再利用するもっと良い方法をご存知なら、教えてください。)新しい画像をアップロードするとマスクが削除されるので、Mask Editorを開いて次の領域を塗ります。
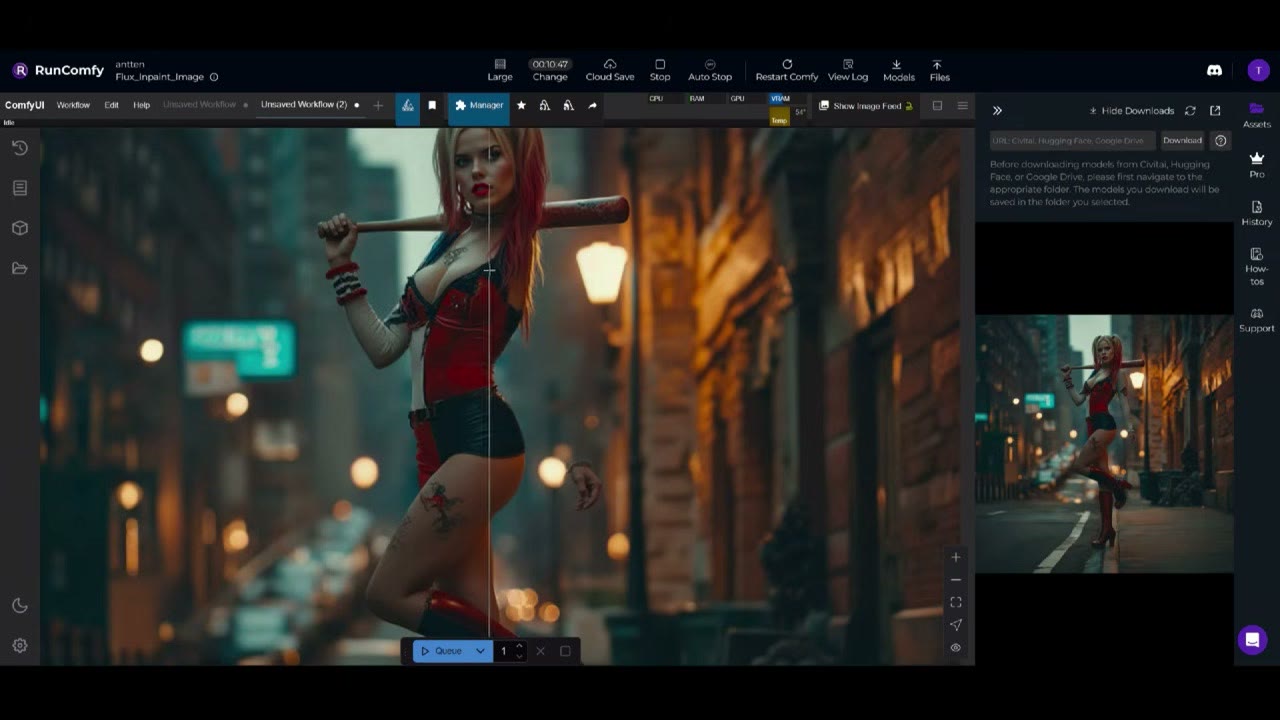
袖では、最初の試みは片側が良く、反対側が悪くなりました。マスクが少し大きすぎたのです。腕に沿った細いマスクのほうが良くなりましたが、頼んでいないタトゥーが付きました。より具体的なプロンプト(「white cotton sleeves」)が役立ちそうです。マスクが望まない部分まで捉えたときは、描き直す必要があることもあります。
画像全体がどう仕上がったか
- 脚:「smooth legs, high heels, red boots」。最初の生成が素晴らしい出来でした。
- 胴体と袖を一緒に: 大きなマスクで、問題が出ました。ウエストが腕と融合したので、別々のマスクに分けました。
- 腕だけ: 最初の試みでかなり良い出来に。狙った白銀ではありませんが、十分良好でした。
- 顔: 10〜15回の生成。
- 胴体とウエスト: さらに約10回の反復。
- 野球のバット: 本当に小さなマスクで、数回の反復。
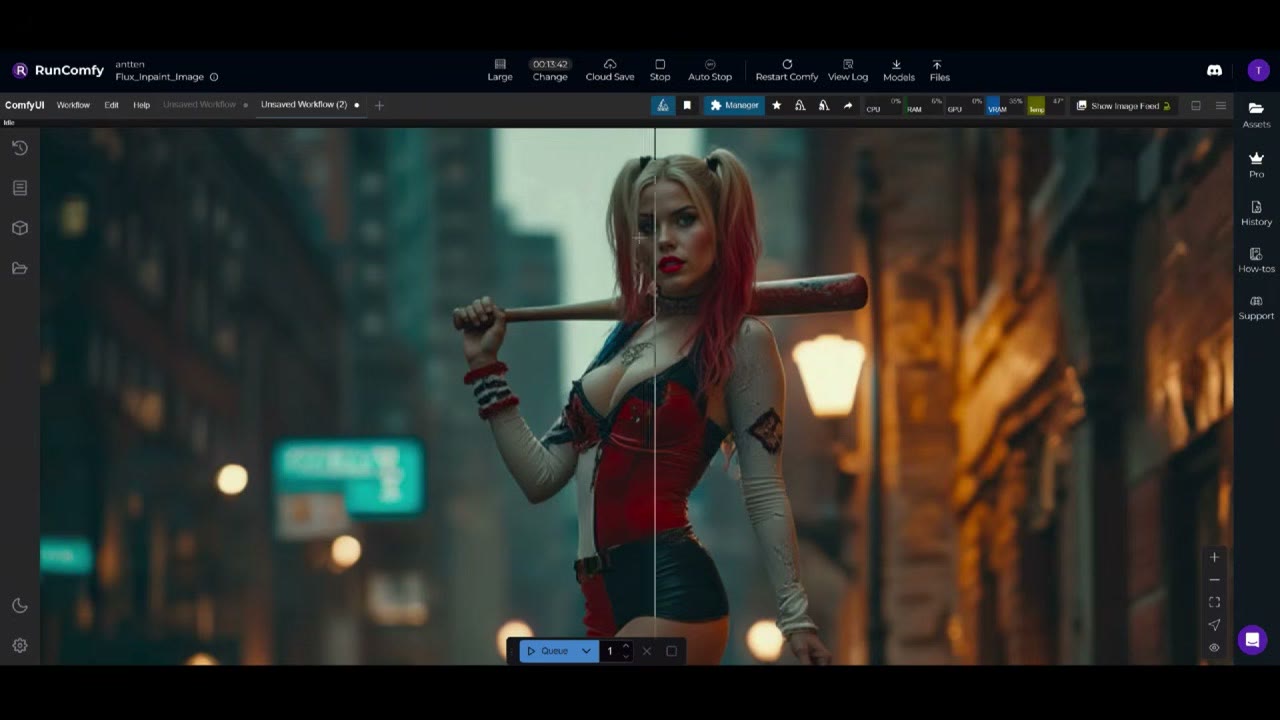
かなりの手間です。ダウンロード、再アップロード、再実行。画像の多くをやり直すと、1時間かかることもあります。顔と手だけなら、はるかに速くなります。
どこで動かすか
Flux Devには、強力なGPUが必要です。これは、ワークフローが設定済みで、約15分の無料枠で試せるRunComfyで録画しました。今は、この種の作業をRunPodで動かしています。RunPod入門をご覧ください。ワークフローは私のPatreonにもあります。
RunComfyのリンクは紹介リンクです。RunPodを試すなら、私の紹介リンクから、Googleでサインアップした新規アカウントは最初の10ドルの利用後に5〜500ドル分のクレジットを受け取れ、私には少額の紹介報酬が入ります。
動画版を見る (10:15)
上の内容はすべて動画でも説明しています。画面を見ながら進めたい方はこちらをどうぞ。 動画は英語です。
よくある質問
Fluxのインペイントには、denoiseをいくつにすべきですか?
0.60〜0.70です。モデルに、変えすぎも変えなさすぎもせずに領域を解釈できる十分な自由を与えます。数百回の生成を経てたどり着きました。
大きな領域をマスクすると、インペイントがおかしくなるのはなぜですか?
複数の部分(腕、胴体、脚を一度に)を覆う大きなマスクは、モデルに変更させるものが多すぎて、画像を乱します。小さく柔らかいマスクで、1つの部分ずつ作業してください。
Fluxにネガティブプロンプトを書くべきですか?
いいえ。Fluxはネガティブプロンプトをうまく使いません。欲しいものをポジティブプロンプトで記述し、シンプルに保ち、ずっと間違い続ける場合にだけディテールを足します。

Anton Tenitsky は コンピュータグラフィックスで15年以上の経験を持つ3Dアーティストで、Nickelodeon、Gameloft、Marvel Rivalsをはじめ多くのクライアントと仕事をしてきました。 プロフィールを見る