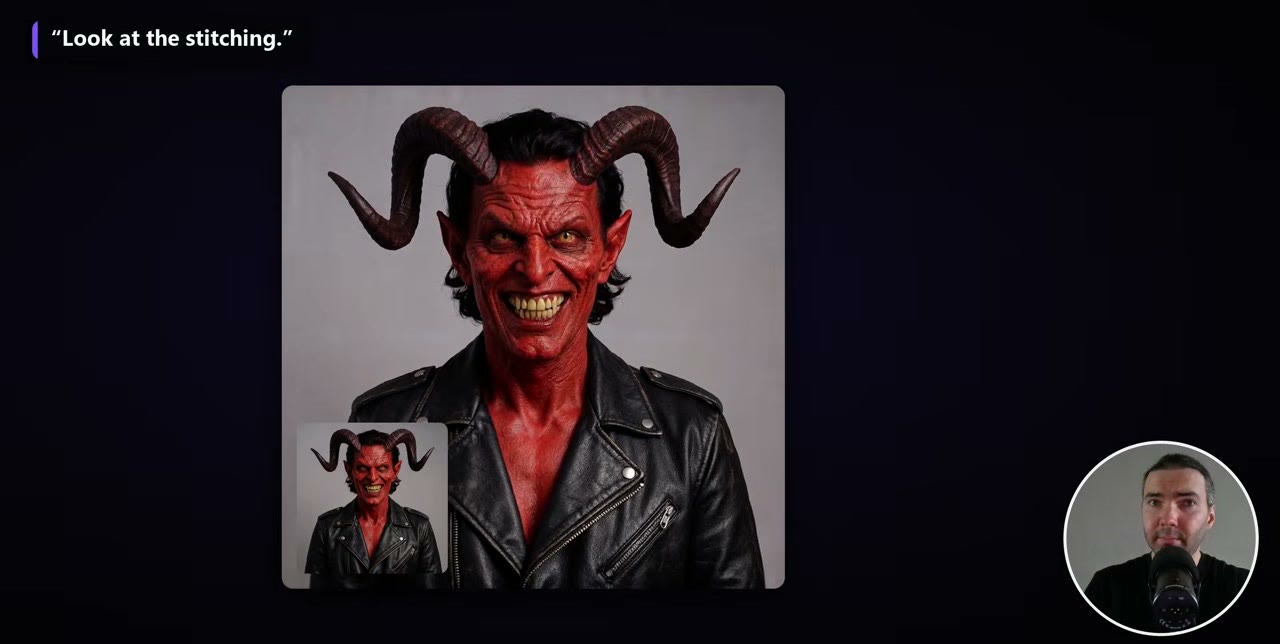
Status: Testado no RunPod. Usei este template no RunPod para trabalhos longos de avatares, rodando em várias GPUs ao mesmo tempo.
Este fluxo transforma uma foto e uma locução em um avatar falante com sincronização labial, e mantém o rosto igual do começo ao fim, seja o vídeo de 30 segundos ou de 50 minutos. Ele roda o LTX-2.5, o modelo de vídeo e áudio da Lightricks, que o ComfyUI suporta nativamente.
Tudo está no GitHub: o fluxo, um pequeno pacote de nós e o script de instalação. Você pode rodar localmente de graça se tiver a GPU; o script de instalação lista todos os modelos a baixar, e um chatbot pode transformá-lo em comandos de instalação para sua máquina. Eu rodei no RunPod porque podia colocar cinco ou seis GPUs ao mesmo tempo em um projeto.
Em resumo
- Entrada: um retrato e uma locução de até cerca de 60 minutos.
- GPU: recomendo uma RTX 5090 (32 GB).
- Resolução: cerca de 0,9 megapixel é o ponto ideal. Menos que isso e os lábios começam a grudar.
- Como funciona: o áudio é cortado nas pausas em trechos de 3–12 segundos; cada trecho começa e termina no seu retrato; um script os une com seu áudio original.
- Trabalhos longos são retomados após uma parada, no mesmo pod ou em outro.
O que você precisa
- Um retrato: uma foto nítida, de frente.
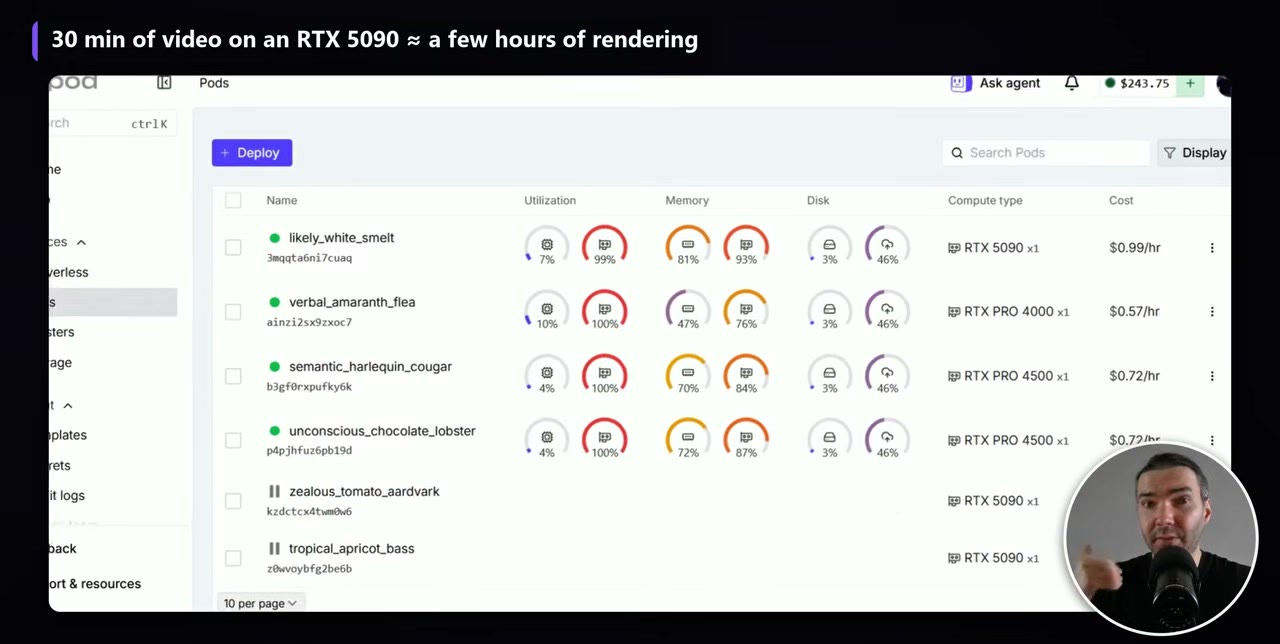
- Uma locução de até cerca de 60 minutos. Para algo mais longo, divida. Mesmo assim, eu manteria as partes em cerca de 30 minutos: 30 minutos de vídeo levam algumas horas para renderizar em uma RTX 5090.
- Uma GPU com 32 GB de VRAM, ou uma conta no RunPod.
- 80 GB de armazenamento. Os modelos principais somam cerca de 39 GB, ou cerca de 47 GB com o aprimorador de prompt e o upscaler temporal opcionais.
Uma dica para as entradas: novas contas do Google Cloud recebem US$ 300 em créditos gratuitos (não é um link de indicação). Fiz o retrato desta demonstração com o modelo de imagens Nano Banana do Google e a locução com o texto para fala do Google, tudo com esses créditos. A voz é tão barata que US$ 300 cobrem uma quantidade enorme; imagens custam mais. Para milhares de imagens, meu template Z-Image é o caminho mais barato.
Configure o pod
Minha introdução ao RunPod cobre o básico. Para este template:
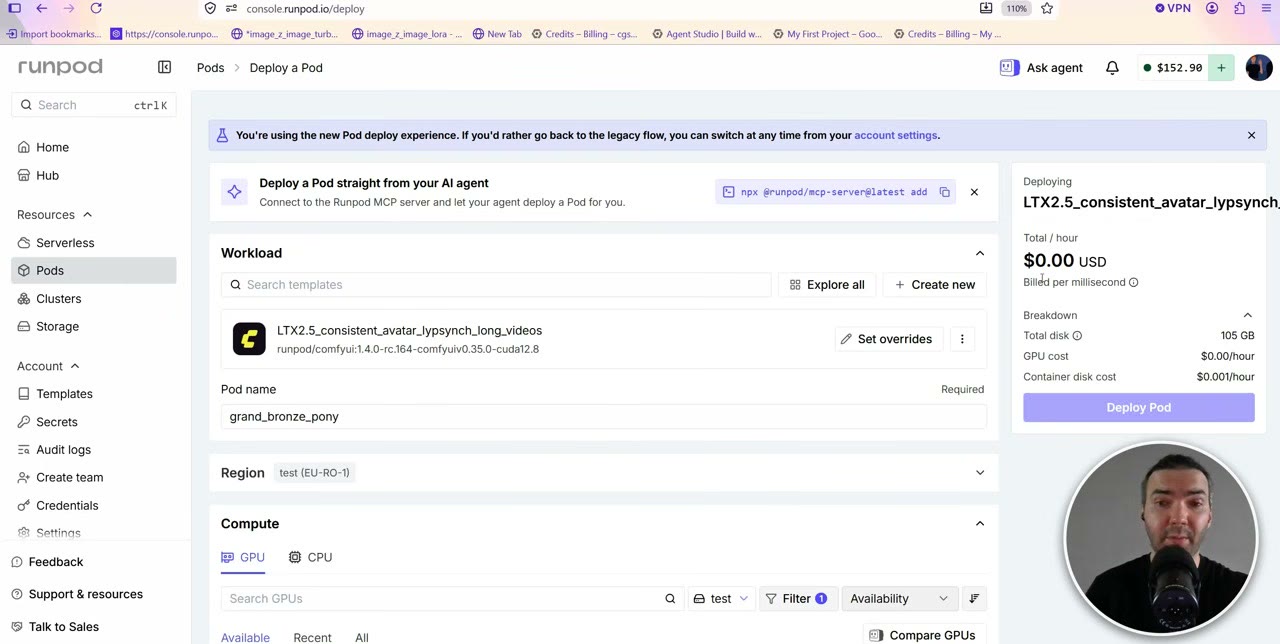
- Crie um volume de rede de cerca de 100 GB em um data center com muitas GPUs. Você pode aumentá-lo depois, e ele é cobrado por hora enquanto existir, cerca de US$ 7 por mês nesse tamanho no armazenamento padrão.
- Implante o template. Abra o link do template, ou busque nos templates públicos por «LTX 2.5 consistent avatar». Anexe seu volume.
- Escolha uma GPU. Recomendo uma RTX 5090. Uma RTX 4500 funciona, mas é lenta.
- Espere a primeira inicialização, de 10 a 15 minutos enquanto baixa os modelos. As inicializações seguintes no mesmo volume são bem mais rápidas.
Opcional, mas recomendado: os pesos oficiais do LTX-2.5 no Hugging Face são protegidos por licença. Aceite a licença na página do modelo, crie um token de leitura nas suas configurações do Hugging Face e adicione-o ao pod como a variável de ambiente HF_TOKEN. Sem ele, o template recorre a um espelho público, mas downloads anônimos têm limite de taxa e o download de mais de 40 GB pode ficar lentíssimo.
Quando estiver pronto, o menu Connect do pod mostra o ComfyUI e o JupyterLab. O JupyterLab às vezes diz «initializing» quando já está funcionando, então é só abri-lo.
O fluxo
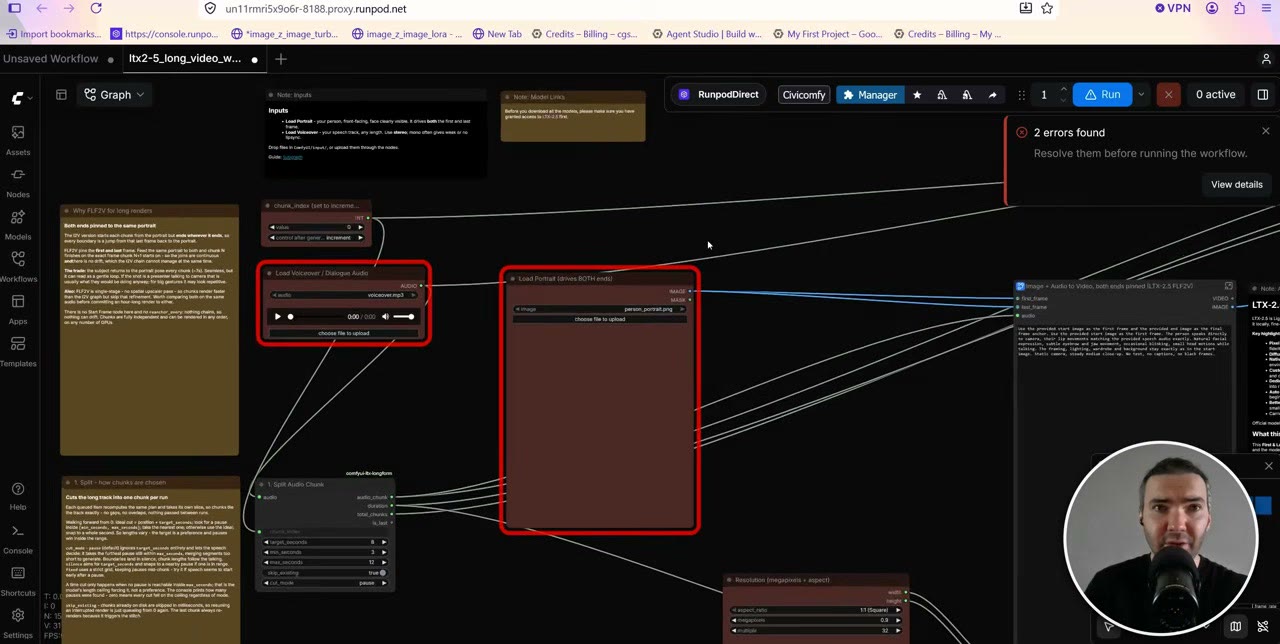
O template instala um fluxo na barra lateral Workflows do ComfyUI: ltx2-5_long_video_workflow. Parece simples na superfície; a mecânica está dentro de um subgrafo que você pode abrir com duplo clique. Não precisa mexer nele. Os nós que você ajusta são os contornados em vermelho.
1. Entradas
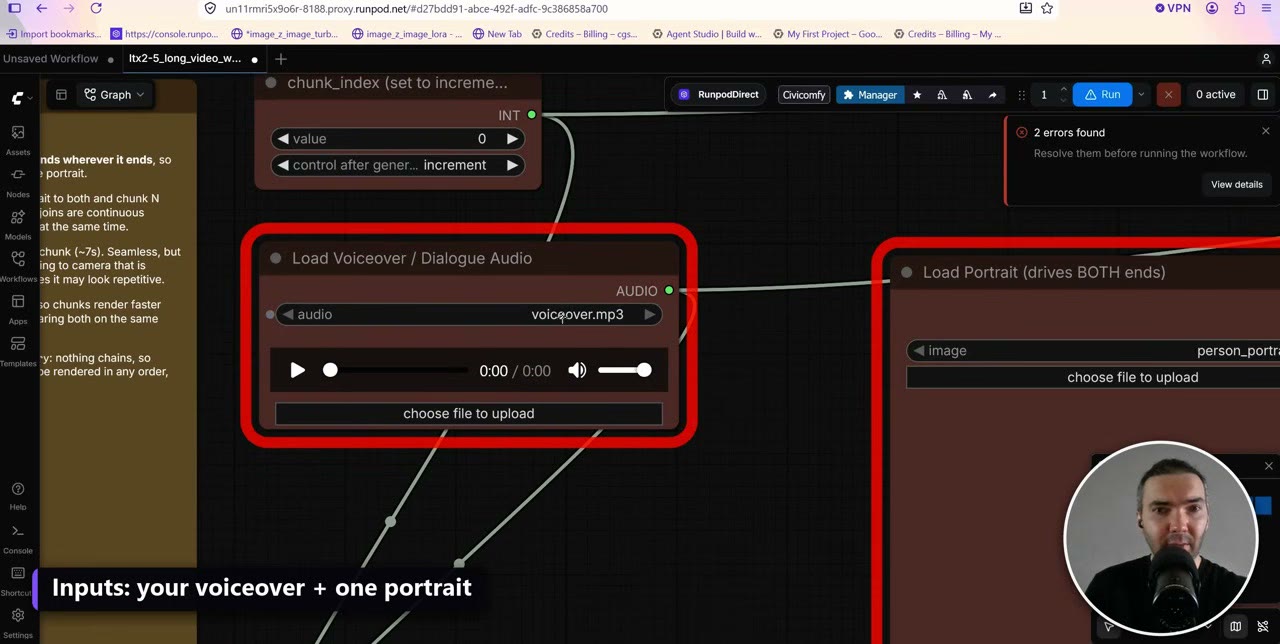
Carregue sua locução e seu retrato nos dois nós de entrada vermelhos. Depois de enviar um arquivo novo pelo JupyterLab, recarregue o ComfyUI para que ele apareça nos menus suspensos.
2. Prompt
O fluxo vem com um prompt neutro de pessoa falando para a câmera: a pessoa fala e olha para a câmera sem movimentos estranhos. Você pode escrever o seu, mas o padrão serve para vídeos no estilo apresentador.
3. Resolução
O nó de resolução trabalha em megapixels, com uma proporção. Eu renderizava principalmente quadrados em 0,9 megapixel. Se você sempre renderiza em widescreen, mude uma vez e salve o fluxo, ou desligue a opção de megapixels e digite as dimensões exatas.
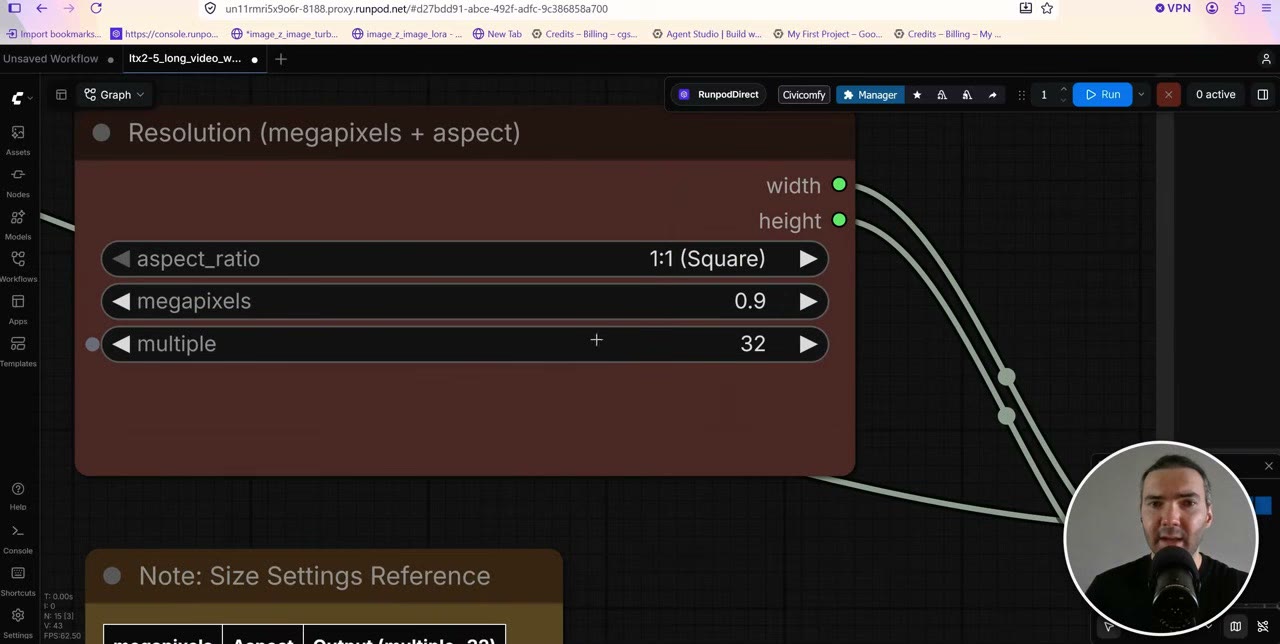
A resolução afeta a boca mais do que qualquer outra coisa. Em torno de 500 × 500, e mesmo em 600 ou 700 pixels quadrados, a qualidade cai de uma forma específica: os lábios grudam e a boca quase não se mexe. 0,9 megapixel é o ponto ideal para mim. Maior fica ainda melhor, mas demora mais.
Como ele mantém o rosto consistente
O LTX-2.5 só consegue gerar cerca de 10–12 segundos por vez. Force mais e ele se desvia em falhas. Então o fluxo faz três coisas.
O primeiro e o último quadro são sempre o seu retrato. Cada trecho começa e termina na mesma imagem, com a mesma expressão neutra. O avatar fala, volta ao neutro e recomeça, o que parece natural para um apresentador. Como as duas pontas são fixas, o rosto não consegue se desviar em um vídeo longo. (É possível usar últimos quadros diferentes, mas aí você está fazendo um filme, que é outro trabalho.)
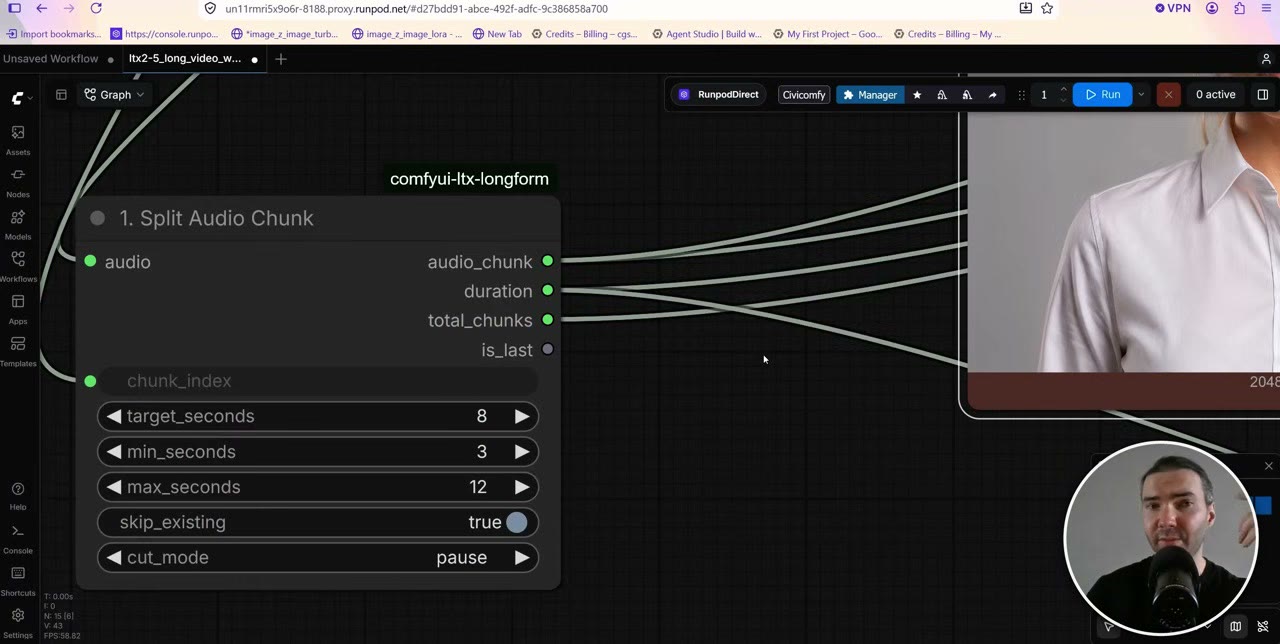
O áudio é cortado nas pausas. O nó Split Audio Chunk procura lacunas na fala e corta ali, mirando 8 segundos, nunca menos de 3 nem mais de 12. Um trecho de 7 segundos entre duas pausas vira um trecho de 7 segundos.
Um script reúne tudo. A saída «image» do fluxo é enganosa: o resultado é um vídeo. Um script de união que acompanha o template junta os trechos, apara o quadro extra que o LTX adiciona a cada um (senão o áudio desliza cerca de 2 segundos em 7 minutos) e coloca seu áudio original sobre o resultado, em vez da reconstrução feita pelo modelo.
Há um artefato que vale conhecer: em cada emenda, o padrão de ruído muda um pouco. É visível se você procurar. Eu aceitei conviver com isso em vídeos de apresentador, mas é a principal coisa que o MiniMax H3 melhorou.
Saída e nomes de arquivo
Tudo vai para a pasta output do ComfyUI: uma pasta de trechos e o vídeo pronto. Por padrão, o nome do seu arquivo de áudio vira tanto a pasta do projeto quanto o nome do vídeo final, então avatar-female-2.mp3 dá uma pasta de trechos avatar-female-2 e um vídeo final com o mesmo nome. Quando você renderiza cem arquivos, isso é bem mais fácil que sessões numeradas. Se preferir nomear as sessões você mesmo, desconecte a entrada de nome e digite um nome de sessão.
Execute, e o que fazer quando travar
Enfileire com Run (Instant) e mantenha o console aberto: ele informa quantos trechos há e em qual está. O primeiro trecho demora mais enquanto os modelos carregam.
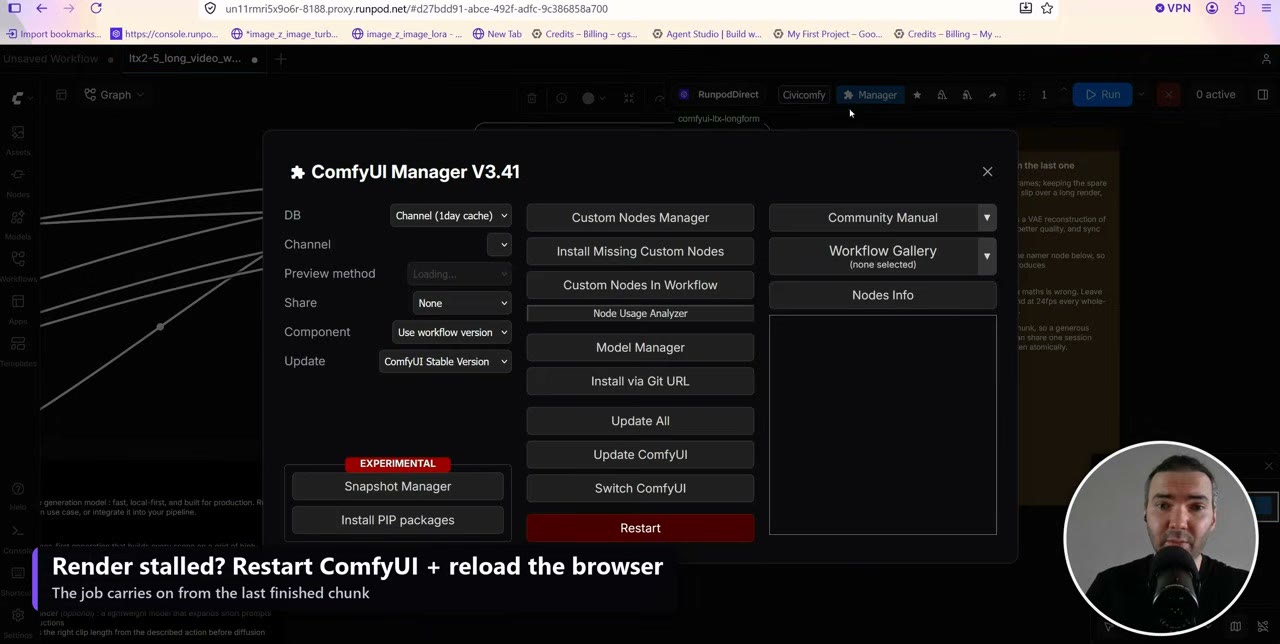
Renders longos às vezes param sem motivo visível. Comigo aconteceu entre duas e seis horas depois do início de um trabalho. A solução:
- Abra o Manager do ComfyUI e clique em Restart.
- Recarregue o ComfyUI no navegador.
- Enfileire de novo. Trechos prontos são pulados, então ele continua de onde parou.
A mesma retomada funciona no dia seguinte ou em outro pod: anexe o mesmo volume de rede e enfileire de novo.
Erros a evitar
- Resolução baixa demais. Abaixo de cerca de 0,9 megapixel, o movimento da boca é o primeiro a sofrer.
- Um arquivo enorme. Mantenha as locuções em cerca de 30 minutos por trabalho.
- Sem token do Hugging Face. O download funciona sem um, mas devagar.
- Desistir de um render travado. Reinicie, recarregue e enfileire de novo; nada se perde.
O link do template é um link de indicação do RunPod, assim como este: novas contas que se cadastram com o Google ganham de US$ 5 a US$ 500 em crédito após seus primeiros US$ 10, e eu recebo uma pequena comissão.
Assista à versão em vídeo (11:36)
Tudo o que está acima também está no vídeo, se você preferir acompanhar na tela. O vídeo está em inglês.
Perguntas frequentes
Qual a duração máxima de um vídeo de avatar falante com o LTX-2.5?
Uma geração do LTX-2.5 é limitada a cerca de 10–12 segundos, mas o fluxo corta sua locução em trechos e os une, então a entrada pode ter até cerca de 60 minutos. Para vídeos muito longos, divida o áudio em partes de cerca de 30 minutos.
Qual resolução devo usar para a sincronização labial do LTX-2.5?
Cerca de 0,9 megapixel. Abaixo de aproximadamente 700 × 700 a qualidade cai: os lábios começam a grudar e a boca quase não se mexe. Maior fica melhor, mas renderiza mais devagar.
De que GPU preciso?
Recomendo uma RTX 5090 com 32 GB de VRAM. O README do template lista placas de 48 GB como confortáveis e 24 GB como viáveis com os arquivos int8 que ele baixa, em resoluções moderadas.
Por que meu render longo para depois de algumas horas?
Aconteceu comigo entre duas e seis horas depois do início. Reinicie o ComfyUI pelo Manager, recarregue o navegador e enfileire de novo: o trabalho continua do último trecho concluído.

Anton Tenitsky é artista 3D com mais de 15 anos em computação gráfica, que trabalhou com Nickelodeon, Gameloft, Marvel Rivals e muitos outros clientes. Mais sobre mim