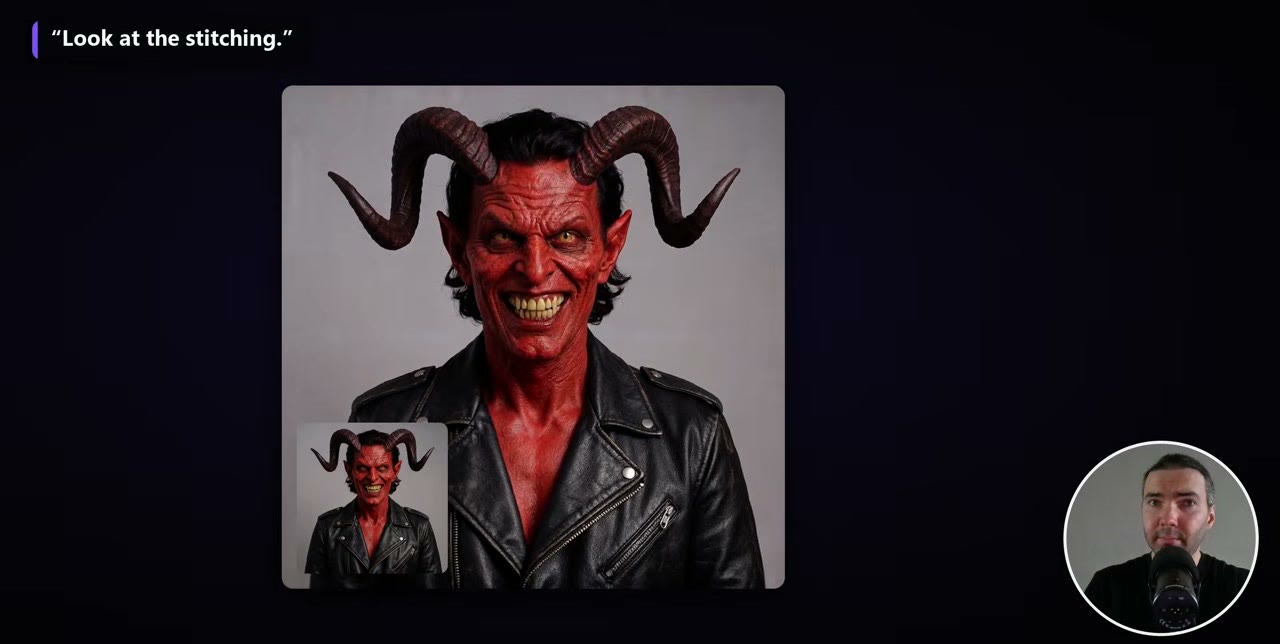
ステータス: RunPodで検証済み. このテンプレートをRunPodで長いアバター作業に使用し、複数のGPUで同時に動かしました。
このワークフローは、写真1枚とナレーションから、リップシンク付きのトーキングアバターを作り、動画が30秒でも50分でも最初から最後まで顔を同じに保ちます。ComfyUIがネイティブ対応しているLightricksの動画・音声モデルLTX-2.5を動かします。
すべてGitHubにあります。ワークフロー、小さなノードパック、セットアップスクリプトです。GPUがあれば無料でローカルで動かせます。セットアップスクリプトにダウンロードするモデルがすべて載っており、チャットボットにお使いのマシン用のインストールコマンドへ変換してもらえます。私は、1つのプロジェクトに5〜6枚のGPUを同時に使えるため、RunPodで動かしました。
ポイント
- 入力: ポートレート1枚と、最大約60分のナレーション。
- GPU: VRAM 32GBのRTX 5090をおすすめします。
- 解像度: 約0.9メガピクセルが最適です。これより低いと唇がくっつき始めます。
- 仕組み: 音声は無音の区切りで3〜12秒のチャンクに切られ、各チャンクはポートレートで始まりポートレートで終わり、スクリプトが元の音声とともにつなぎ合わせます。
- 長い作業は停止後に再開でき、同じPodでも別のPodでも構いません。
必要なもの
- ポートレート: 正面を向いた鮮明な写真。
- 最大約60分のナレーション。 それより長い場合は分割してください。その場合でも、1回は約30分にとどめます。RTX 5090で30分の動画をレンダリングするには数時間かかります。
- VRAM 32GBのGPU、またはRunPodのアカウント。
- 80GBのストレージ。 中核のモデルは約39GB、オプションのプロンプト強化と時間アップスケーラーを含めると約47GBです。
入力用のヒント: 新規のGoogle Cloudアカウントには300ドルの無料クレジットが付きます(これは紹介リンクではありません)。このデモのポートレートはGoogleの画像モデルNano Bananaで、ナレーションはGoogleの音声合成で、すべてそのクレジットで作りました。音声はとても安いので300ドルでかなりの量をまかなえますが、画像はもっとかかります。何千枚もの画像が必要なら、私のZ-Imageテンプレートのほうが安上がりです。
Podをセットアップする
RunPod入門で基本を説明しています。このテンプレート向けの手順は次のとおりです。
- GPUが豊富なデータセンターに、約100GBのネットワークボリュームを作成します。後から大きくでき、存在する間は時間単位で課金され、このサイズで標準ストレージなら月約7ドルです。
- テンプレートをデプロイします。テンプレートのリンクを開くか、公開テンプレートから「LTX 2.5 consistent avatar」を検索します。ボリュームを接続します。
- GPUを選びます。 RTX 5090をおすすめします。RTX 4500でも動きますが、遅いです。
- モデルのダウンロード中、初回起動を10〜15分待ちます。同じボリュームでの2回目以降の起動ははるかに速くなります。
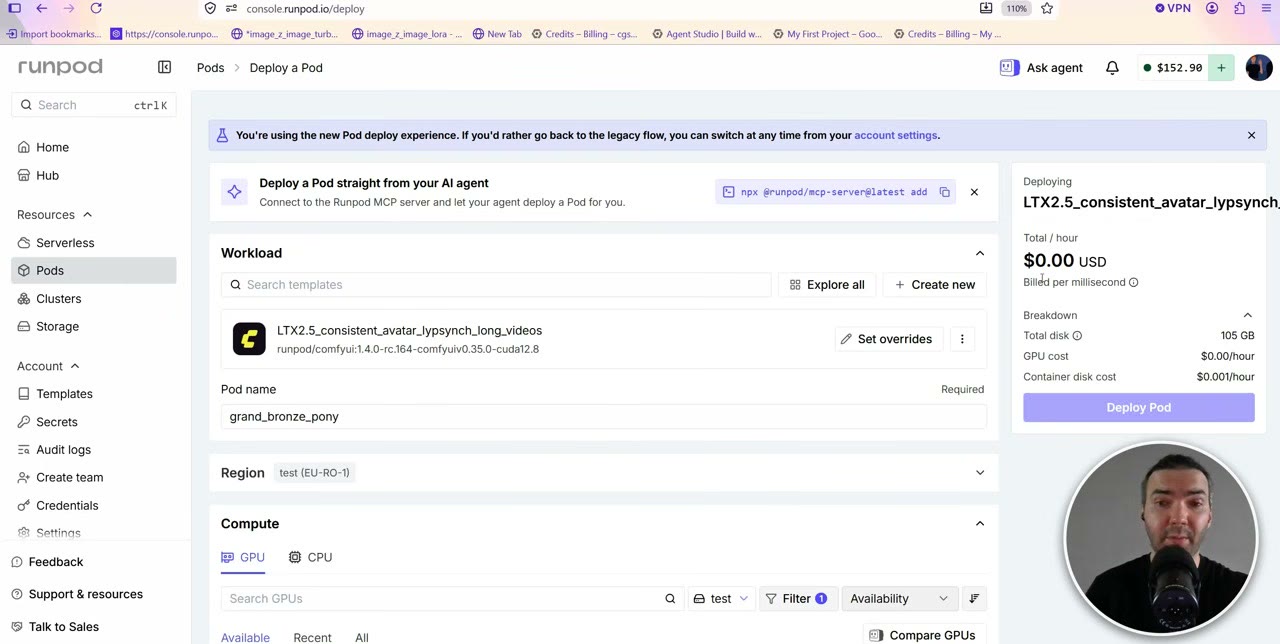
任意ですが推奨: Hugging Face上の公式LTX-2.5の重みは、ライセンスの承諾が必要です。モデルページでライセンスに同意し、Hugging Faceの設定で読み取りトークンを作成して、環境変数HF_TOKENとしてPodに追加してください。なくても、テンプレートは公開ミラーにフォールバックしますが、匿名のダウンロードは速度が制限され、40GB以上のダウンロードが極端に遅くなることがあります。
準備ができると、Podの接続メニューにComfyUIとJupyterLabが表示されます。JupyterLabはすでに動いているのに「initializing」と表示されることがあるので、そのまま開いてください。
ワークフロー
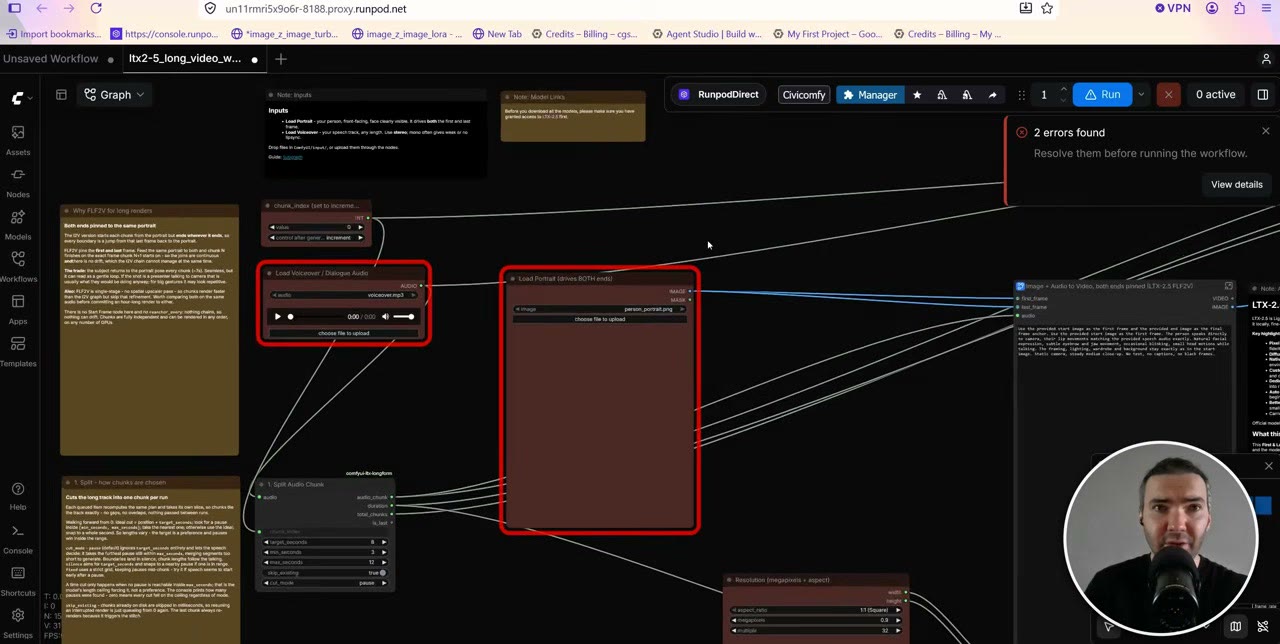
テンプレートは、ComfyUIのWorkflowsサイドバーにltx2-5_long_video_workflowというワークフローを1つインストールします。表面上はシンプルで、仕組みはダブルクリックで開けるサブグラフの中にあります。そこには触る必要がありません。設定するのは、赤で囲まれたノードです。
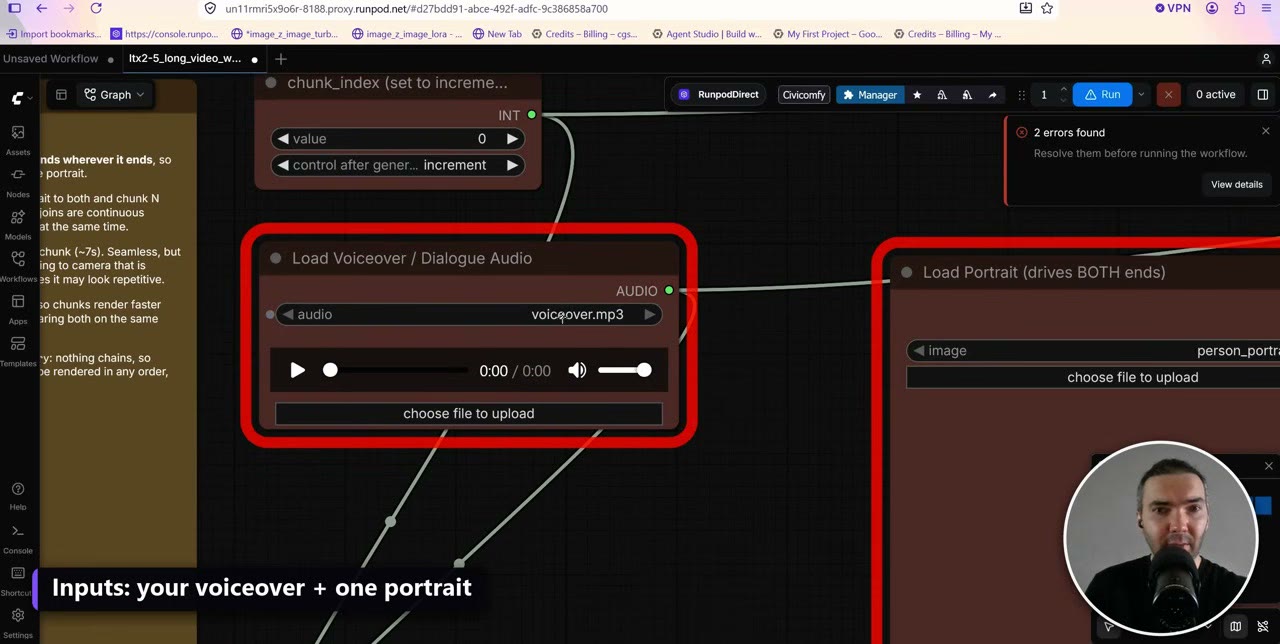
1. 入力
ナレーションとポートレートを、2つの赤い入力ノードに読み込みます。JupyterLabで新しいファイルをアップロードした後は、ドロップダウンに表示されるようにComfyUIを再読み込みしてください。
2. プロンプト
ワークフローには、中立的なトーキングヘッドのプロンプトが付属しています。人物が話してカメラを見て、不自然な動きをしないというものです。独自に書くこともできますが、プレゼンター風の動画ならデフォルトで機能します。
3. 解像度
解像度ノードは、アスペクト比とともにメガピクセルで動作します。私は主に0.9メガピクセルの正方形をレンダリングしました。常にワイドスクリーンでレンダリングするなら、一度変更してワークフローを保存するか、メガピクセルのオプションをオフにして正確な寸法を入力します。
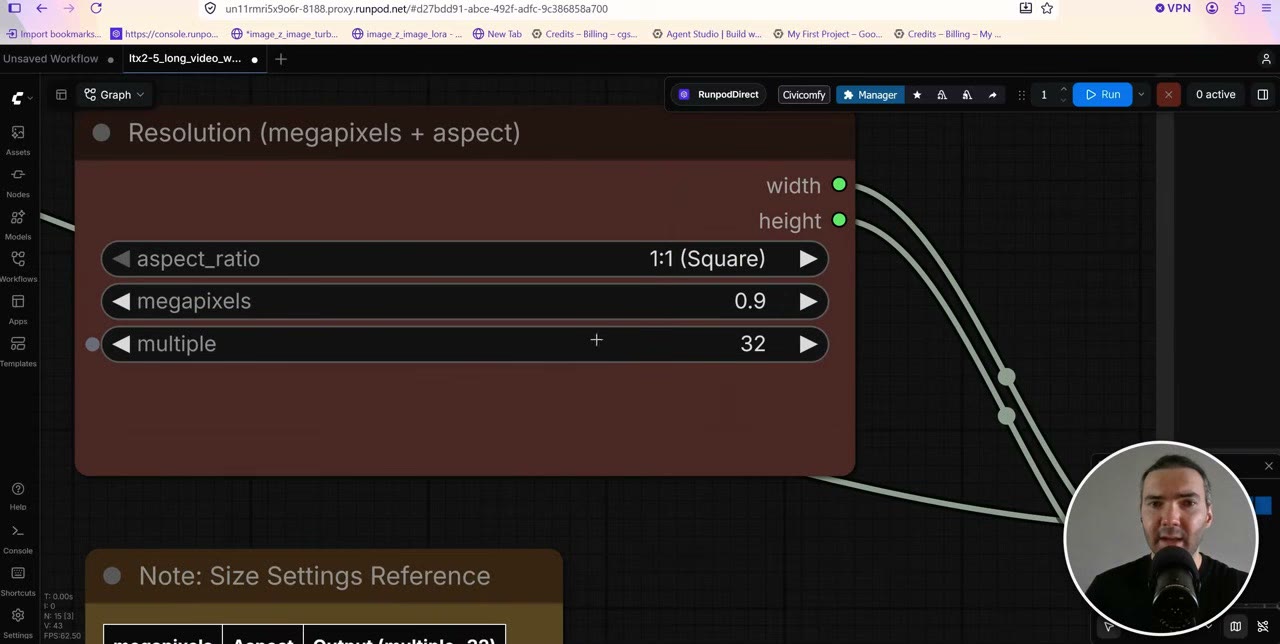
解像度は、何よりも口に影響します。500 × 500前後、さらには600や700ピクセル四方でも、特定の形で品質が落ちます。唇がくっついて口がほとんど動かなくなるのです。私にとっては0.9メガピクセルが最適で、高くするとさらに良くなりますが、時間がかかります。
顔の一貫性を保つ仕組み
LTX-2.5が一度に生成できるのは約10〜12秒だけです。それ以上は、乱れが出てきます。そこでワークフローは3つのことを行います。
最初と最後のフレームは常にあなたのポートレートです。 すべてのチャンクが、同じ画像と同じ中立の表情で始まり、終わります。アバターは話し、中立に戻り、また話し始めるので、プレゼンターとして自然に見えます。両端が固定されているので、長い動画でも顔がずれません。(最後のフレームを変えることもできますが、それは映画を作ることになり、別の仕事です。)
音声は無音の区切りで切られます。 Split Audio Chunkノードは音声中の間を探してそこで切り、目標は8秒、3秒より短くも12秒より長くもしません。2つの間のあいだの7秒の区間は、7秒のチャンクになります。
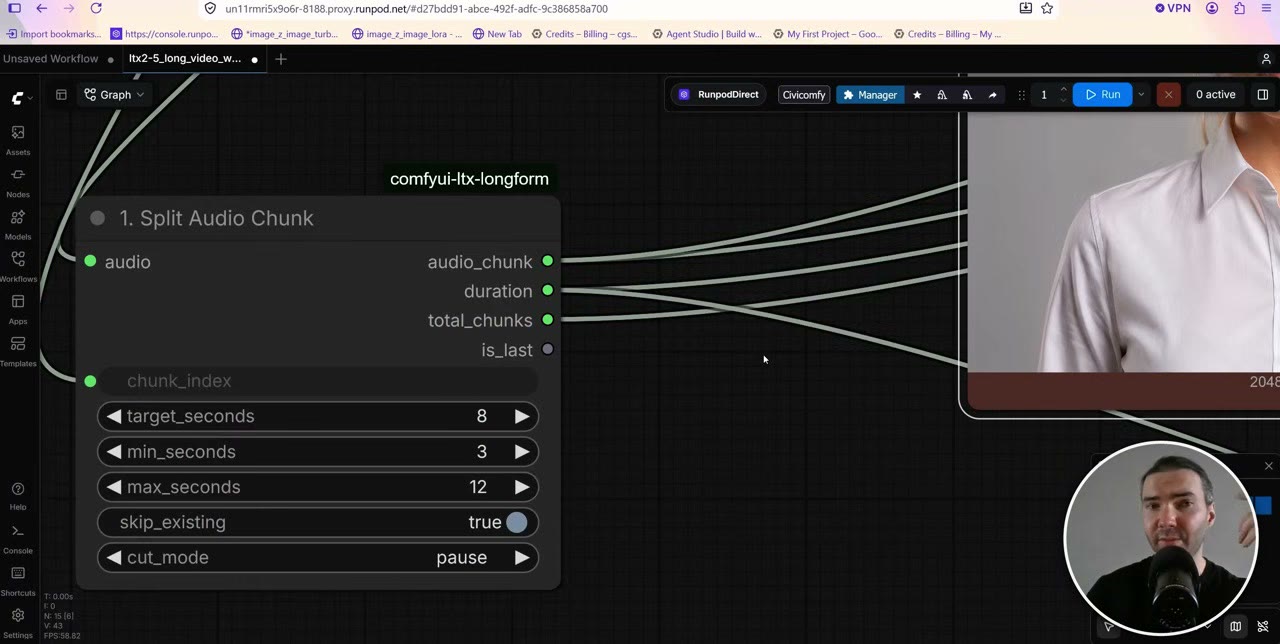
スクリプトがつなぎ直します。 ワークフローの「image」出力は紛らわしく、結果は動画です。テンプレートに同梱された結合スクリプトがチャンクをつなぎ、LTXが各チャンクに加える余分な1フレームを取り除き(そうしないと7分で音声が約2秒ずれます)、モデルによる再構成ではなく元の音声を結果に重ねます。
知っておくべきアーティファクトが1つあります。つなぎ目ごとにノイズパターンがわずかに変わるのです。探せば見えます。プレゼンター動画なら許容できましたが、MiniMax H3が主に改善した点でもあります。
出力とファイル名
すべてはComfyUIのoutputフォルダに入ります。チャンクのフォルダと完成した動画です。デフォルトでは、音声ファイルの名前がプロジェクトフォルダ名と最終動画の名前の両方になるので、avatar-female-2.mp3ならavatar-female-2のチャンクフォルダと、対応する最終動画ができます。100個のファイルをレンダリングするときには、番号付きセッションよりずっと楽です。セッションに自分で名前を付けたい場合は、名前の入力を切り離してセッション名を入力します。
実行する、そして止まったときの対処
**Run (Instant)**でキューに入れ、コンソールを開いたままにします。チャンクの数と、いま何番目かが表示されます。最初のチャンクは、モデルを読み込むため時間がかかります。
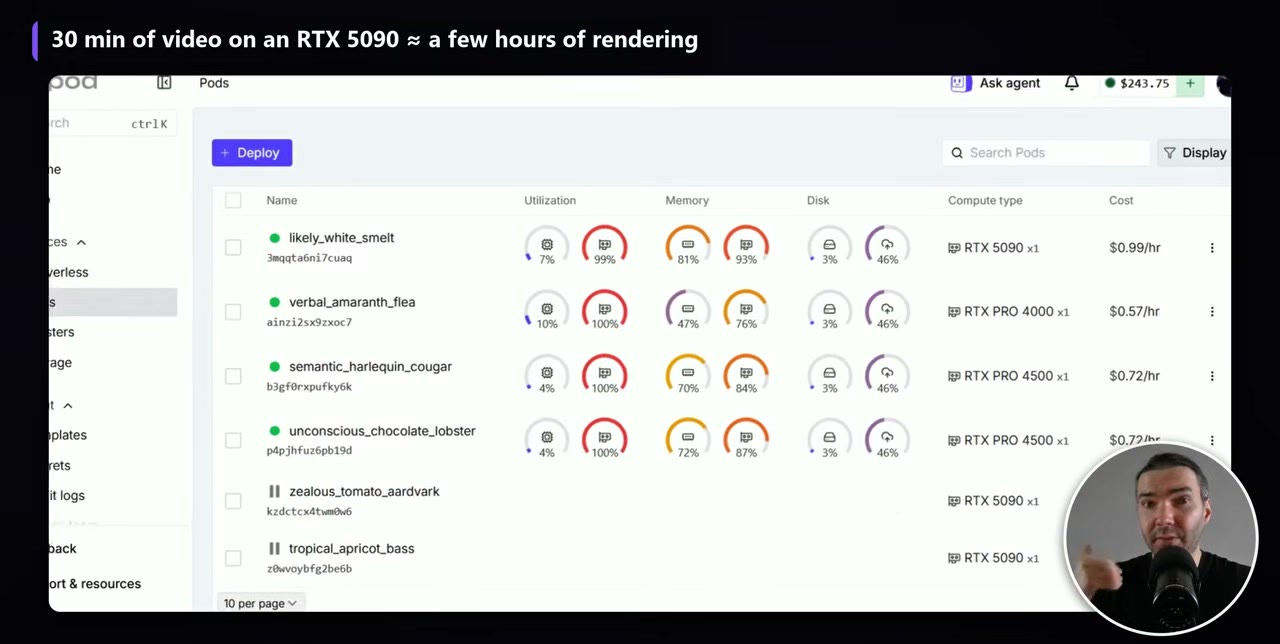
長いレンダリングは、目に見える理由なく止まることがあります。私の場合は、作業開始から2時間から6時間のあいだで起きました。対処法は次のとおりです。
- ComfyUIのManagerを開き、Restartをクリックします。
- ブラウザでComfyUIを再読み込みします。
- もう一度キューに入れます。完了したチャンクはスキップされるので、止まったところから続行されます。
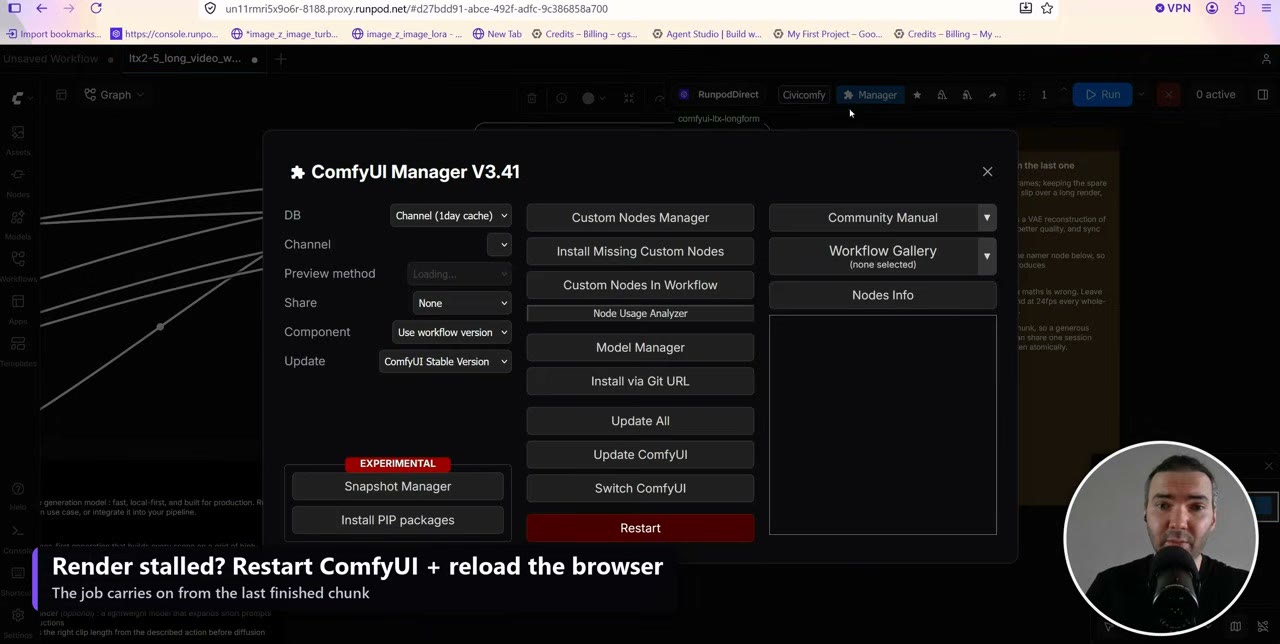
同じ再開は翌日や別のPodでも機能します。同じネットワークボリュームを接続して、もう一度キューに入れてください。
避けたい失敗
- 解像度が低すぎる。 約0.9メガピクセルを下回ると、まず口の動きが悪くなります。
- 1つの巨大なファイル。 ナレーションは、1回の作業あたり約30分にとどめてください。
- Hugging Faceトークンがない。 ダウンロードはできますが、遅くなります。
- 止まったレンダリングを諦める。 再起動、再読み込み、再キューで、何も失われません。
テンプレートのリンクはRunPodの紹介リンクで、こちらも同様です。Googleでサインアップした新規アカウントは最初の10ドルの利用後に5〜500ドル分のクレジットを受け取れ、私には少額の紹介報酬が入ります。
動画版を見る (11:36)
上の内容はすべて動画でも説明しています。画面を見ながら進めたい方はこちらをどうぞ。 動画は英語です。
よくある質問
LTX-2.5のトーキングアバター動画はどのくらいの長さにできますか?
LTX-2.5の1回の生成は約10〜12秒が上限ですが、ワークフローがナレーションをチャンクに切ってつなぐので、入力は約60分まで可能です。非常に長い動画は、音声を約30分ごとに分けてください。
LTX-2.5のリップシンクにはどの解像度を使うべきですか?
約0.9メガピクセルです。およそ700 × 700を下回ると品質が落ち、唇がくっついて口がほとんど動かなくなります。高いほど見栄えは良くなりますが、レンダリングは遅くなります。
必要なGPUは何ですか?
VRAM 32GBのRTX 5090をおすすめします。テンプレートのREADMEでは、48GBのカードなら余裕があり、24GBでも、ダウンロードされるint8ファイルと控えめな解像度なら動くとされています。
長いレンダリングが数時間後に止まるのはなぜですか?
私の場合、2時間から6時間のあいだで起きました。ManagerからComfyUIを再起動し、ブラウザを再読み込みして、もう一度キューに入れてください。作業は最後に完了したチャンクから続行されます。

Anton Tenitsky は コンピュータグラフィックスで15年以上の経験を持つ3Dアーティストで、Nickelodeon、Gameloft、Marvel Rivalsをはじめ多くのクライアントと仕事をしてきました。 プロフィールを見る