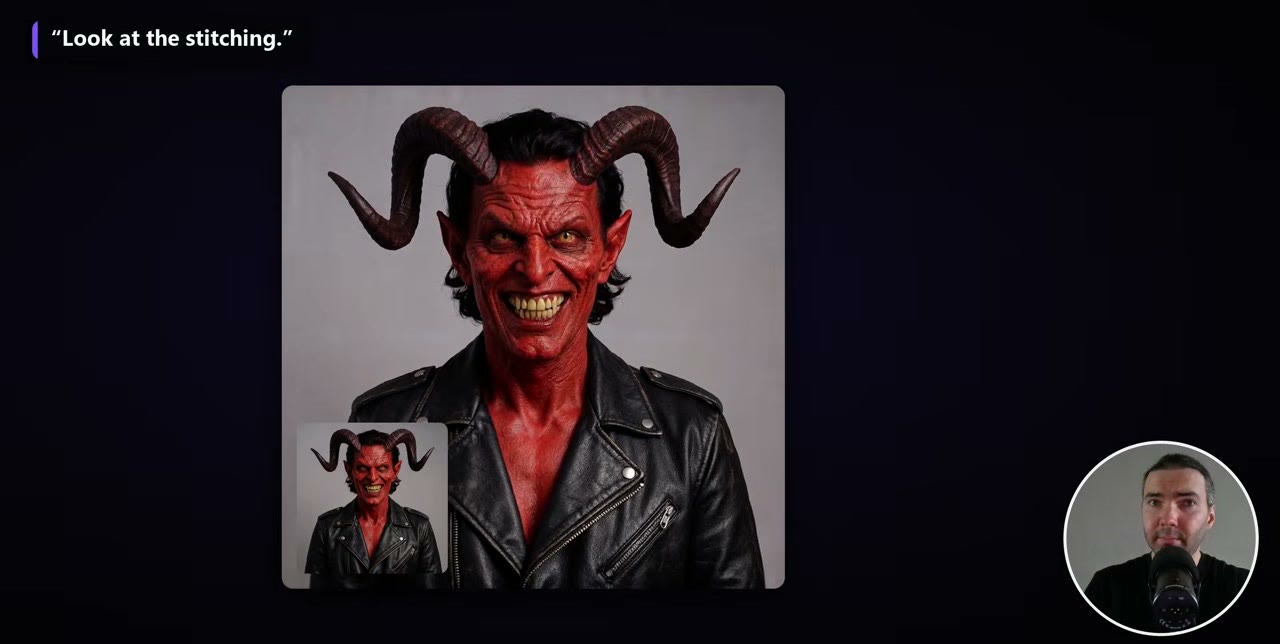
Estado: Probada en RunPod. Usé esta plantilla en RunPod para trabajos largos de avatares, ejecutándola en varias GPU a la vez.
Este flujo convierte una foto y una locución en un avatar hablante con sincronización labial, y mantiene el mismo rostro de principio a fin, tanto si el vídeo dura 30 segundos como 50 minutos. Ejecuta LTX-2.5, el modelo de vídeo y audio de Lightricks, que ComfyUI admite de forma nativa.
Todo está en GitHub: el flujo, un pequeño paquete de nodos y el script de instalación. Puedes ejecutarlo en local gratis si tienes la GPU; el script de instalación enumera todos los modelos que hay que descargar, y un chatbot puede convertirlo en comandos de instalación para tu máquina. Yo lo ejecuté en RunPod porque podía poner cinco o seis GPU a la vez en un mismo proyecto.
En resumen
- Entrada: un retrato y una locución de hasta unos 60 minutos.
- GPU: recomiendo una RTX 5090 (32 GB).
- Resolución: unos 0,9 megapíxeles es el punto óptimo. Más baja y los labios empiezan a pegarse.
- Cómo funciona: el audio se corta en las pausas en trozos de 3 a 12 segundos; cada trozo empieza y termina en tu retrato; un script los une con tu audio original.
- Los trabajos largos se reanudan tras una parada, en el mismo pod o en otro.
Qué necesitas
- Un retrato: una foto clara y de frente.
- Una locución de hasta unos 60 minutos. Si es más larga, divídela. Incluso entonces, yo mantendría las partes en unos 30 minutos: 30 minutos de vídeo tardan unas horas en renderizarse en una RTX 5090.
- Una GPU con 32 GB de VRAM, o una cuenta de RunPod.
- 80 GB de almacenamiento. Los modelos principales ocupan unos 39 GB, o unos 47 GB con el potenciador de prompts y el escalador temporal opcionales.
Un consejo para las entradas: las cuentas nuevas de Google Cloud reciben 300 $ en créditos gratuitos (no es un enlace de referido). El retrato de esta demostración lo hice con el modelo de imágenes Nano Banana de Google y la locución con el texto a voz de Google, todo con esos créditos. La voz es tan barata que 300 $ dan para una cantidad enorme; las imágenes cuestan más. Para miles de imágenes, mi plantilla de Z-Image es la vía más barata.
Prepara el pod
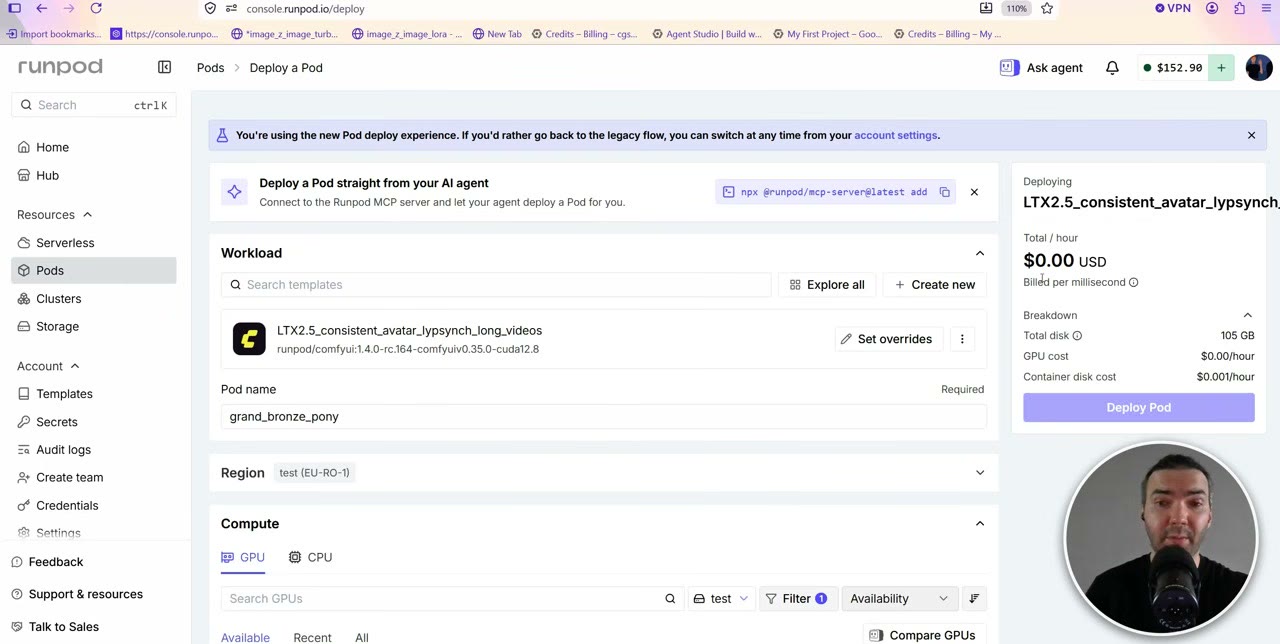
Mi introducción a RunPod explica lo básico. Para esta plantilla:
- Crea un volumen de red de unos 100 GB en un centro de datos con muchas GPU. Puedes ampliarlo después, y se factura por horas mientras existe, unos 7 $ al mes con ese tamaño en almacenamiento estándar.
- Despliega la plantilla. Abre el enlace de la plantilla, o busca en las plantillas públicas «LTX 2.5 consistent avatar». Conecta tu volumen.
- Elige una GPU. Recomiendo una RTX 5090. Una RTX 4500 funciona pero es lenta.
- Espera al primer arranque, de 10 a 15 minutos mientras descarga los modelos. Los arranques posteriores con el mismo volumen son mucho más rápidos.
Opcional pero recomendado: los pesos oficiales de LTX-2.5 en Hugging Face están protegidos por licencia. Acepta la licencia en la página del modelo, crea un token de lectura en tus ajustes de Hugging Face y añádelo al pod como la variable de entorno HF_TOKEN. Sin él, la plantilla recurre a un espejo público, pero las descargas anónimas tienen límite de velocidad y la descarga de más de 40 GB puede volverse lentísima.
Cuando está listo, el menú Connect del pod muestra ComfyUI y JupyterLab. JupyterLab a veces dice «initializing» cuando ya funciona, así que simplemente ábrelo.
El flujo
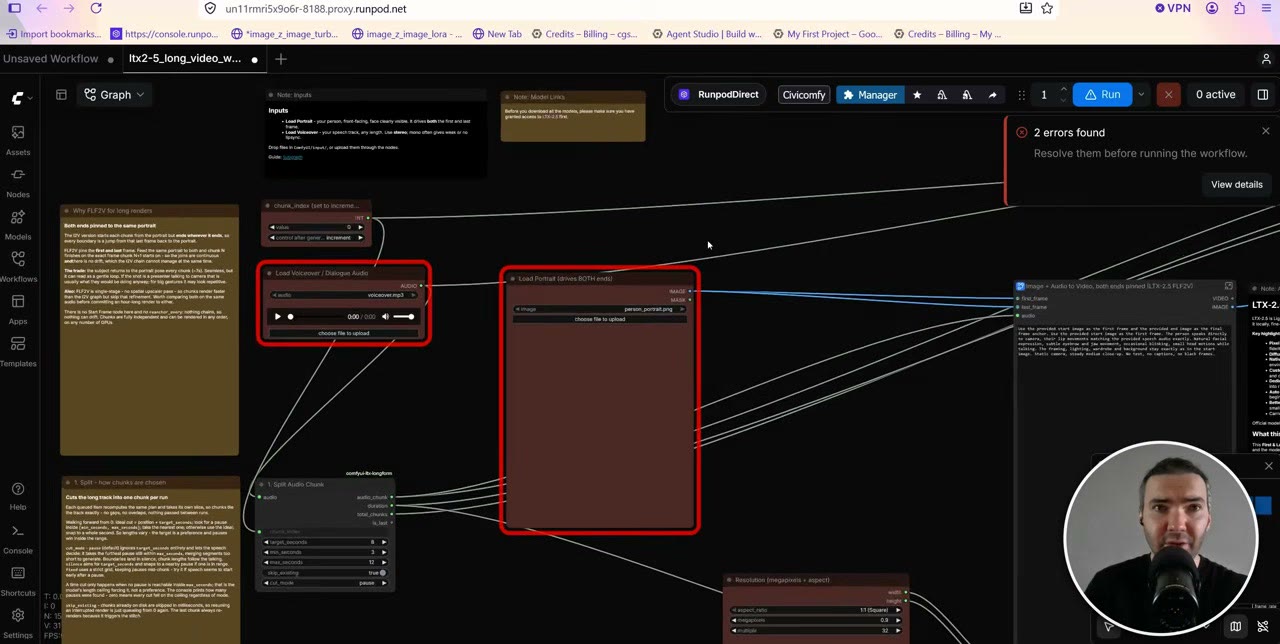
La plantilla instala un flujo en la barra lateral Workflows de ComfyUI: ltx2-5_long_video_workflow. A simple vista parece sencillo; la mecánica está dentro de un subgrafo que puedes abrir haciendo doble clic. No necesitas tocarlo. Los nodos que ajustas son los marcados con rojo.
1. Entradas
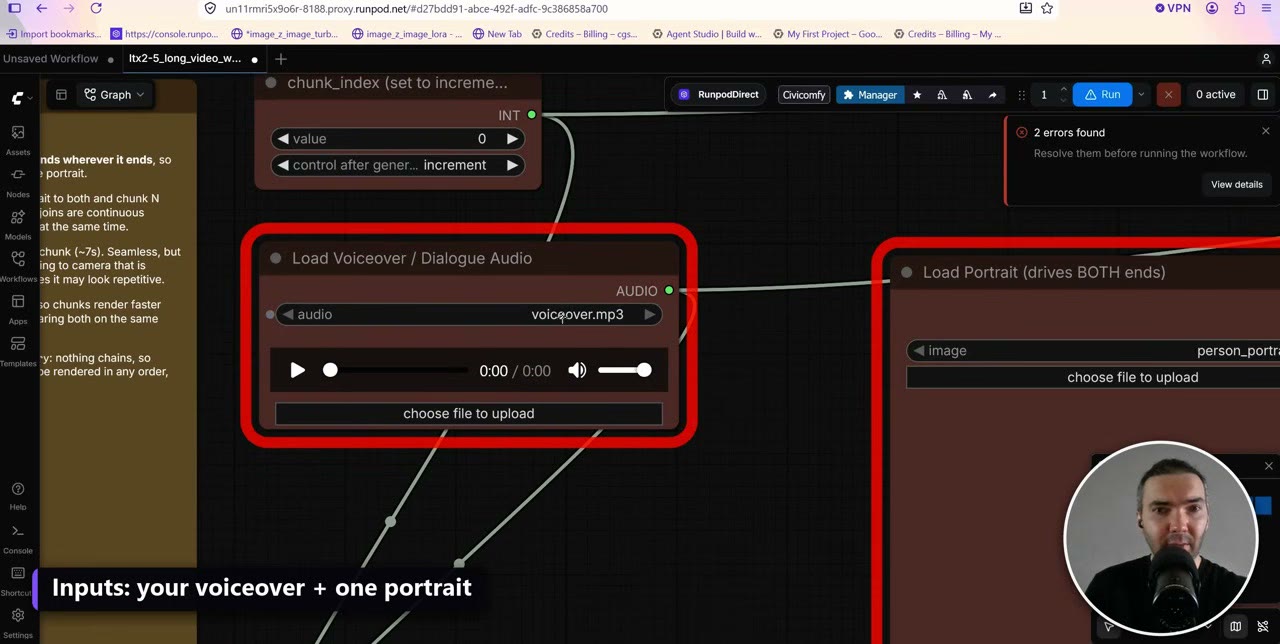
Carga tu locución y tu retrato en los dos nodos de entrada rojos. Después de subir un archivo nuevo con JupyterLab, recarga ComfyUI para que aparezca en los menús desplegables.
2. Prompt
El flujo trae un prompt neutro de persona hablando a cámara: la persona habla y mira a la cámara sin movimientos extraños. Puedes escribir el tuyo, pero el de por defecto sirve para vídeos de estilo presentador.
3. Resolución
El nodo de resolución trabaja en megapíxeles, con una relación de aspecto. Yo renderizaba sobre todo cuadrados a 0,9 megapíxeles. Si siempre renderizas en panorámico, cámbialo una vez y guarda el flujo, o desactiva la opción de megapíxeles y escribe las dimensiones exactas.
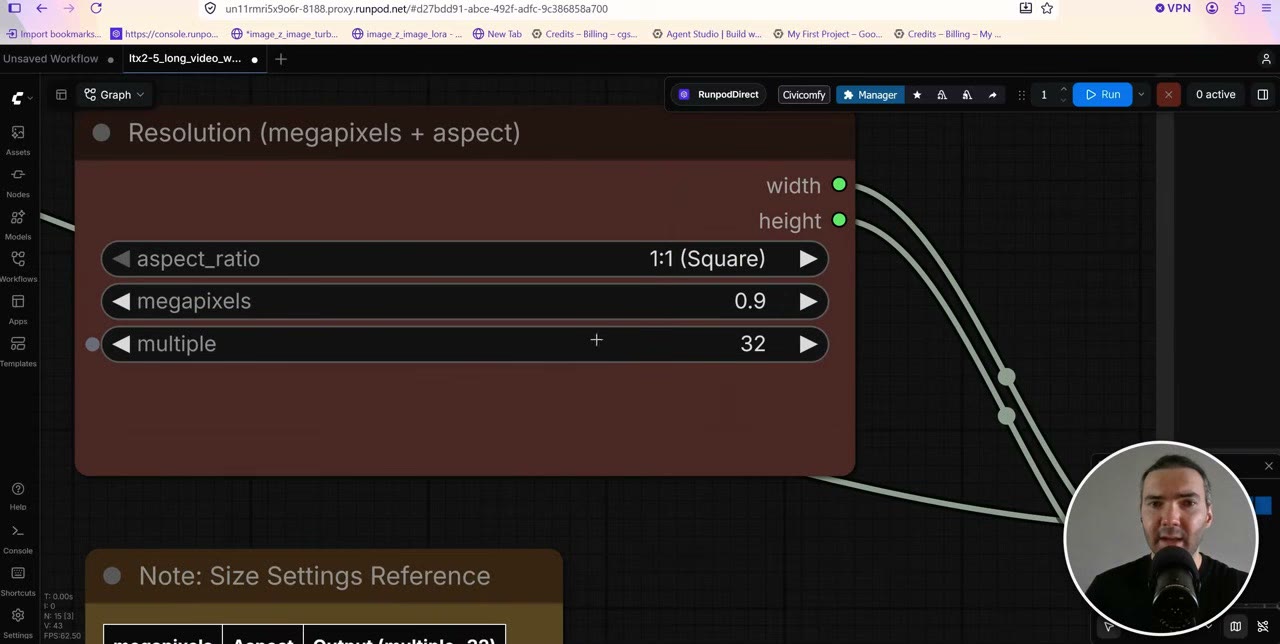
La resolución afecta a la boca más que ninguna otra cosa. Alrededor de 500 × 500, e incluso a 600 o 700 píxeles de lado, la calidad baja de una forma concreta: los labios se pegan y la boca apenas se mueve. 0,9 megapíxeles es el punto óptimo para mí. Más alta se ve aún mejor, pero tarda más.
Cómo mantiene la coherencia del rostro
LTX-2.5 solo puede generar unos 10–12 segundos de una vez. Si lo fuerzas más, se desvía y aparecen fallos. Por eso el flujo hace tres cosas.
El primer y el último fotograma son siempre tu retrato. Cada trozo empieza y termina en la misma imagen, con la misma expresión neutra. El avatar habla, vuelve a la posición neutra y empieza otra vez, lo que resulta natural en un presentador. Como ambos extremos están fijos, el rostro no puede desviarse en un vídeo largo. (Es posible usar últimos fotogramas distintos, pero entonces estás haciendo una película, que es otro trabajo.)
El audio se corta en las pausas. El nodo Split Audio Chunk busca huecos en el habla y corta ahí, con un objetivo de 8 segundos, nunca menos de 3 ni más de 12. Un tramo de 7 segundos entre dos pausas se convierte en un trozo de 7 segundos.
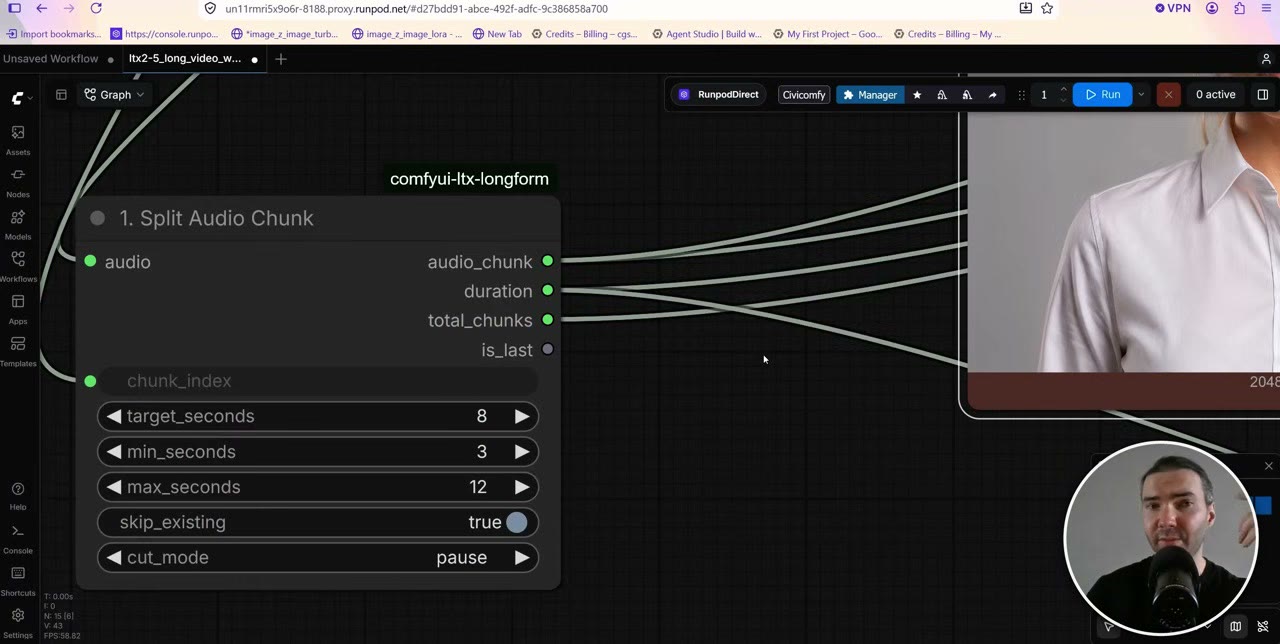
Un script lo une todo de nuevo. La salida «image» del flujo es engañosa: el resultado es un vídeo. Un script de unión que viene con la plantilla une los trozos, recorta el fotograma extra que LTX añade a cada uno (si no, el audio se desfasa unos 2 segundos a lo largo de 7 minutos) y coloca tu audio original sobre el resultado en lugar de la reconstrucción que hace el modelo.
Hay un defecto que conviene conocer: en cada unión, el patrón de ruido cambia ligeramente. Se nota si lo buscas. A mí me bastó con convivir con ello en vídeos de presentador, pero es lo principal que MiniMax H3 mejoró.
Salida y nombres de archivo
Todo acaba en la carpeta output de ComfyUI: una carpeta de trozos y el vídeo terminado. Por defecto, el nombre de tu archivo de audio pasa a ser tanto la carpeta del proyecto como el nombre del vídeo final, así que avatar-female-2.mp3 te da una carpeta de trozos avatar-female-2 y un vídeo final con el mismo nombre. Cuando renderizas cien archivos, eso es mucho más fácil que las sesiones numeradas. Si prefieres poner nombre a las sesiones tú mismo, desconecta la entrada de nombre y escribe un nombre de sesión.
Ejecútalo, y qué hacer cuando se atasca
Pon en cola con Run (Instant) y deja la consola abierta: indica cuántos trozos hay y en cuál va. El primer trozo tarda más mientras se cargan los modelos.
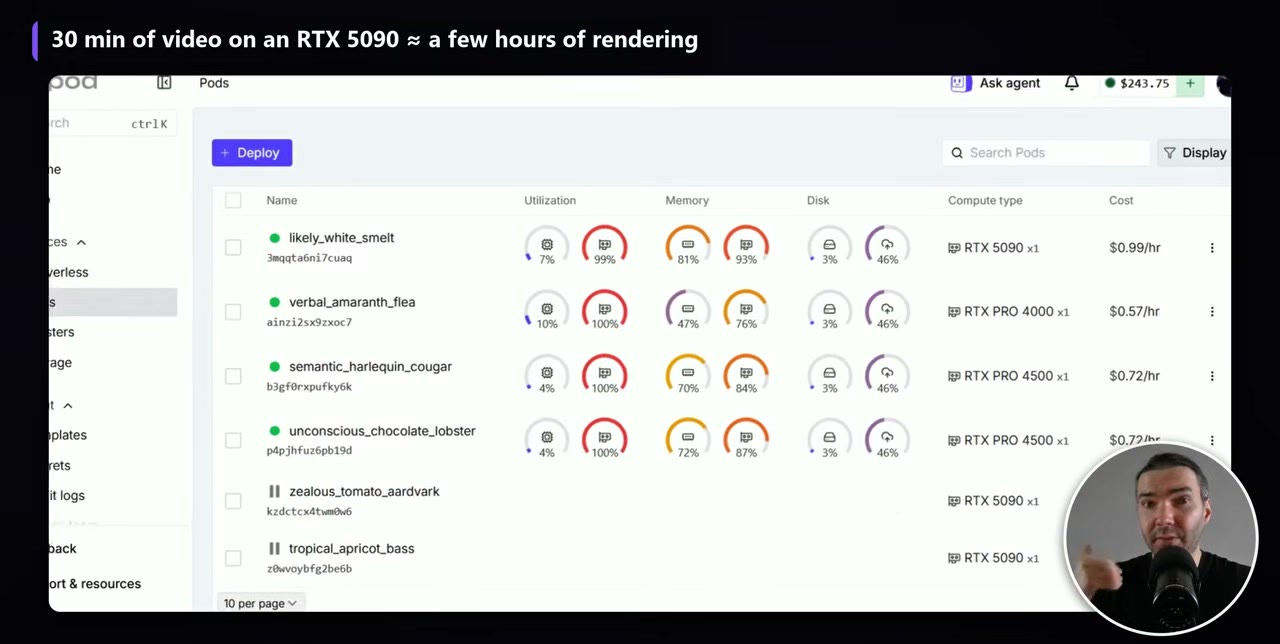
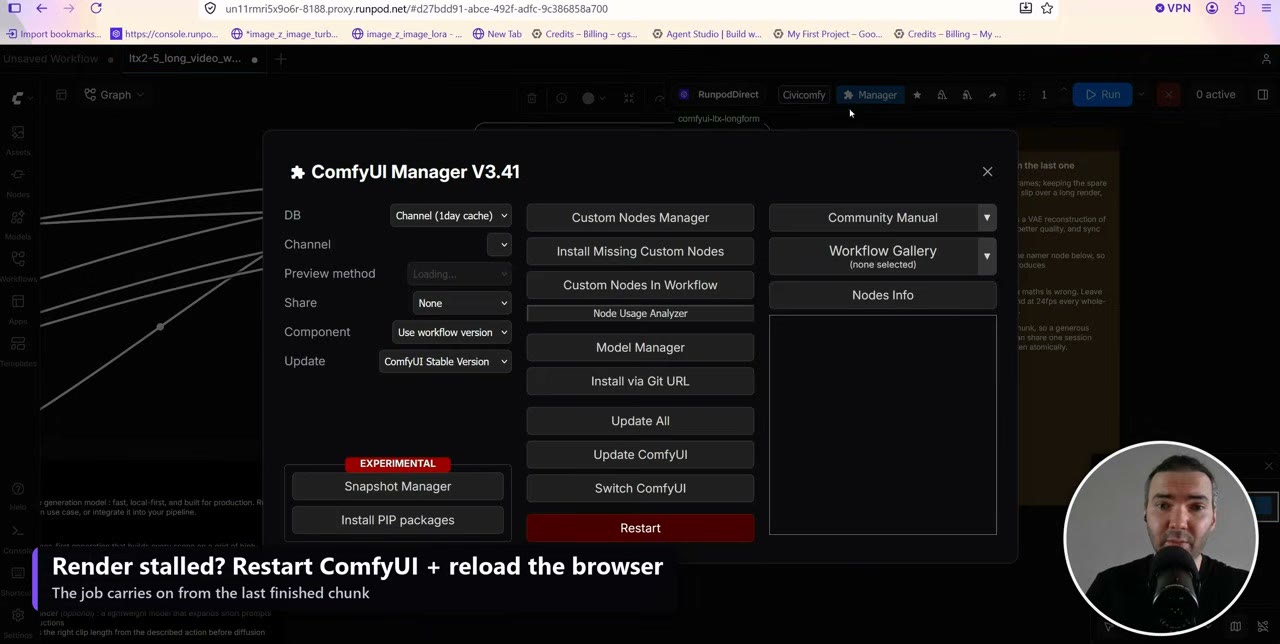
Los renders largos a veces se detienen sin motivo aparente. A mí me pasó entre dos y seis horas después de empezar un trabajo. La solución:
- Abre el Manager de ComfyUI y haz clic en Restart.
- Recarga ComfyUI en el navegador.
- Vuelve a poner en cola. Los trozos terminados se saltan, así que continúa donde se quedó.
La misma reanudación funciona al día siguiente o en otro pod: conecta el mismo volumen de red y vuelve a poner en cola.
Errores que evitar
- Resolución demasiado baja. Por debajo de unos 0,9 megapíxeles, lo primero que sufre es el movimiento de la boca.
- Un solo archivo enorme. Mantén las locuciones en unos 30 minutos por trabajo.
- Sin token de Hugging Face. La descarga funciona sin él, pero despacio.
- Rendirte con un render atascado. Reinicia, recarga y vuelve a poner en cola; no se pierde nada.
El enlace de la plantilla es un enlace de referido de RunPod, igual que este: las cuentas nuevas que se registran con Google reciben entre 5 y 500 $ de crédito después de su primer gasto de 10 $, y yo recibo una pequeña comisión.
Ver la versión en vídeo (11:36)
Todo lo anterior también está en el vídeo, si prefieres seguirlo en pantalla. El vídeo está en inglés.
Preguntas frecuentes
¿Cuánto puede durar un vídeo de avatar hablante con LTX-2.5?
Una generación de LTX-2.5 está limitada a unos 10–12 segundos, pero el flujo corta tu locución en trozos y los une, así que la entrada puede durar hasta unos 60 minutos. Para vídeos muy largos, divide el audio en partes de unos 30 minutos.
¿Qué resolución debo usar para la sincronización labial de LTX-2.5?
Unos 0,9 megapíxeles. Por debajo de unos 700 × 700 la calidad baja: los labios empiezan a pegarse y la boca apenas se mueve. Más alta se ve mejor, pero renderiza más despacio.
¿Qué GPU necesito?
Recomiendo una RTX 5090 con 32 GB de VRAM. El README de la plantilla indica que las tarjetas de 48 GB son cómodas y que 24 GB es viable con los archivos int8 que descarga, a resoluciones moderadas.
¿Por qué mi render largo se detiene después de unas horas?
Me pasó entre dos y seis horas después de empezar. Reinicia ComfyUI desde el Manager, recarga el navegador y vuelve a poner en cola: el trabajo continúa desde el último trozo terminado.

Anton Tenitsky es artista 3D con más de 15 años en gráficos por ordenador, que ha trabajado con Nickelodeon, Gameloft, Marvel Rivals y muchos otros clientes. Más sobre mí